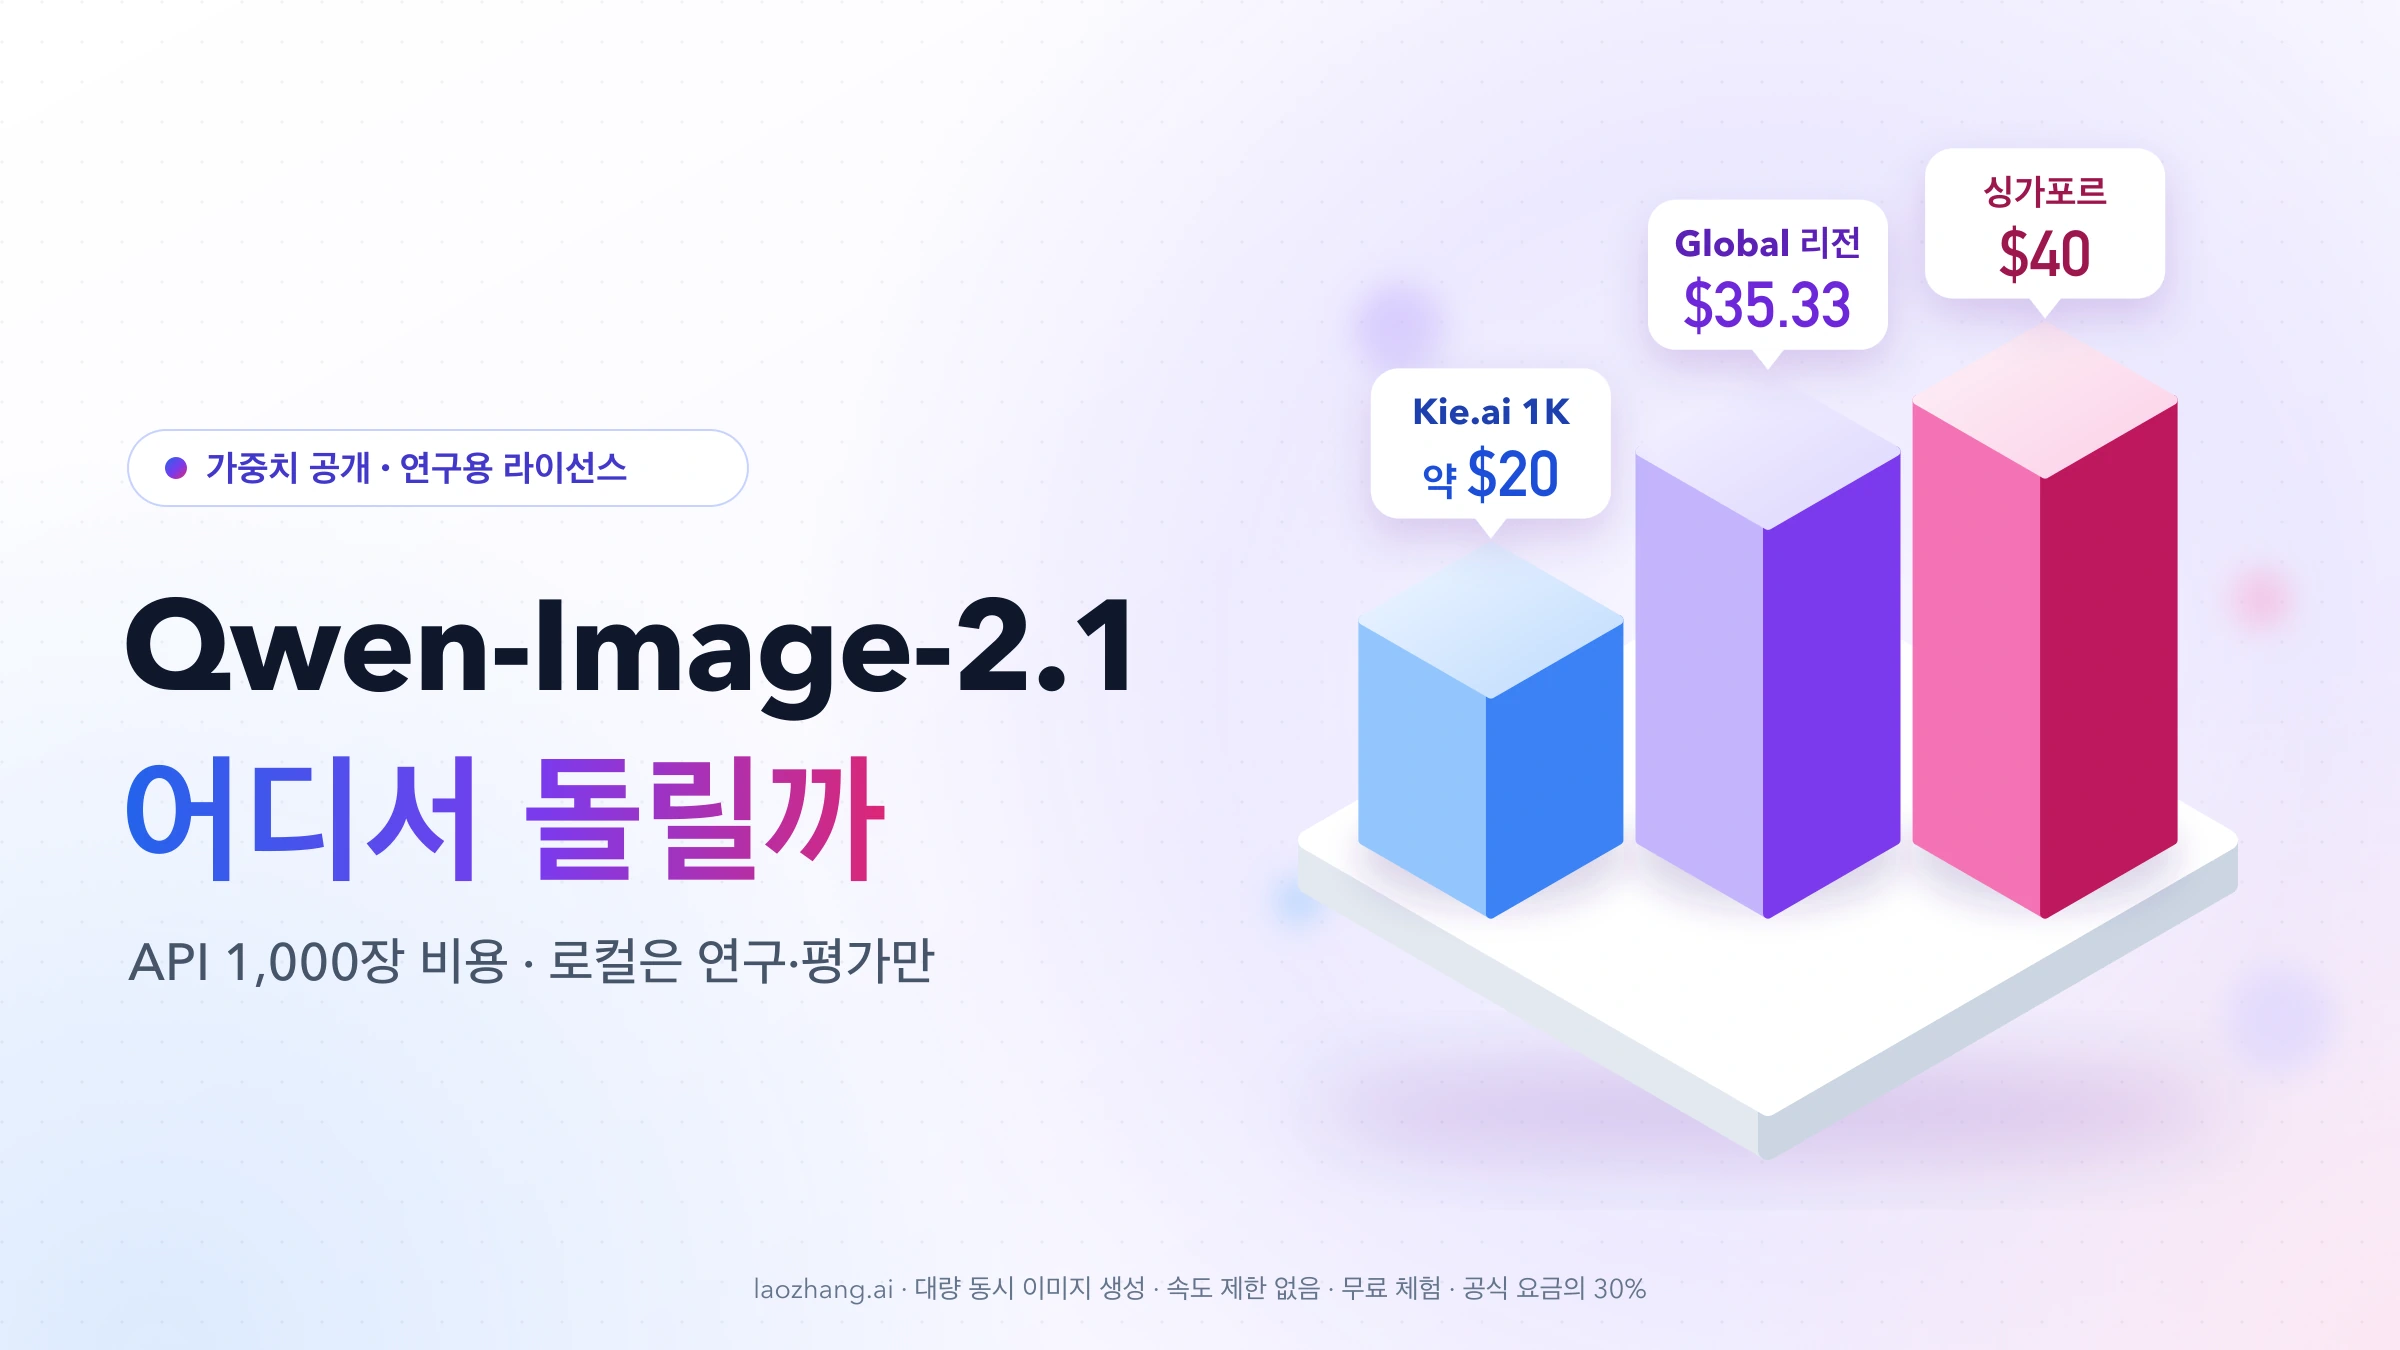
Qwen-Image-2.1은 알리바바 Qwen 팀이 2026년 9월 20일 GitHub과 Hugging Face에 가중치를 공개한 이미지 생성·편집 통합 모델입니다. 누구나 내려받아 내 PC에서 무료로 돌릴 수 있지만, 라이선스는 Apache 2.0 같은 오픈소스 라이선스가 아니라 Qwen Research License입니다. 허용 범위는 "연구 또는 평가 목적"이고, 상업적 이용은 Qwen 측에 별도 라이선스를 신청해야 합니다.
목적에 따라 시작점은 이렇게 갈립니다.
- 일단 결과물만 보고 싶다면: Hugging Face의 공식 데모 Space에서 바로 생성해 볼 수 있습니다. 무료지만 사용 한도는 공개되어 있지 않습니다.
- 내 GPU나 Mac에서 돌리려면: ComfyUI 네이티브 워크플로나 Unsloth 양자화 파일을 씁니다. Unsloth 문서의 추정치로는 VRAM 12~16GB에서 GGUF Q4_K_M, 1024×1024가 출발점이고, 6GB도 FP8과 오프로딩으로 돌아갑니다.
- 서비스에 API로 붙이려면: 알리바바 클라우드 Model Studio의
qwen-image-2.1-pro가 가격표상 2026년 10월 7일 기준 싱가포르 리전 장당 $0.04입니다. 1,000장이면 1,000 × $0.04 = $40입니다. - 클라이언트 납품·광고·판매용이라면: 로컬 실행으로는 해결되지 않습니다. 상업 라이선스를 신청하거나, 유료 API를 쓸 경우 알리바바 클라우드 약관에서 출력물 권리를 직접 확인해야 합니다.
Qwen-Image-2.1 쓰는 방법 비교: 무료 데모, 로컬 실행, 유료 API
어디서 돌리느냐에 따라 비용보다 먼저 달라지는 것이 사용 조건입니다. 아래 표의 가격과 조건은 2026년 10월 7일 기준입니다.
| 경로 | 비용 | 필요한 것 | 상업적 이용 |
|---|---|---|---|
| Hugging Face 공식 데모 | 무료(ZeroGPU, 한도 비공개) | 브라우저 | 연구·평가 용도(가중치 라이선스 기준) |
| Model Studio 콘솔 체험 | 무료 체험 | 알리바바 클라우드 계정 | 불가. 성능 평가 용도로만 사용 가능 |
| 로컬 실행(ComfyUI, Unsloth, Diffusers) | 장비·전기 비용 | VRAM 6GB 이상 GPU 또는 통합 메모리 12~16GB 이상 Mac | 연구·평가만. 상업은 별도 라이선스 |
Model Studio API qwen-image-2.1-pro | 장당 $0.04(싱가포르), $0.035333(베이징·홍콩·프랑크푸르트·버지니아·도쿄) | API 키 | 알리바바 클라우드 서비스 약관 적용. 상업 권리는 약관에서 직접 확인 |
| Kie.ai 등 서드파티 API | 1K 약 $0.02, 2K 약 $0.04 | 해당 서비스 계정 | 알리바바와의 라이선스 관계는 공개되어 있지 않음 |
판단 기준은 세 가지입니다.
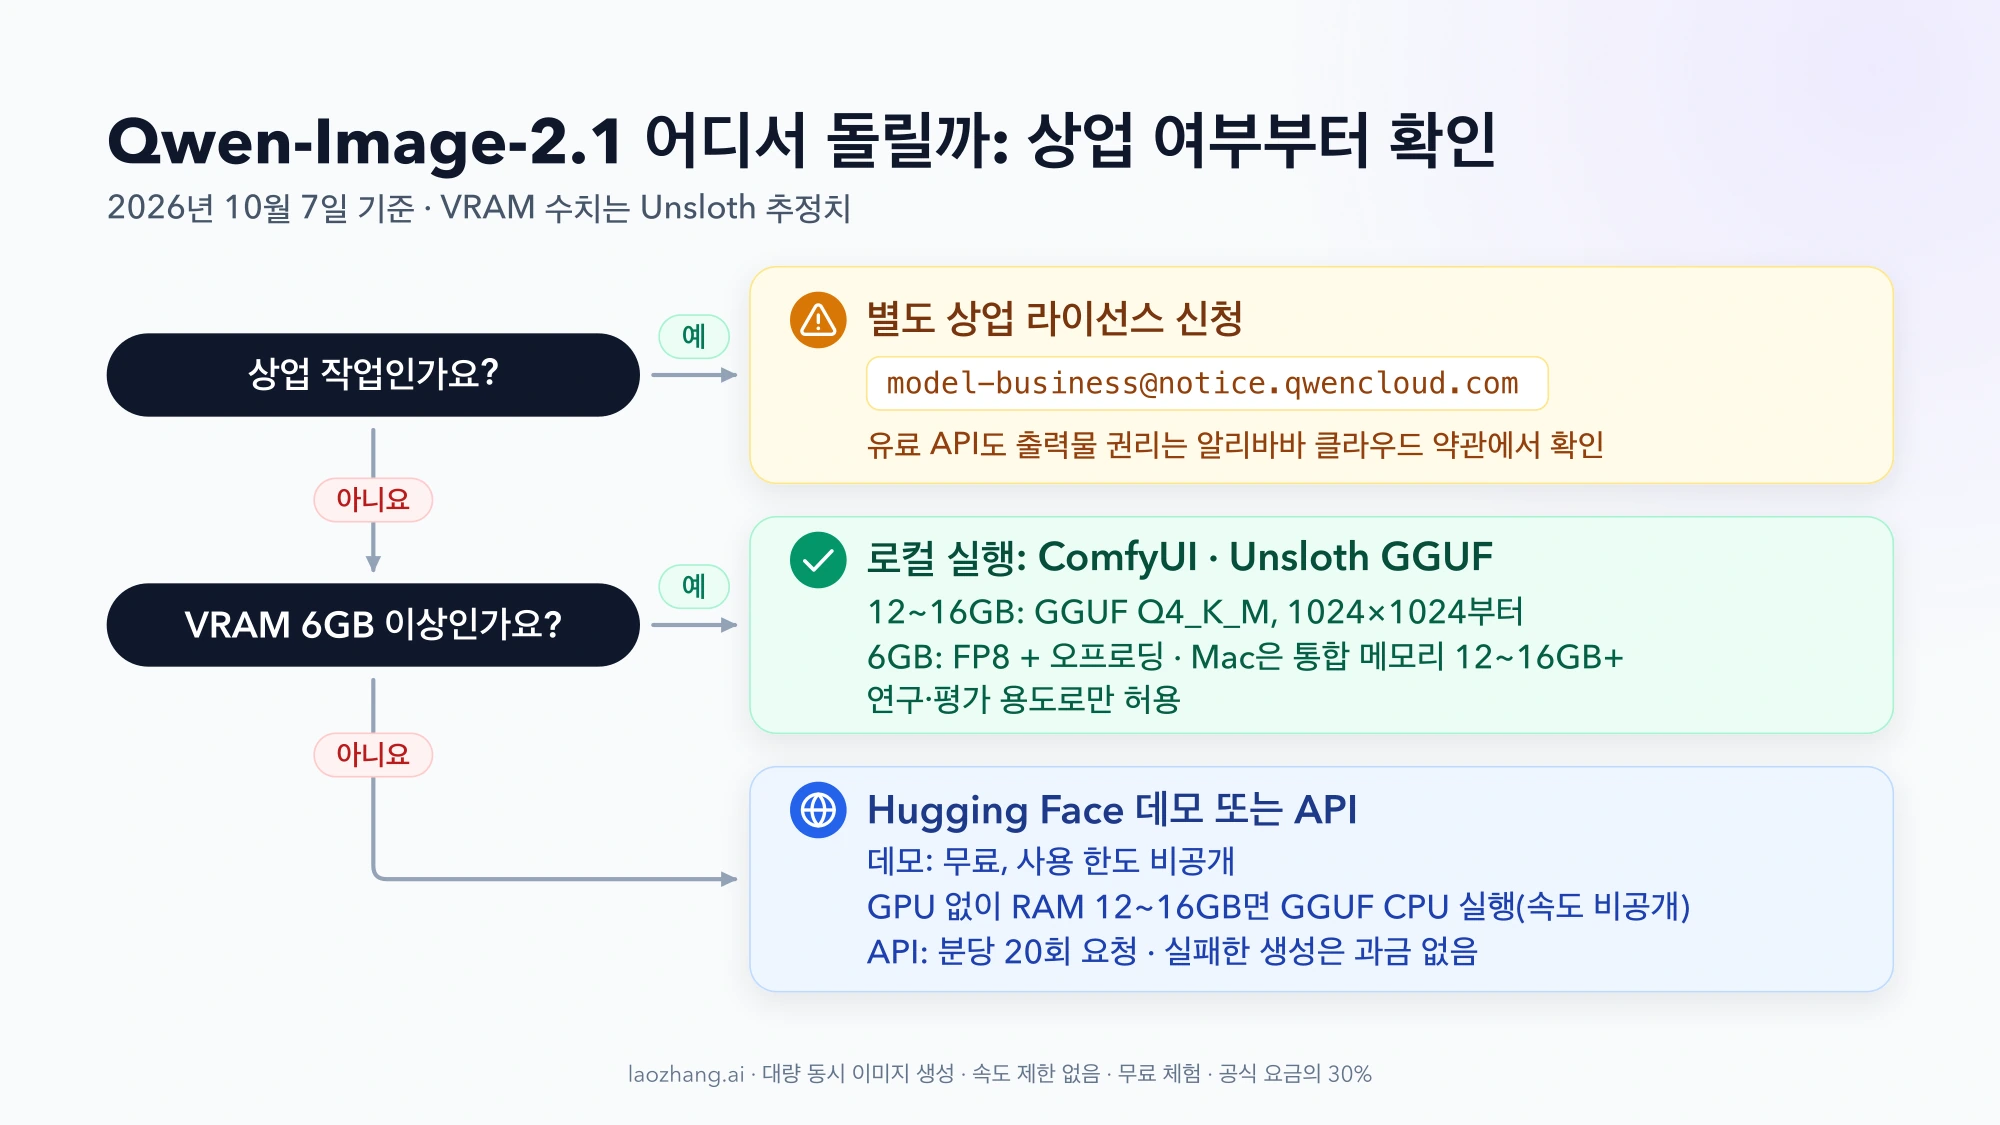
- 상업 작업인가: 그렇다면 무료 데모·콘솔 체험·로컬 실행 모두 조건에 맞지 않습니다. 상업 라이선스부터 확인합니다.
- VRAM이 6GB 이상인가: 6GB 미만이거나 GPU가 없다면 RAM 12~16GB에서 GGUF를 돌리는 CPU 전용 구성이 남지만 속도 기준은 공개되어 있지 않습니다. 몇 장만 만들 거라면 데모나 API가 현실적입니다.
- 한 달에 몇 장이 필요한가: 수십 장이면 데모와 로컬로 충분합니다. 수천 장 단위로 안정적인 처리량이 필요하면 API의 분당 20회 요청 제한까지 계산에 넣어야 합니다(아래 API 가격 절 참고).
Qwen-Image-2.1 연구용 라이선스: 상업적 이용은 별도 신청
라이선스 원문은 사용·복제·수정·배포 권리를 "비상업적 목적에 한해" 허용하고, 비상업을 "연구 또는 평가 목적만"으로 정의합니다. 상업적으로 쓰려면 model-business@notice.qwencloud.com으로 별도 라이선스를 요청하라고 적혀 있습니다. GGUF·FP8 같은 양자화 파일도 같은 가중치에서 나온 파생물이므로 같은 조건을 따릅니다.
상황별로 정리하면 다음과 같습니다. 법률 자문이 아니므로 계약이 걸린 작업은 Qwen 측 답변을 받아 두는 것이 안전합니다.
| 상황 | 라이선스 문언으로 본 판단 |
|---|---|
| 모델 비교, 사내 도입 전 성능 평가, 연구 | 허용 범위("research or evaluation") |
| 클라이언트 납품, 광고 소재, 판매 상품 이미지, 유료 서비스에 내장 | 상업 목적. 별도 라이선스 필요 |
| 개인 취미로 만든 이미지 | 비상업의 정의가 "연구 또는 평가"뿐이라 명시적으로 허용된다고 보기 어려움 |
| 출력물이나 가중치로 학습한 모델을 공개 | 문서에 "Built with Qwen" 또는 "Improved using Qwen" 표기 의무 |
| 가중치를 재배포 | 라이선스 사본과 Notice 파일 동봉, 수정 파일 표시 |
생성한 이미지의 권리에 대해서는 Qwen 공식 X 계정이 2026년 9월 21일 "출력물은 라이선스 대상 자료가 아니며, 모델로 생성한 이미지와 콘텐츠의 권리는 사용자에게 있다"고 답했습니다(GIGAZINE 보도에 게시물이 인용되어 있습니다). 다만 이 답변은 라이선스 본문이 아니고, 회사 업무로 모델을 돌리는 행위 자체가 "연구·평가"에 해당하는지는 다루지 않습니다. 이미지 권리가 내게 있다는 것과 그 이미지를 만드는 과정이 라이선스 범위 안이라는 것은 별개 문제입니다.
알리바바 클라우드 쪽도 둘로 나뉩니다. Model Studio 서비스 약관에 따르면 콘솔의 모델 체험으로 만든 결과물은 모델 성능 평가에만 쓸 수 있고 상업 목적을 포함한 다른 용도는 금지되며, 체험 서비스가 붙인 "AI 생성" 표시도 지우면 안 됩니다. 유료 API 호출 결과물의 권리는 이 페이지에 없고 알리바바 클라우드의 일반 서비스 계약을 따르므로, API를 상업 작업에 쓰기 전에 그 계약을 직접 읽어야 합니다.
Qwen-Image 2.0·3.0과의 관계: 가중치 공개로 돌아온 7B 모델
Qwen-Image 시리즈는 공개 방식이 몇 번 바뀌었습니다. GIGAZINE과 Unite.AI 보도를 기준으로 하면 다음과 같습니다.
| 버전 | 공개 시기 | 가중치 | 라이선스·제공 방식 |
|---|---|---|---|
| Qwen-Image(초대) | 2025년 8월 | 공개 | Apache 2.0 |
| Qwen-Image-2.0 | 2026년 2월 | 비공개 | API 전용 |
| Qwen-Image-3.0 | 2026년 7월 | 비공개 | API 전용 |
| Qwen-Image-2.1 | 2026년 9월 20일 | 공개 | 연구용 라이선스 |
초대 모델의 Apache 2.0 조건을 2.1에 그대로 적용하면 안 된다는 점이 가장 중요합니다. 번호는 2.1이지만 3.0의 후속이나 상위 모델은 아닙니다. 3.0은 공식 벤치마크 없이 출시됐기 때문에 둘의 품질을 직접 비교할 공식 근거도 없습니다. Qwen은 2.1이 Nano Banana 2.0이나 GPT-Image-1.5보다 앞선다는 자체 차트를 냈지만, 이는 제조사 발표입니다. 구글 쪽 최신 폐쇄형 모델의 사용처와 단가는 Nano Banana 2.1의 사용처와 API 가격에서 확인할 수 있습니다.
공식 README에 적힌 구조는 다음과 같습니다.
- 이미지 생성부: 7B 파라미터, 32층 single-stream DiT
- 텍스트 인코더: Qwen3-VL 8B(텍스트 지시와 조건 이미지를 함께 인코딩)
- VAE: 64채널 RGBA, 공간 16배 압축. 투명 채널을 처음부터 다루기 때문에 배경을 따로 오려 낼 필요가 없습니다.
- 기본 해상도: 네이티브 2K. 권장 크기는 1:1 2048×2048, 4:3 2400×1792, 3:4 1792×2400, 3:2 2528×1696, 2:3 1696×2528, 16:9 2752×1536, 9:16 1536×2752
이미지 생성부만 7B이고, 텍스트 인코더 8B가 따로 붙는다는 점이 메모리 계산에서 중요합니다. 공식 기능 목록에는 투명 레이어 편집, 사진에서 피사체 추출, 원·브러시 표시·마스크로 지정하는 부분 편집, 인물과 제품의 동일성 유지, 타이포그래피 개선이 들어 있습니다.
VRAM별 로컬 실행 시작 설정: 6GB 오프로딩부터 24GB INT8까지
로컬 실행의 메모리 기준을 가장 구체적으로 내놓은 곳은 양자화 파일을 배포하는 Unsloth 문서입니다. Unsloth는 이 수치를 "검증된 최소치가 아닌 추정치"라고 밝히고, 해상도와 오프로딩 설정에 따라 사용량이 달라진다고 적었습니다.
| 내 하드웨어 | 시작 설정(Unsloth 추정치) |
|---|---|
| VRAM 6GB | FP8 + 오프로딩. 속도는 2배 이내로 느려짐 |
| VRAM 12~16GB | GGUF Q4_K_M, 1024×1024, 배치 1 |
| VRAM 24GB | INT8/FP8은 512×512, GGUF Q4_K_M은 1024×1024 |
| GPU 없음, RAM 12~16GB | GGUF Q4_K_M + Q4_K_XL 텍스트 인코더 |
| Apple Silicon, 통합 메모리 12~16GB 이상 | 호환 네이티브 백엔드에서 GGUF |
같은 문서 첫머리에는 "GGUF로 11GB VRAM, INT8/FP8로 24GB"라는 문구도 있습니다. 표는 출발점이므로 1024×1024 한 장을 먼저 만들어 보고, 메모리 여유가 있을 때 해상도를 올립니다. 오프로딩을 쓰면 VRAM 대신 시스템 RAM이 필요하다는 점도 같이 계산해야 합니다. Unsloth로 메모리를 산정하는 방식 자체는 Qwen3.8-Flash-Next를 Unsloth로 로컬 실행하기와 비슷하지만, 그 글은 언어 모델 기준이라 수치를 그대로 옮기면 안 됩니다.
INT8과 FP8 중에서는 INT8이 낫습니다. Unsloth 측정에서 INT8 파일은 7.26GB, FP8은 7.12GB로 크기는 비슷하지만, 원본과의 차이를 보는 LPIPS 평균이 INT8 0.064, FP8 0.112로 INT8 쪽 오차가 작았습니다. 그래서 Unsloth도 INT8을 기본값으로 둡니다.
설정값은 파일 형식이 아니라 실제로 모델을 돌리는 백엔드에 맞춥니다.
| 설정 | Unsloth GPU·Diffusers | stable-diffusion.cpp |
|---|---|---|
| 스텝 | 40 | 20 |
| Guidance(CFG) | 1.0 | 6.0 |
| 네거티브 프롬프트 | 비움 | 비움 |
| 첫 실행 해상도 | 1024×1024 | 1024×1024 |
| 시드 | 42 등 고정값 | 42 등 고정값 |
가로·세로는 32의 배수로 맞추고, Unsloth 앱에서는 한 변이 최대 2048픽셀입니다.
ComfyUI에서 첫 이미지 만들기: 파일 3개와 25스텝·cfg 1
ComfyUI는 출시 당일부터 Qwen-Image-2.1을 기본 지원합니다. 생성·편집·배경 제거 템플릿이 모두 ComfyUI 공식 문서에 있으므로 노드를 직접 짤 필요가 없습니다. ComfyUI 문서에는 최소 VRAM 수치가 없고, 템플릿은 메모리를 덜 쓰는 int8_convrot 파일을 불러옵니다.
- ComfyUI를 최신 버전으로 업데이트합니다. 템플릿 목록에 Qwen-Image-2.1이 없거나 노드가 빠져 있다면 대부분 구버전이 원인입니다.
- 템플릿 라이브러리에서 "Qwen-Image-2.1"을 검색해
Qwen Image 2.1 Text to Image를 엽니다. - 누락된 모델 파일 3개를 받습니다. "Models are missing" 안내에서 한꺼번에 받을 수 있고, 받은 뒤 ComfyUI를 재시작하거나 새로 고칩니다.
| 폴더 | 템플릿이 쓰는 파일 | 고정밀 대안 |
|---|---|---|
models/diffusion_models/ | qwen_image_2.1_int8_convrot.safetensors | qwen_image_2.1_bf16.safetensors |
models/text_encoders/ | qwen3vl_8b_int8_convrot.safetensors | qwen3vl_8b_bf16.safetensors |
models/vae/ | qwen_image_2.1_vae_bf16.safetensors | 없음 |
- 해상도를 고릅니다.
Resolution Selector노드에서 1.0MP가 약 1024×1024입니다. 첫 장은 1.0MP로 확인하고, 네이티브 2K(2048×2048)는 4.0MP로 설정합니다. - 샘플러 설정은 그대로 둡니다. 템플릿은 steps 25, cfg 1,
euler샘플러,simple스케줄러입니다. cfg 1에서는 네거티브 프롬프트가 아예 계산되지 않으므로, 네거티브 프롬프트를 써도 결과가 변하지 않습니다. - 프롬프트를 넣고 Run을 누릅니다.
속도는 장비에 따라 크게 다릅니다. GIGAZINE이 Intel Arc Pro B70(32GB)과 Ryzen 5 7600X로 1024×1024, 25스텝을 돌렸을 때 첫 장은 약 45초, 이후는 약 30초가 걸렸습니다. 한 대의 PC에서 한 번 해 본 결과이므로 대략적인 감만 잡는 데 쓰면 됩니다. 같은 테스트에서 일본어 프롬프트도 받아들였고, 신문 속 글자는 첫 시드에서 틀렸다가 시드를 바꾸자 맞게 나왔습니다.
템플릿에는 짧은 프롬프트를 길게 고쳐 쓰는 프롬프트 확장 기능도 들어 있습니다. 기본값은 꺼져 있고(refine_prompt off), 켜면 Qwen3.5 기반 9B 재작성 모델(qwen3.5_9b_qwen_image_2.1_pe_t2i, 편집용은 pe_i2i)이 추가로 메모리에 올라갑니다. VRAM이 빠듯하다면 먼저 꺼 둔 상태로 결과를 보는 편이 낫습니다.
Qwen-Image-2.1 투명 배경 PNG 만들기: 공식 프롬프트 형식
투명 배경은 생성 후에 오려 내는 방식이 아니라 RGBA VAE가 알파 채널까지 직접 만드는 방식입니다. 공식 README가 권장하는 프롬프트 형식은 다음과 같습니다.
This is an RGBA image with transparency. <원하는 이미지 설명>. The image has alpha channel and the background is transparent.예를 들어 스티커용 캐릭터라면 This is an RGBA image with transparency. A cute cartoon dragon sticker. The image has alpha channel and the background is transparent.처럼 가운데 설명만 바꿉니다. GIGAZINE 테스트에서는 프롬프트에 "투명 PNG"에 해당하는 말만 넣어도 배경이 완전히 투명하게 나왔지만, 한 번의 시도였으므로 안정적으로 쓰려면 공식 형식이 낫습니다.
이미 있는 사진의 배경을 지우려면 ComfyUI의 세 번째 템플릿 Remove Background: Qwen Image 2.1을 씁니다. 편집 워크플로에 Remove the background, and output a PNG image라는 지시를 넣어 원본과 결과를 나란히 보여 줍니다.
결과는 GIMP나 포토샵처럼 알파 채널을 보여 주는 편집기에서 확인합니다. 미리보기용으로 축소하거나 다른 형식으로 변환하면 투명도가 사라질 수 있으므로, 사용할 파일은 원본 PNG로 보관합니다.
참조 이미지 10장인가 16장인가: 공식 10장, 노드 슬롯 16개
공식 지원 개수는 10장입니다. 모델 카드와 알리바바 클라우드 모델 페이지 모두 "최대 10장의 참조 이미지"라고 적고 있습니다. 16이라는 숫자는 ComfyUI의 Text Encode Qwen Image 2.1 노드가 image_1부터 image_16까지 슬롯 16개를 받는 데서 나왔고, 정작 ComfyUI의 편집 템플릿 두 개도 앞의 10개만 연결해 두었습니다. 슬롯 수는 노드 사양일 뿐 모델이 보장하는 기능은 아닙니다.
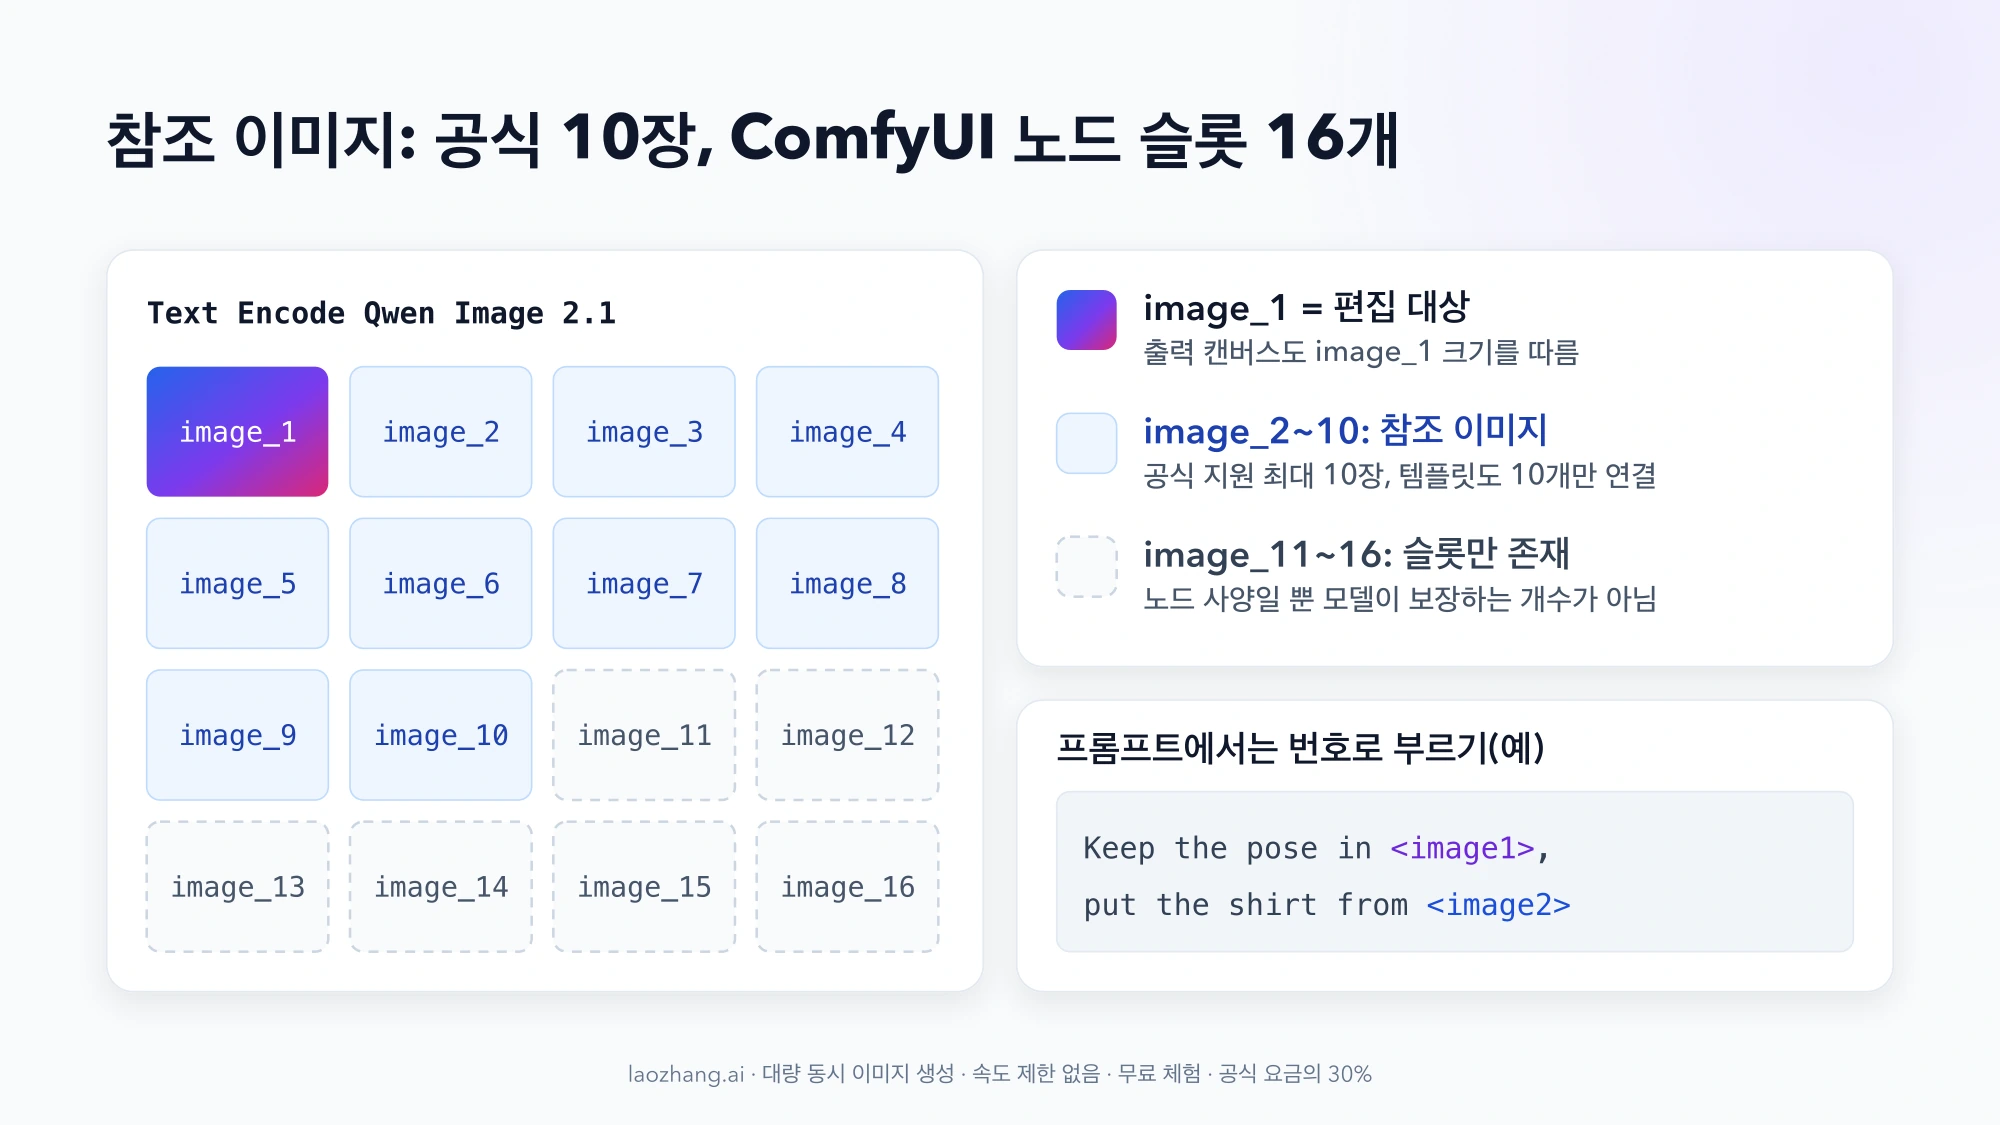
다중 참조 편집은 이렇게 동작합니다.
image_1이 편집 대상이고, 나머지는 가져올 내용(옷, 소품, 다른 인물)을 제공합니다.- 프롬프트에서는 번호로 부릅니다.
image_1은<image1>,image_2는<image2>입니다. - ComfyUI 문서의 예시는
Keep the character and pose in <image1> unchanged, put this light blue denim shirt from <image2> on the character, preserve the original facial features, hair, body shape and pose입니다.
특정 부분만 고치려면 image_1을 불러오는 LoadImage 노드에서 Mask Editor를 열고 Paint Pen으로 그 영역을 칠한 뒤 저장합니다. 그다음 프롬프트에 "change the jacket in the red area"처럼 표시한 색을 적으면 그 영역을 가리키게 됩니다. 옷 색 하나 바꾸는 정도의 단순한 부분 편집은 4~8스텝에서도 유지되므로 기본 25스텝보다 몇 배 빨라집니다. 화면 전체를 바꾸는 편집은 25스텝을 그대로 둡니다.
편집이 유난히 느리면 캔버스 크기부터 봅니다. 템플릿 기본값에서는 출력 캔버스가 image_1의 픽셀 크기를 따르기 때문에, 3000×4000 사진을 넣으면 3008×4000(약 12MP)으로 계산됩니다. ComfyUI 문서에 따르면 RTX 5090에서 이 크기는 스텝당 약 6초, resolution을 1024로 낮춘 약 1MP(896×1184)는 스텝당 약 0.3초였습니다. 큰 참조 이미지를 여러 장 넣으면 더 느려집니다.
Diffusers로 직접 실행하기: QwenImage21Pipeline 예제
Python 환경에서 직접 돌리려면 Diffusers의 QwenImage21Pipeline을 씁니다. 필요한 패키지는 공식 README 기준으로 다음과 같습니다.
pip install "torch>=2.4.0" "transformers>=5.17" accelerate pillow
pip install git+https://github.com/huggingface/diffusers
아래 코드는 README의 투명 이미지 예제에 VRAM이 부족할 때 쓰는 enable_model_cpu_offload()를 더한 것입니다. CUDA GPU가 있는 환경을 전제로 하며, 처음 실행할 때 Hugging Face에서 가중치를 내려받습니다.
import torch
from diffusers import QwenImage21Pipeline

pipe = QwenImage21Pipeline.from_pretrained(
    "Qwen/Qwen-Image-2.1", torch_dtype=torch.bfloat16
)
pipe.enable_model_cpu_offload()  # VRAM이 넉넉하면 대신 pipe.to("cuda")

image = pipe(
    prompt=(
        "This is an RGBA image with transparency. "
        "A ceramic coffee mug with a small cactus logo. "
        "The image has alpha channel and the background is transparent."
    ),
    width=1024,
    height=1024,
    num_inference_steps=40,
    generator=torch.Generator("cuda").manual_seed(42),
).images[0]

image.save("mug_transparent.png")
Diffusers 기본값은 40스텝, 2048×2048입니다. 위 예제는 첫 실행 부담을 줄이려고 1024×1024로 낮췄습니다. 편집은 같은 파이프라인에 image=Image.open("input.png")를, 다중 참조는 이미지 리스트를 넘깁니다.
여러 사람이 쓰는 서버로 띄우려면 vLLM-Omni의 vllm serve Qwen/Qwen-Image-2.1 --omni가 OpenAI 형식의 /v1/images/generations 엔드포인트를 제공하고, SGLang의 sglang generate와 LightX2V도 출시 당일부터 지원합니다. 다만 직접 서버를 운영해도 가중치 라이선스는 그대로 연구용입니다.
Qwen-Image-2.1 API 가격: 장당 $0.04, 1,000장이면 $40
알리바바 클라우드 Model Studio는 qwen-image-2.1-pro라는 이름으로 2.1을 판매합니다. 모델 가격 페이지(2026년 10월 6일 갱신) 기준 단가는 다음과 같고, 실패한 생성 요청은 과금되지 않습니다.
| 리전 | 장당 가격 | 무료 제공 |
|---|---|---|
| 싱가포르(International) | $0.04 | 10장(싱가포르 한정, 90일 유효) |
| 베이징·홍콩·프랑크푸르트·버지니아·도쿄(Global) | $0.035333 | 없음 |
1,000장 비용은 단가 × 장수로 바로 계산됩니다.
- 싱가포르: 1,000 × $0.04 = $40
- Global 리전: 1,000 × $0.035333 ≈ $35.33
- 100장이면 각각 $4, 약 $3.53
이 계산은 성공한 출력 이미지만 센 값입니다. 마음에 드는 결과가 나올 때까지 다시 생성하는 횟수, 세금은 포함되지 않습니다. 중국어판 Model Studio(Bailian) 페이지는 베이징 리전을 장당 0.25위안으로 표기합니다.
같은 플랫폼의 다른 Qwen 이미지 모델과 비교하면(싱가포르 기준) qwen-image-3.0은 장당 $0.03에 입력 이미지가 장당 $0.003 추가되고, qwen-image-2.0은 $0.035, qwen-image-2.0-pro는 $0.075입니다. 이름의 "Pro"는 알리바바 클라우드의 상품명일 뿐 공개 가중치보다 성능이 높다는 근거는 아니며, 호스팅 버전이 공개 가중치와 완전히 같은 모델인지도 공개되어 있지 않습니다.
처리량 한도도 미리 봐야 합니다. QwenCloud 모델 페이지에 따르면 분당 요청 20회(RPM 20), 동시 실행 10건, 비동기 대기열 200건입니다. 요청 1건에 1장씩 만든다면 분당 20장이 상한이므로, 1,000장에는 1,000 ÷ 20 = 최소 50분이 걸립니다. 요청 형식은 같은 페이지의 예제와 같습니다.
curl --location 'https://maas.qwencloudapi.com/api/v1/services/aigc/multimodal-generation/generation' \
  --header 'Content-Type: application/json' \
  --header "Authorization: Bearer $DASHSCOPE_API_KEY" \
  --data '{
    "model": "qwen-image-2.1-pro",
    "input": {
      "messages": [
        {"role": "user", "content": [{"text": "A minimalist poster with the headline \"OPEN WEIGHTS\" in bold sans-serif"}]}
      ]
    },
    "parameters": {"prompt_extend": true}
  }'
서드파티 중에서는 Kie.ai가 1K 이미지를 4크레딧(약 $0.02), 2K를 8크레딧(약 $0.04)으로 판매합니다. 1K로 1,000장이면 약 $20입니다. 페이지에 "Commercial use" 표시가 있지만, 알리바바로부터 상업 라이선스를 받았는지는 밝히지 않으므로 상업 작업의 근거로 삼기는 어렵습니다.
Qwen-Image-2.1이 잘 안 될 때: VRAM 부족, 4K, cfg 값
| 증상 | 먼저 할 일 |
|---|---|
| 메모리 부족(OOM) | 해상도를 1024×1024로, 배치를 1로 낮추고 GPU를 쓰는 다른 프로그램을 닫습니다. 그래도 안 되면 더 작은 GGUF나 CPU 오프로딩으로 바꿉니다. 스텝 수를 줄여도 메모리 문제는 풀리지 않습니다. |
| 편집이 지나치게 느림 | 참조 이미지 픽셀 크기와 resolution 값을 확인합니다. RTX 5090 기준으로 12MP 캔버스는 1MP보다 스텝당 약 20배(6초 대 0.3초) 느립니다. |
| 4K로 뽑으면 프롬프트를 덜 따름 | 학습 해상도인 2K를 크게 넘기면 반영도가 떨어집니다. 공식 권장 크기 안에서 생성합니다. |
| 네거티브 프롬프트가 안 먹힘 | cfg 1에서는 정상 동작입니다. 네거티브가 꼭 필요할 때만 cfg를 올립니다. |
| 작은 글자·숫자가 틀림 | cfg 2가 촘촘한 글자를 더 잘 따르지만 윤곽이 과하게 날카로워집니다. 시드를 바꿔 보는 것도 효과가 있습니다. cfg 5는 품질이 크게 떨어지고 0.5는 이미지가 깨집니다. |
| 손가락 같은 세부가 뭉개짐 | 스텝을 30 전후로 올립니다. 25에서 40으로 올리면 세밀한 부분의 잡티가 줄어듭니다. |
| 템플릿이나 노드가 안 보임 | ComfyUI를 최신(Nightly 포함) 버전으로 업데이트합니다. |
cfg나 스텝을 바꿀 때는 시드를 고정하고 한 번에 한 값만 바꿔 비교하라는 것이 ComfyUI 문서의 권장입니다.
Qwen-Image-2.1 자주 묻는 질문
Qwen-Image-2.1은 오픈소스인가요?
가중치는 공개되어 있지만 오픈소스 라이선스는 아닙니다. 2025년 8월의 초대 Qwen-Image는 Apache 2.0이었던 반면, 2.1은 연구·평가 목적만 허용하는 Qwen Research License로 배포됩니다. "오픈소스니까 상업적으로 써도 된다"는 판단은 2.1에는 맞지 않습니다.
Qwen-Image-2.1에 한국어 프롬프트를 써도 되나요?
공식 문서에는 지원 언어 목록이 없습니다. GIGAZINE 테스트에서 일본어 프롬프트가 통했고 Kie.ai 페이지는 "모든 언어 지원"이라고 적었지만, 한국어 프롬프트나 이미지 속 한글 렌더링 품질을 다룬 공개 자료는 없습니다. 한글 문구가 중요한 작업이라면 같은 시드로 영어 프롬프트와 한국어 프롬프트를 나란히 만들어 비교해 보는 것이 빠릅니다.
Mac에서도 Qwen-Image-2.1을 돌릴 수 있나요?
Unsloth는 통합 메모리 12~16GB 이상인 Apple Silicon Mac에서 GGUF 파일을 호환 네이티브 백엔드로 실행하는 구성을 출발점으로 제시합니다. 역시 추정치이므로 1024×1024 한 장으로 먼저 확인합니다.
Claude 안에서 Qwen 이미지를 만들 수 있나요?
Claude의 Hugging Face 커넥터를 통해 Hugging Face Space의 이미지 모델을 부르는 방식이 있습니다. 연결 방법과 무료 플랜 제한은 Claude 이미지 생성 커넥터 비교에 정리되어 있습니다. Space에서 돌아가는 모델이 Qwen-Image-2.1이라면 결과물에도 같은 연구용 라이선스 조건이 걸린다고 보는 것이 안전합니다.