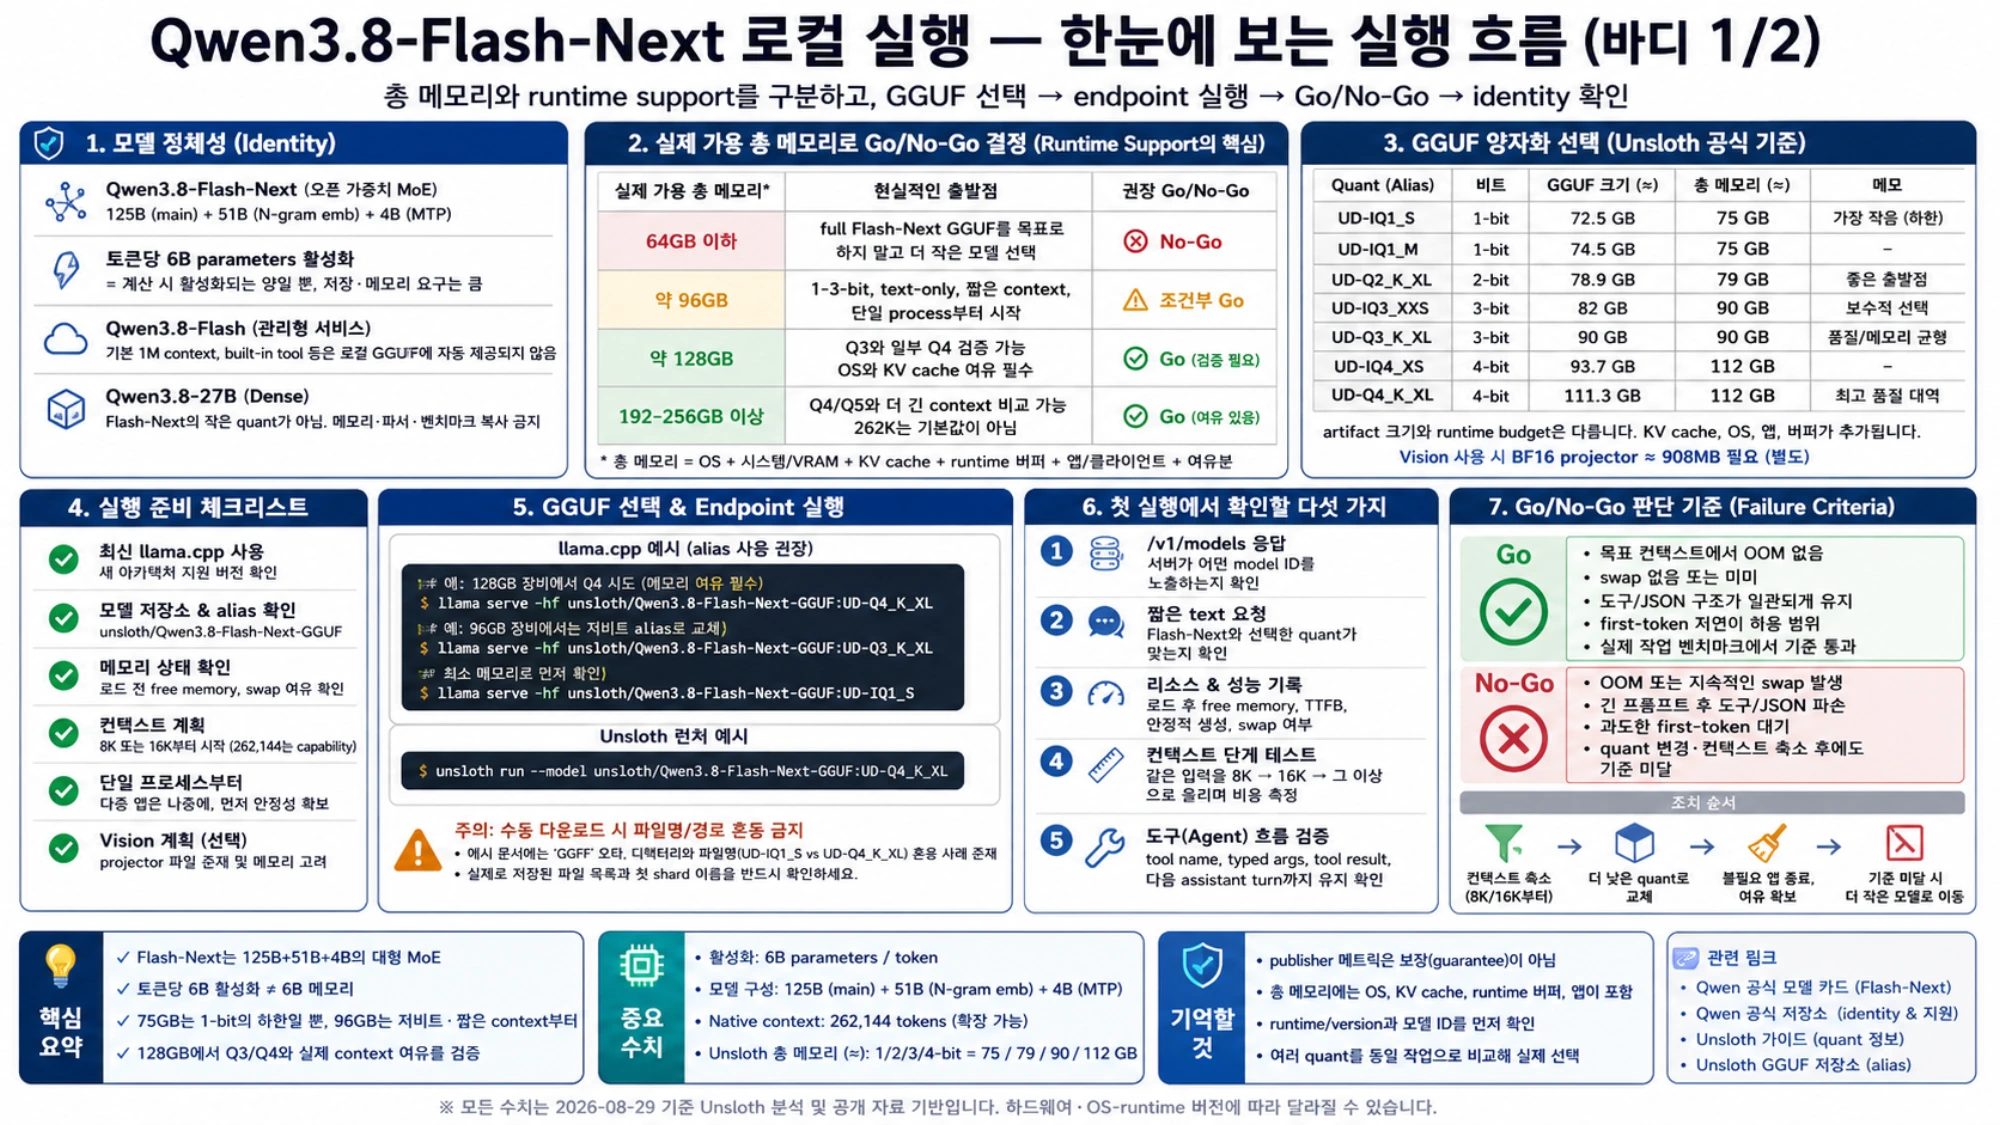
Qwen3.8-Flash-Next를 로컬에서 돌릴 수 있다는 말은 맞지만, 75GB만 확보하면 모든 작업이 해결된다는 뜻은 아닙니다. Unsloth는 가장 작은 1비트 양자화 모델의 최소 총 메모리를 75GB로 제시하고 96GB RAM 또는 통합 메모리 장치를 권장합니다. 2026년 9월 12일 확인한 4비트 하드웨어 기준은 96~114GB입니다. 따라서 128GB 장비도 긴 컨텍스트나 여러 앱을 동시에 사용하려면 남는 메모리를 계산해야 합니다.
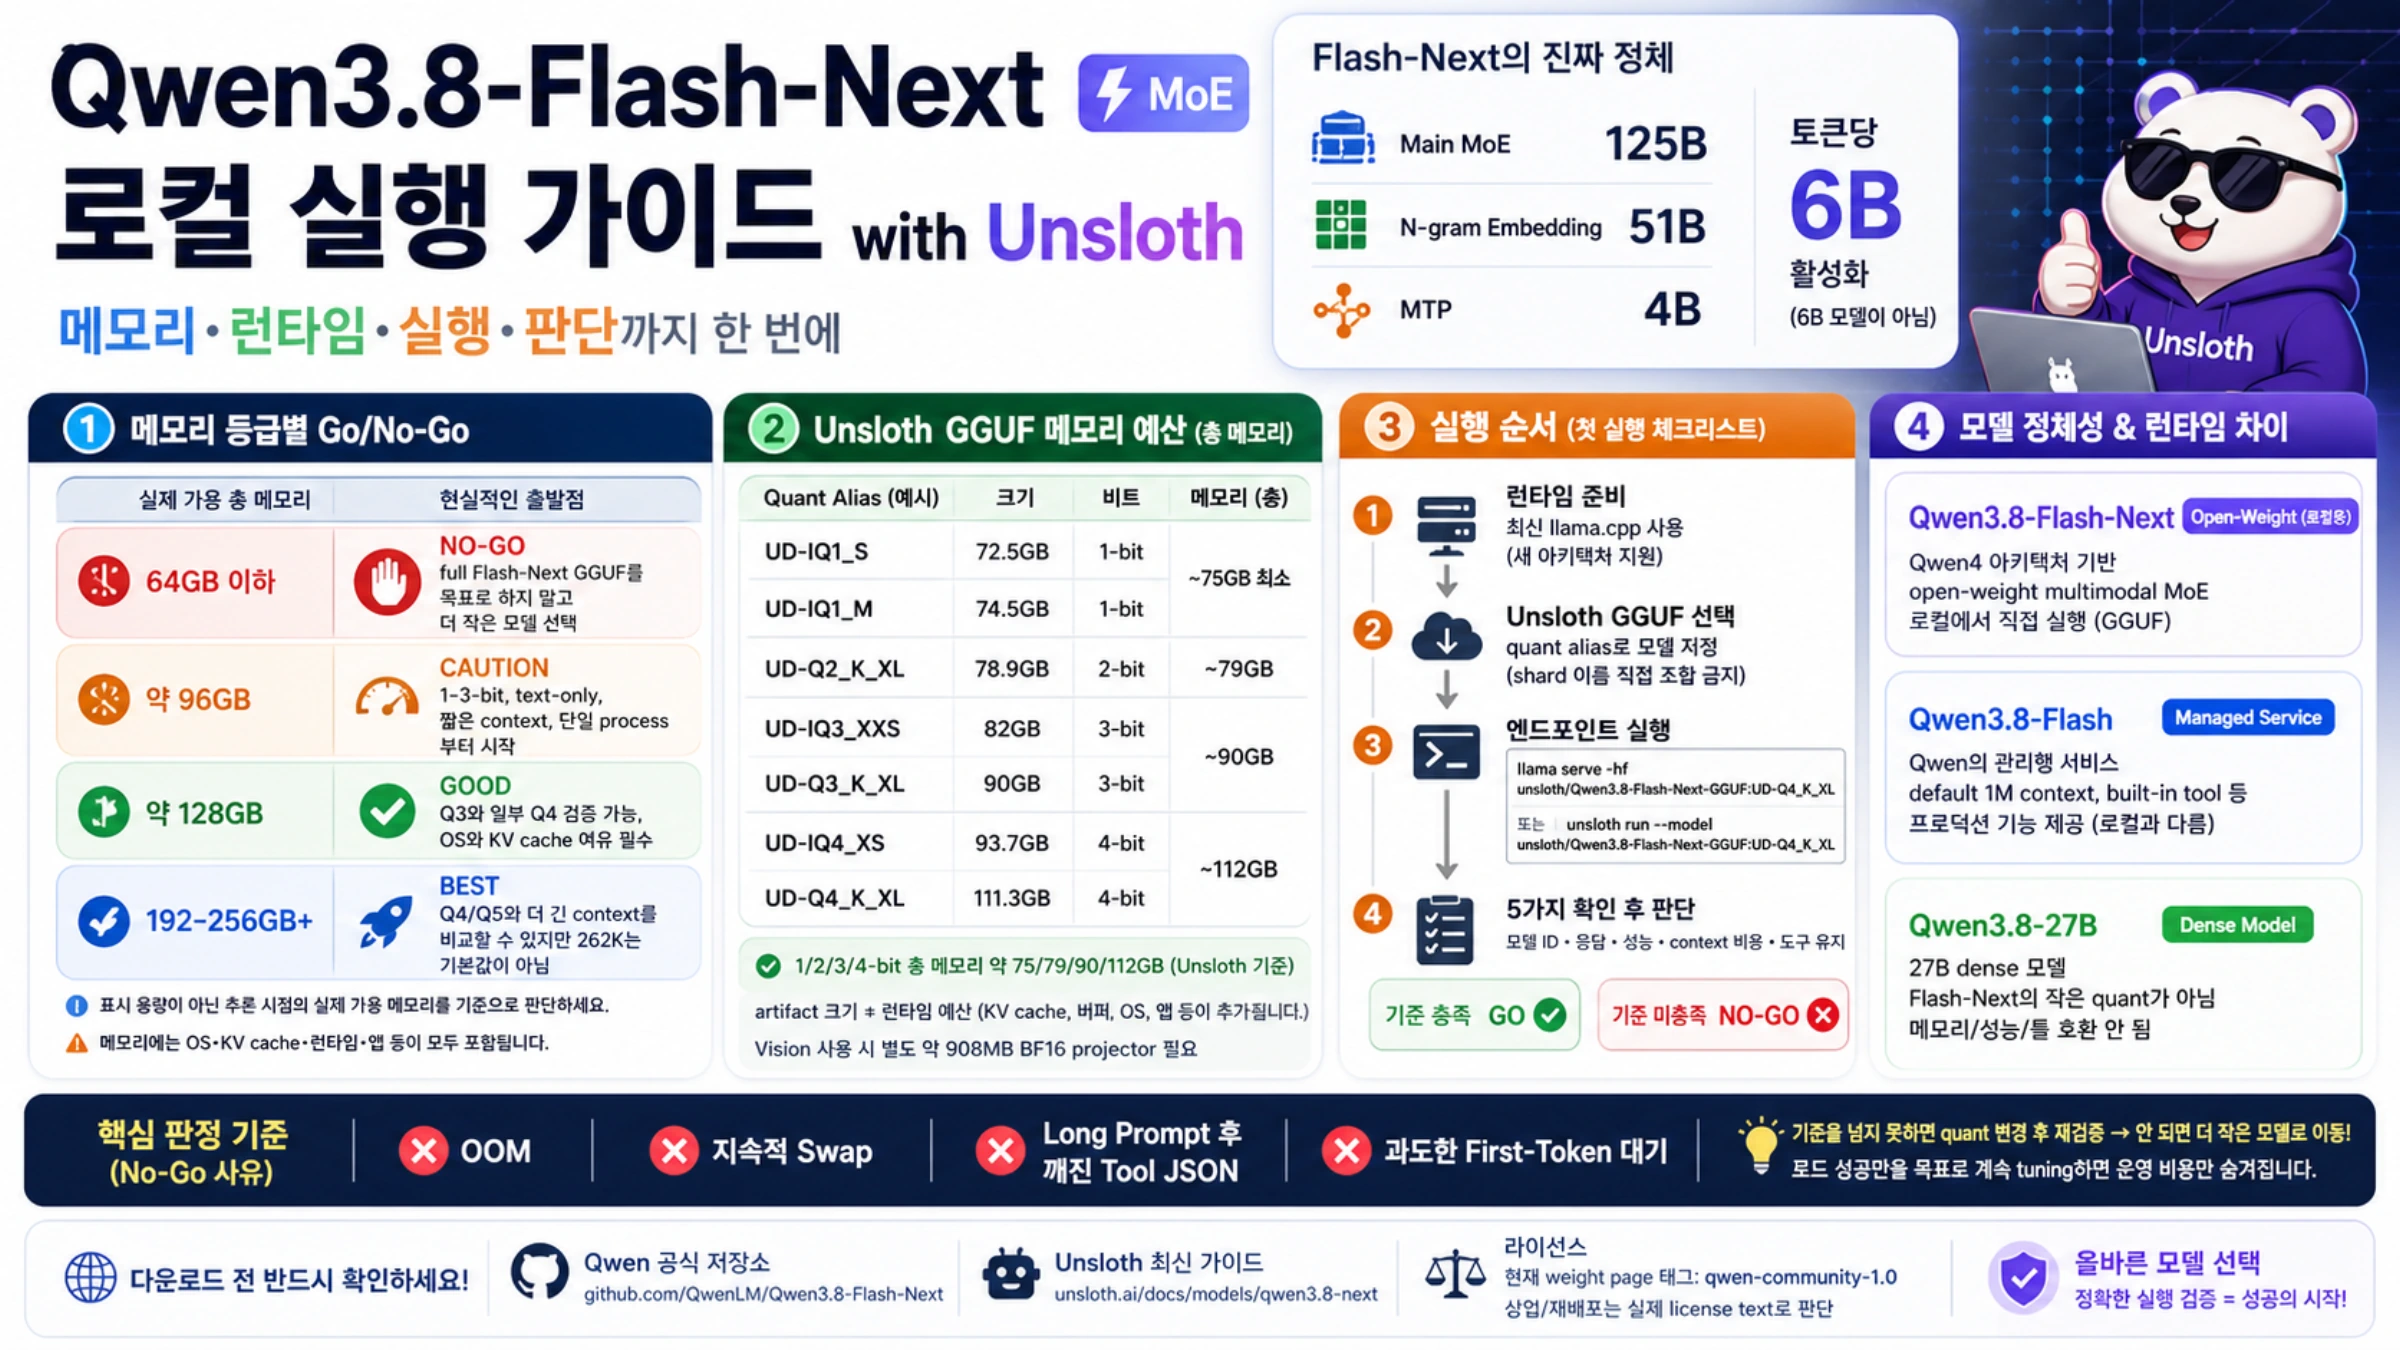
“토큰당 60억 개의 파라미터 활성화”가 60억 파라미터 모델만큼의 메모리로 실행된다는 뜻은 아닙니다. Qwen 공식 모델 카드에 따르면 본체 MoE는 125B, N-gram 임베딩은 51B, MTP는 4B입니다. 한 토큰을 계산할 때 본체의 6B만 활성화되더라도 전체 가중치를 보관하고 읽을 공간은 필요합니다.
메모리가 부족한 구성부터 제외하세요
표시된 용량이 아니라 추론 시점의 실제 가용 메모리를 봅니다. Apple Silicon에서는 macOS와 앱이 통합 메모리를 공유합니다. 별도 GPU를 사용하는 시스템은 VRAM뿐 아니라 시스템 RAM, PCIe 전송과 CPU로 작업을 분산할 때의 부담도 함께 봐야 합니다.
| 실제 가용 총 메모리 | 현실적인 출발점 |
|---|---|
| 64GB 이하 | 전체 Flash-Next GGUF를 목표로 하지 말고 더 작은 모델 선택 |
| 약 96GB | 1~3비트 양자화, 텍스트 전용, 짧은 컨텍스트, 단일 프로세스부터 시작 |
| 약 128GB | Q3와 일부 Q4 검증 가능, OS와 KV 캐시 여유 필수 |
| 192–256GB 이상 | Q4/Q5와 더 긴 컨텍스트를 비교할 수 있지만 262K는 기본값이 아님 |
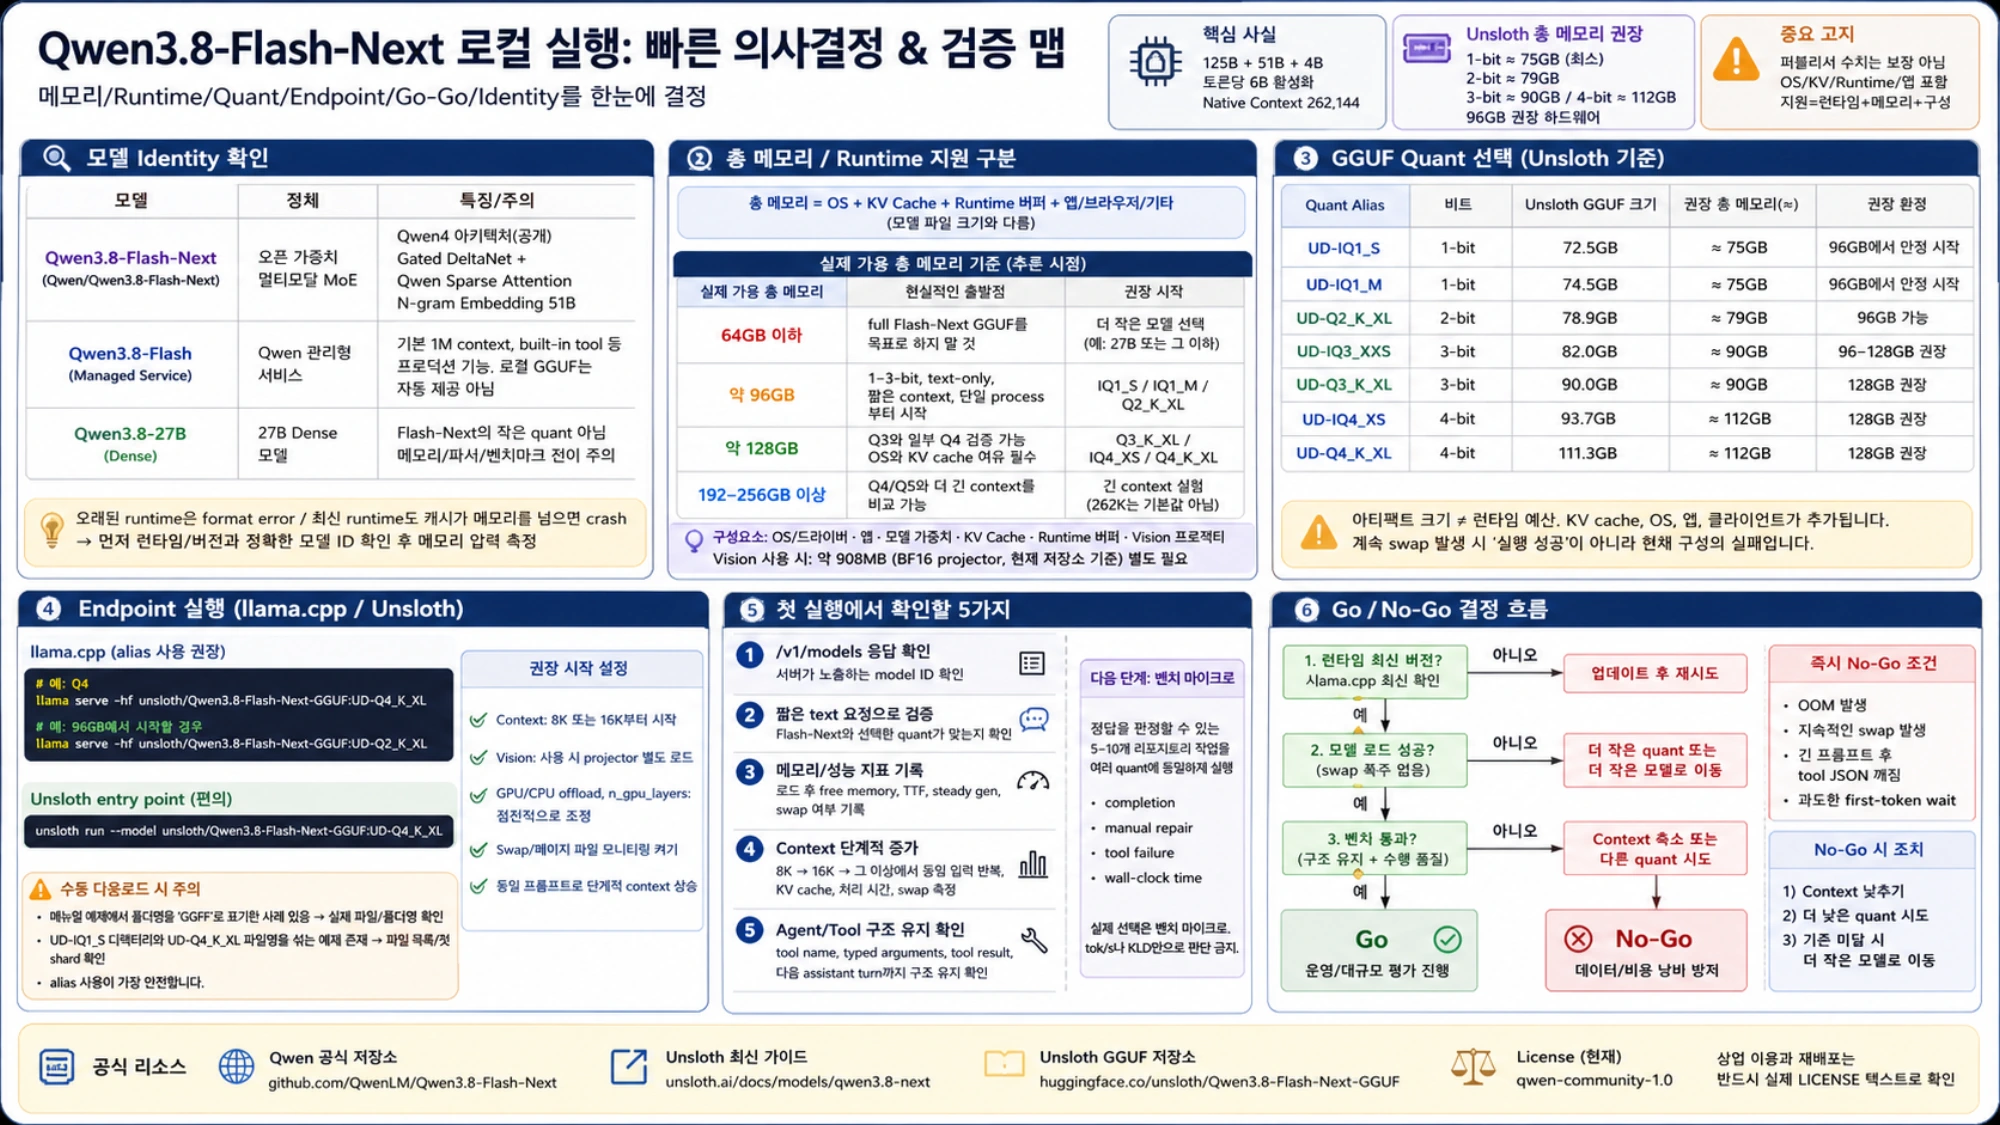
Unsloth의 현재 분석은 UD-IQ1_S 72.5GB, UD-IQ1_M 74.5GB, UD-Q2_K_XL 78.9GB, UD-IQ3_XXS 82GB, UD-Q3_K_XL 90GB, UD-IQ4_XS 93.7GB, UD-Q4_K_XL 111.3GB를 보여 줍니다. 별도 하드웨어 표의 참고 메모리는 1·2·3비트가 각각 75·79·90GB, 4비트가 96~114GB, 5비트가 163GB, 8비트가 200GB, BF16이 355GB입니다. 양자화 파일의 크기와 구분해서 읽어야 합니다.
파일 크기와 실행 중 필요한 메모리는 다릅니다. KV 캐시, 연산 버퍼, 운영체제와 클라이언트도 메모리를 사용하며 대화 템플릿에 따라 입력량도 달라집니다. 이미지 입력을 쓰려면 저장소에 별도로 제공되는 약 908MB BF16 프로젝터도 필요합니다. 모델을 불러온 뒤 스왑이 계속 발생해 응답이 느려진다면 실무에 쓸 수 있는 구성인지 다시 판단해야 합니다.
24–48GB급 장비에서 로컬 코딩 에이전트가 필요하다면 별도의 밀집 모델인 Qwen3.8-27B 로컬 코딩 에이전트 가이드가 더 적절합니다.
모델을 잘못 고른 경우와 실행 프로그램 문제를 구분하세요
Qwen/Qwen3.8-Flash-Next는 Qwen4 구조를 미리 선보인 오픈 가중치 멀티모달 MoE 모델입니다. Gated DeltaNet과 Qwen Sparse Attention을 결합하고 N-gram 임베딩으로 모델 용량을 확장합니다.
Qwen3.8-Flash는 Qwen이 운영하는 서비스형 모델입니다. Qwen은 이 버전에 기본 100만 토큰 컨텍스트와 내장 도구 등 서비스 운영용 기능이 있다고 설명합니다. 로컬 GGUF 서버에 같은 기능이 자동으로 생기지는 않습니다.
Qwen3.8-27B는 27B 밀집 모델입니다. Flash-Next를 작게 양자화한 모델이 아니므로 메모리 요구량, 파서와 벤치마크 결과를 서로 적용하면 안 됩니다.
오래된 실행 프로그램이 새 모델 형식을 읽지 못한다면 메모리를 늘려도 해결되지 않습니다. 반대로 모델을 정상적으로 읽어도 캐시가 가용 메모리를 넘으면 실행 중 종료될 수 있습니다. 프로그램 버전과 실제 모델 ID부터 확인한 뒤 메모리 사용량을 살펴보세요.
Qwen의 코딩·에이전트·도구 사용 벤치마크는 이 모델을 시험해 볼 근거입니다. 다만 Qwen의 평가 환경에서 얻은 결과이므로 Unsloth 저비트 양자화가 자신의 도구 스키마를 지키거나 특정 DGX Spark·Mac에서 같은 성능을 낸다는 보장은 아닙니다.
양자화 모델의 별칭으로 실행하세요
새 모델 구조를 지원하는 최신 llama.cpp를 사용합니다. Unsloth GGUF 저장소는 양자화 모델 별칭을 제공하므로 분할 파일 이름을 직접 조합하지 않아도 됩니다.
llama serve -hf unsloth/Qwen3.8-Flash-Next-GGUF:UD-Q4_K_XL96GB 장비에서는 이 Q4 예제를 그대로 실행하지 말고 가용 메모리에 맞는 저비트 양자화 별칭으로 바꾸세요. Unsloth 명령도 사용할 수 있습니다.
unsloth run --model unsloth/Qwen3.8-Flash-Next-GGUF:UD-Q4_K_XL수동으로 다운로드할 때는 문서의 경로를 그대로 복사하기보다 실제 저장된 파일 목록을 확인하세요. 폴더의 양자화 이름과 실행할 파일의 양자화 이름이 일치해야 하며, 여러 파일로 나뉜 모델은 첫 분할 파일을 올바르게 지정해야 합니다.
컨텍스트는 8K 또는 16K부터 시작해 보세요. 기본 262,144토큰과 100만 토큰까지 확장할 수 있다는 사양을 로컬 실행의 기본값으로 삼으면 메모리가 부족할 수 있습니다. 같은 요청으로 컨텍스트를 단계적으로 늘리며 KV 캐시, 입력 처리 시간과 스왑을 기록하세요.
첫 실행에서 확인할 다섯 가지
/v1/models가 응답하고 서버가 어떤 모델 ID를 노출하는지 확인합니다.- 실행 로그에서 실제로 불러온 Flash-Next 양자화 파일을 확인하고 짧은 텍스트 요청이 완료되는지 시험합니다.
- 모델을 불러온 뒤 남은 메모리, 첫 토큰 지연, 지속 생성 속도와 스왑 여부를 기록합니다.
- 같은 입력을 8K, 16K, 그 이상에서 반복해 컨텍스트에 따른 메모리·시간 비용을 측정합니다.
- 에이전트 용도라면 도구 이름, 정해진 형식의 인수, 도구 결과와 후속 답변까지 구조가 유지되는지 봅니다.
그다음 결과를 확인할 수 있는 저장소 작업들을 여러 양자화 모델에 똑같이 맡겨 보세요. 완료율, 사람이 고친 부분, 도구 오류와 전체 소요 시간을 비교하면 초당 토큰 수나 KLD만 보는 것보다 실제 선택에 도움이 됩니다.
메모리 부족(OOM), 지속적인 스왑, 긴 입력 뒤 깨지는 도구 JSON과 지나치게 긴 첫 응답 대기는 구성을 다시 검토할 신호입니다. 컨텍스트를 줄이고 양자화 모델을 바꿔도 필요한 기준을 충족하지 못하면 더 작은 모델을 선택하세요. 모델이 메모리에 올라갔다는 사실만으로 실무에 쓸 수 있다고 판단하면 안 됩니다.
어떤 경우에 Flash-Next가 맞는가
96GB급 장비에서 충분한 가용 메모리를 확보할 수 있고 저비트 양자화의 품질 손실을 감수하면서 대용량 희소 모델의 에이전트·긴 문맥 처리 능력을 시험하려면 검토할 만합니다. Q3/Q4 비교에는 다른 메모리 사용 앱을 닫을 수 있는 128GB급이 더 낫습니다.
64GB가 하드 한계이거나 빠르게 응답하는 상시 어시스턴트가 목적이라면 작은 밀집 모델이 합리적입니다. Flash-Next 구조는 토큰당 계산량을 줄이지만 가중치와 N-gram 임베딩을 저장할 메모리까지 없애 주지는 않습니다.
다운로드 전에 Qwen 공식 저장소에서 모델 종류와 실행 프로그램 지원 여부를 확인하고 Unsloth 최신 안내에서 양자화 정보를 다시 확인하세요. 현재 가중치 페이지의 라이선스 태그는 qwen-community-1.0입니다. 상업 이용이나 재배포는 태그만 보지 말고 실제 라이선스 본문으로 판단해야 합니다.