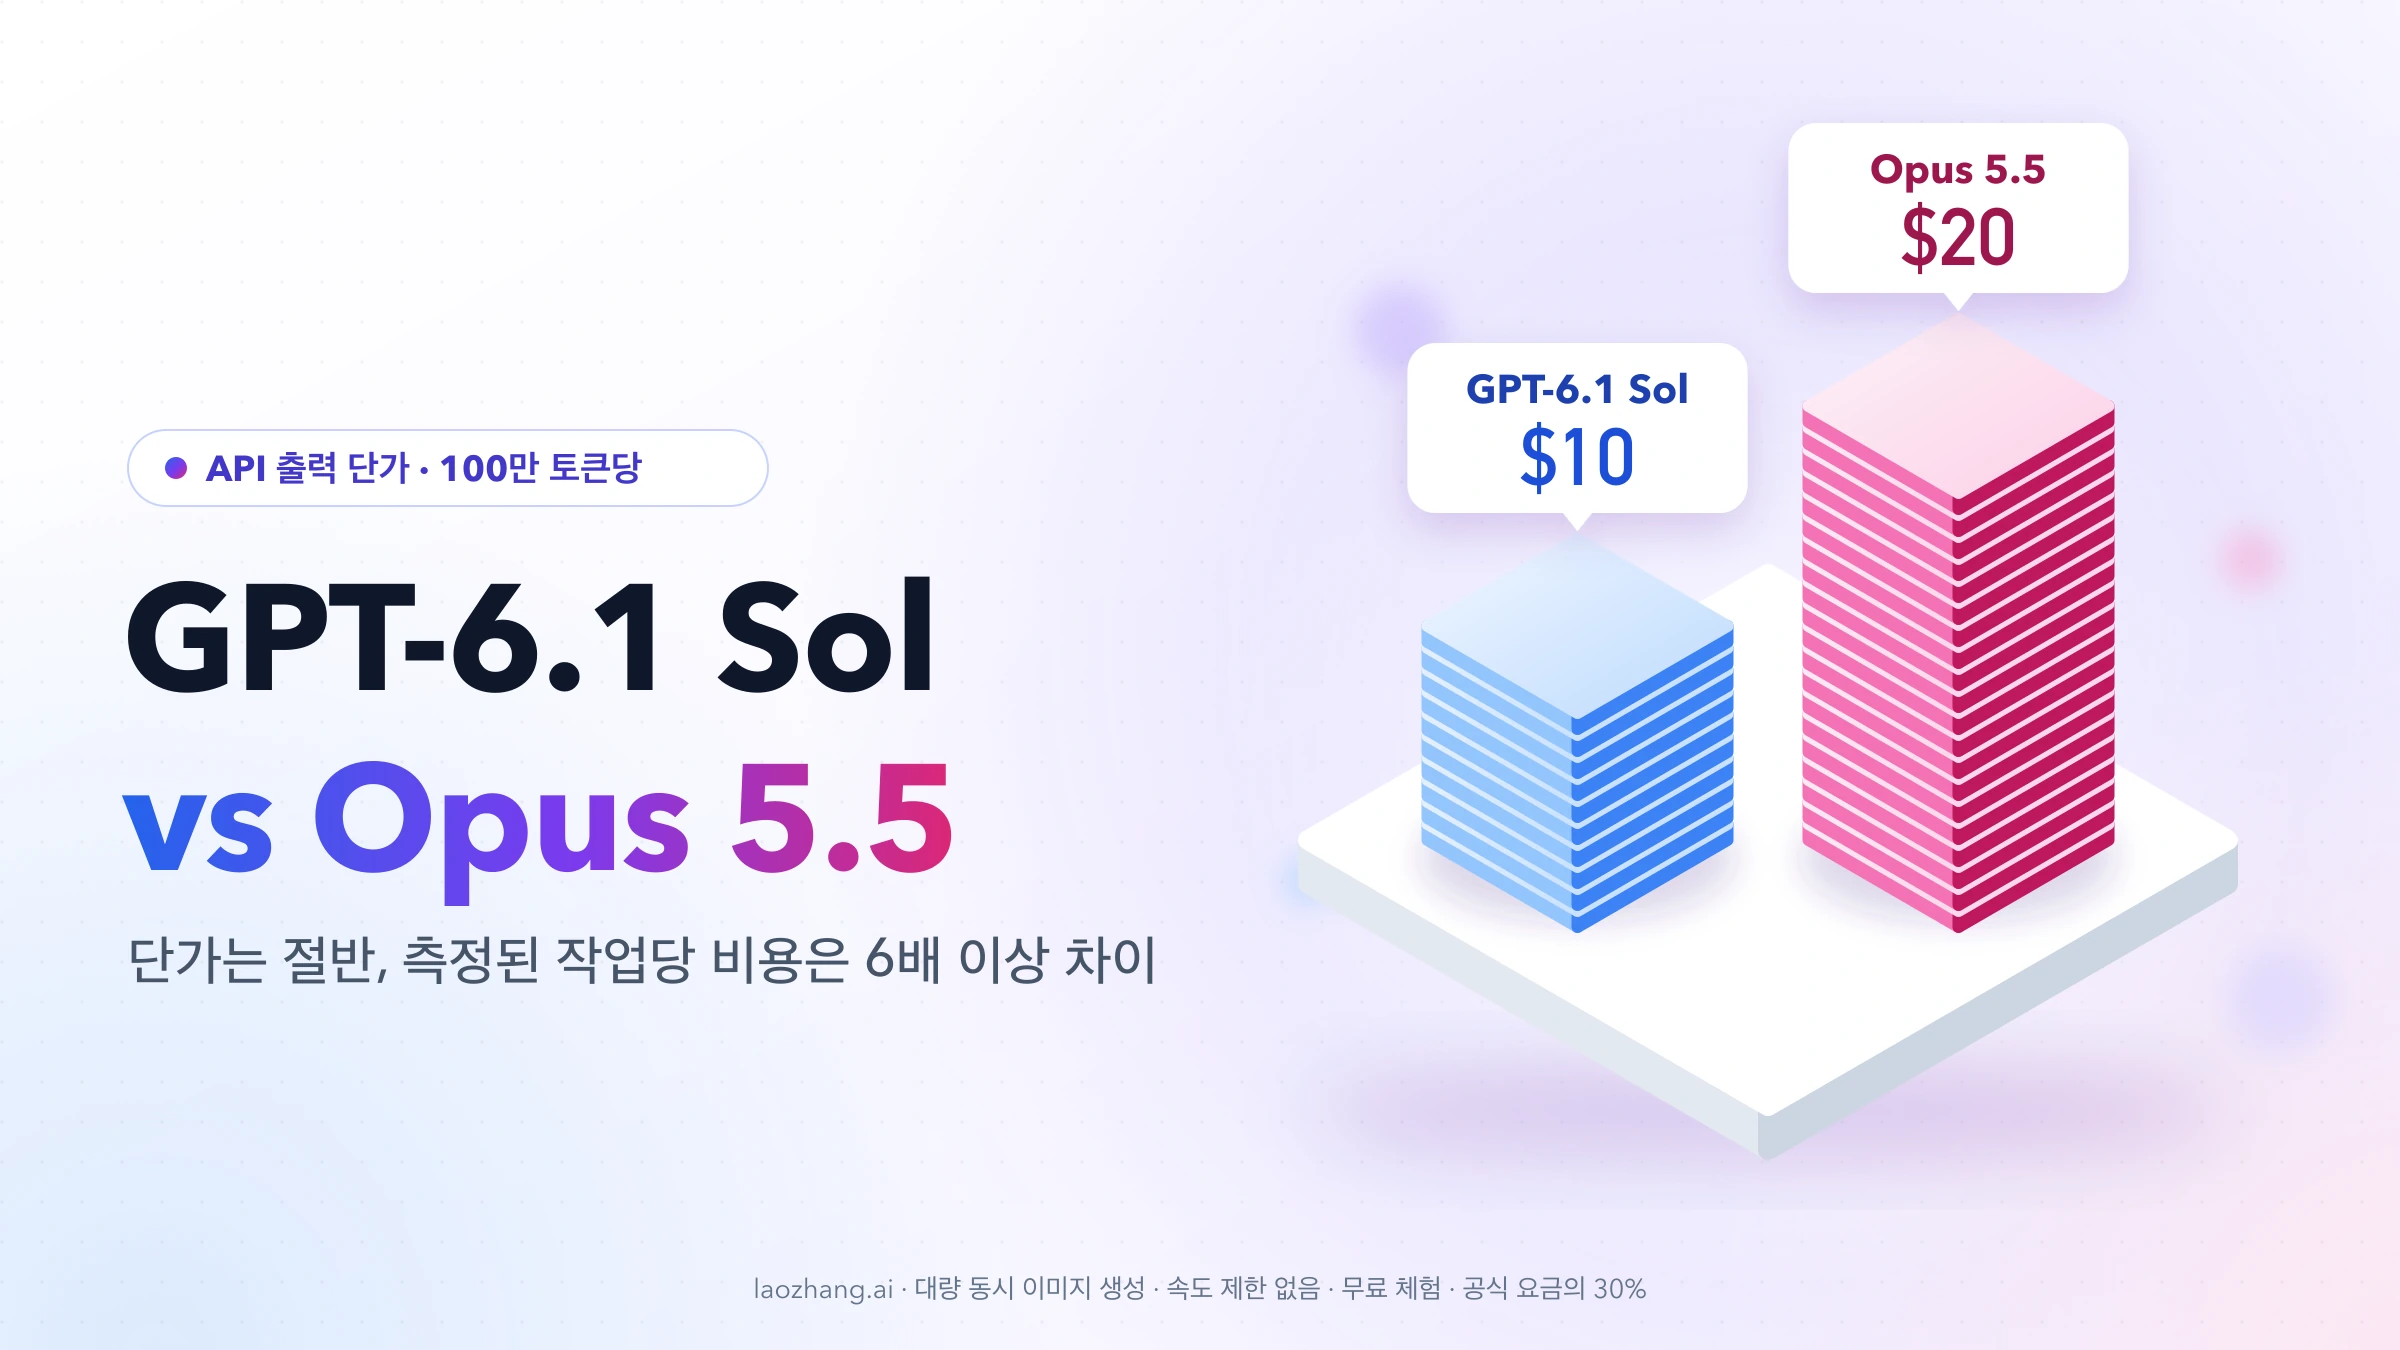
2026년 10월 10일 기준 GPT-6.1 Sol(gpt-6.1-sol)의 API 표준 단가는 입력 272K 토큰 이하 요청에서 Claude Opus 5.5(claude-opus-5-5)의 정확히 절반입니다. 실제로 쓰는 돈의 차이는 더 큽니다. Artificial Analysis 측정에서 Opus 5.5는 같은 과제에 출력 토큰을 약 3배 썼고, 작업당 비용은 두 모델의 기본 추론 강도인 medium에서 약 6.4배였습니다. 점수는 추론 강도 low에서 42점 동점이고, 강도를 올릴수록 Opus 5.5가 3~6점 앞섭니다.
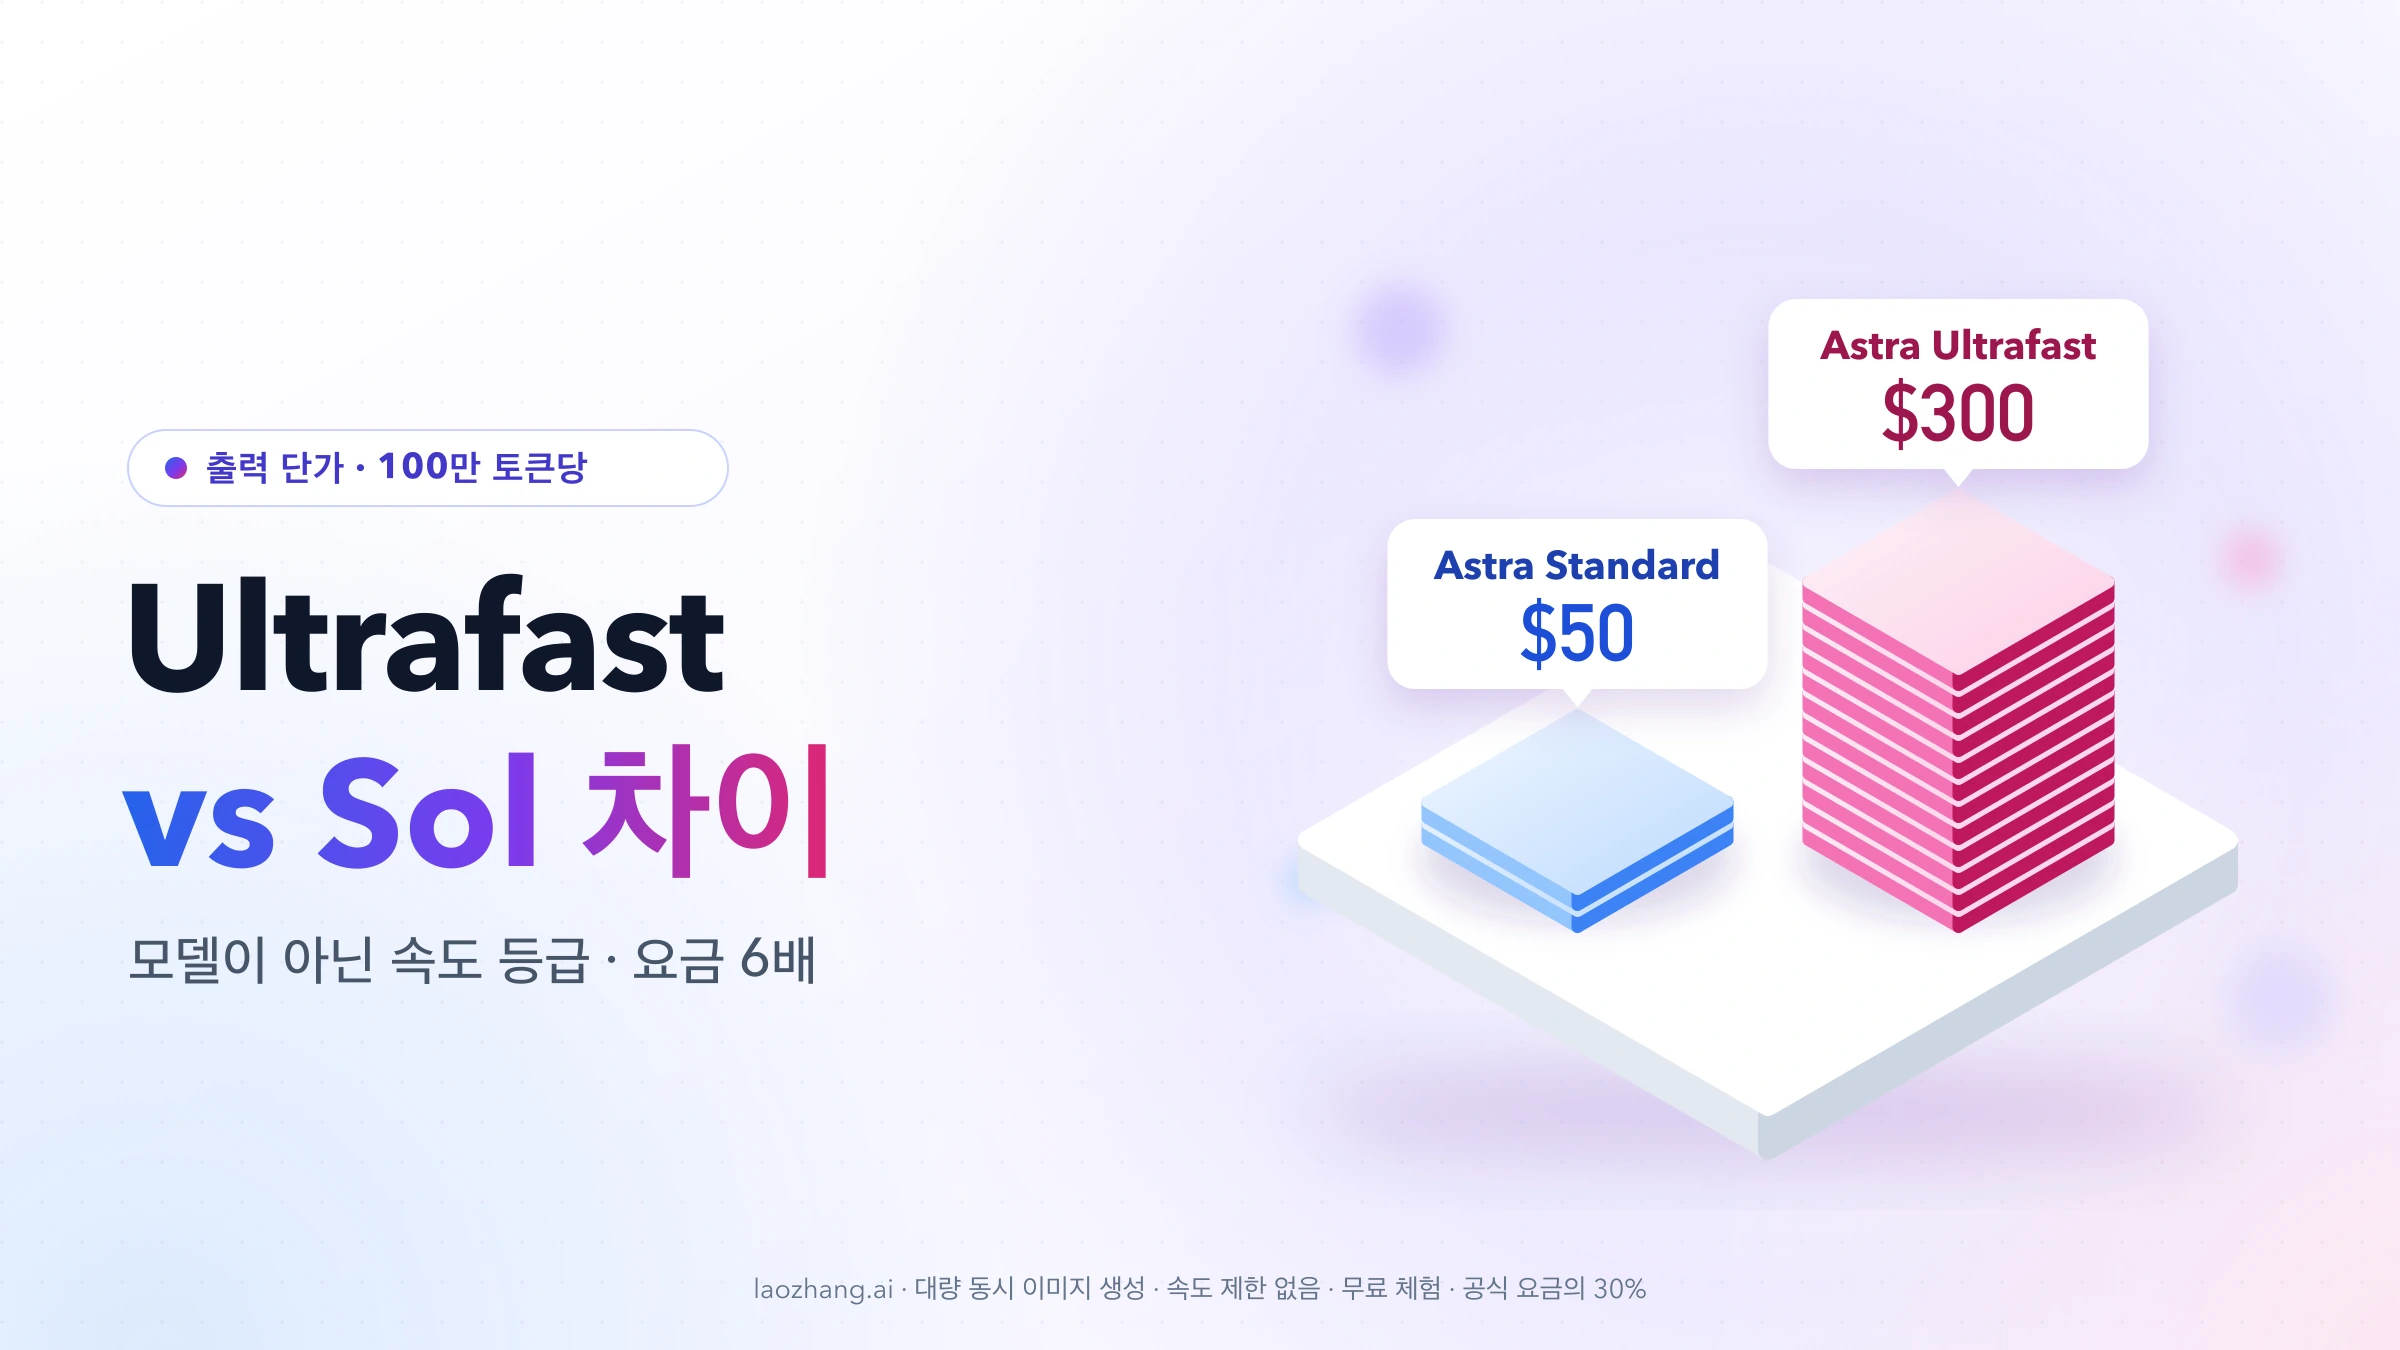
10월 8일부터는 비교할 속도 등급이 하나 늘었습니다. GPT-6.1 Sol Ultrafast는 100만 토큰당 입력 $12, 출력 $60로 Sol 표준의 6배입니다. 토큰 수가 같은 요청이라면 Opus 5.5 Fast mode($8/$40)의 1.5배, Opus 5.5 표준의 3배를 냅니다.
먼저 시험할 모델은 작업 형태로 정하면 됩니다.
- 호출량이 많은 코딩·자동화·문서 처리: GPT-6.1 Sol medium부터 시험합니다. 결과가 기준을 통과하면 비용 차이를 뒤집을 요인이 거의 없습니다.
- 최고 추론 강도로 돌리는 어려운 과제, 실패한 결과를 사람이 검수하는 작업: Opus 5.5를 유지한 채 두 모델의 통과율을 재고, 아래의 통과율 공식으로 정합니다.
- 응답 속도가 비용보다 중요한 대화형 작업: API에서는 Sol Ultrafast를 누구나 바로 켤 수 있고, Opus Fast mode는 대기자 명단이 있는 연구 프리뷰입니다. Codex에서 Ultrafast는 Pro $500 요금제와 조건을 충족한 Enterprise·Edu에서만 쓸 수 있습니다.
- 입력이 272K 토큰을 넘는 요청: 가격 차이가 1~7%로 줄어들므로 결과 품질로 고르면 됩니다.
GPT-6.1 Sol과 Opus 5.5 차이: 가격·점수·속도·이용 경로 요약
| 항목 | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
| 공개일 | 2026년 9월 29일(GPT-6 Sol의 개선판) | 2026년 9월 22일 |
| API 표준 단가(100만 토큰당 입력/출력) | $2 / $10(입력 272K 이하) | $4 / $20(1M까지 동일) |
| 컨텍스트 | 1,050,000토큰(최대 입력 922,000) | 1M 토큰 |
| 최대 출력 | 128K | 128K |
| 추론 강도 | low~max 5단계, 기본 medium | low~max 5단계, 기본 medium |
| Artificial Analysis 지수(medium / max) | 48 / 52 | 51 / 58 |
| Artificial Analysis 작업당 비용(medium / max) | $0.21 / $0.72 | $1.34 / $5.98 |
| 빠른 속도 등급 | Fast $4 / $20, Ultrafast $12 / $60 | Fast mode $8 / $40(연구 프리뷰) |
| 쓸 수 있는 곳 | OpenAI API, ChatGPT Work와 Codex(일반 채팅에는 없음) | Claude API, Amazon Bedrock, Google Cloud, Microsoft Foundry, Claude Platform on AWS, Claude 앱(Pro 이상), Claude Code |
GPT-6.1 Sol은 OpenAI API 변경 기록상 2026년 9월 29일에 나온 GPT-6 Sol의 개선판입니다. OpenAI는 발표문에서 가장 성능이 높은 모델은 여전히 GPT-6 Astra라고 밝혔고, GPT-6.1 Astra나 GPT-6.1 Luna는 없습니다. Claude Opus 5.5의 사양과 제공처는 Anthropic 모델 문서 기준이며, Opus 5(claude-opus-5)는 그 이전 세대입니다.
API 가격 비교: 입력 272K 토큰까지 Sol이 정확히 절반
각 사 직접 API의 100만 토큰당 달러 요금입니다. 세금, 지역 한정 처리 할증(OpenAI 데이터 레지던시 엔드포인트 +10%, Anthropic 미국 한정 추론 1.1배), 재판매 업체 가격은 넣지 않았습니다. 출처는 OpenAI 가격표와 Anthropic 가격표입니다.
| 항목 | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
| 입력 | $2 | $4 |
| 캐시 읽기(캐시 입력) | $0.10 | $0.20 |
| 캐시 쓰기 | $2.50 | $5(5분), $8(1시간) |
| 출력 | $10 | $20 |
| Batch 입력 / 출력 | $1 / $5 | $2 / $10 |
| 입력 272K 토큰 초과 요청 | 입력 $4, 캐시 입력 $0.20, 출력 $15 | 할증 없음 |
입력 10만 토큰, 출력 1만 토큰짜리 요청을 캐시 없이 한 번 보내면 GPT-6.1 Sol은 0.1 × $2 + 0.01 × $10 = $0.30, Opus 5.5는 0.1 × $4 + 0.01 × $20 = $0.60입니다. 두 모델 모두 캐시 읽기가 일반 입력보다 95% 싸서, 캐시를 많이 쓰는 에이전트에서도 비율은 그대로 2배입니다.
토큰 수 자체도 같지 않다는 점은 따로 기억해 둘 만합니다. Anthropic은 Claude 4.7 이후 모델의 토크나이저가 이전 Claude 토크나이저보다 같은 글에서 토큰을 약 30% 더 만든다고 밝히고 있고, OpenAI 토크나이저와 직접 비교한 비율은 공개된 자료가 없습니다. 같은 문서를 넣었을 때의 실제 비용은 각 API 응답의 usage 필드로 재야 합니다.
272K 초과부터 최대 입력 92만 토큰까지: 차이 1~7%
GPT-6.1 Sol은 한 요청의 입력이 272K 토큰을 넘으면 그 요청 전체에 입력·캐시 요금 2배, 출력 요금 1.5배를 적용합니다. 정확히 272,000토큰까지는 일반 요금입니다. Opus 5.5는 1M 컨텍스트 전체가 같은 단가입니다. 캐시 없는 요청으로 경계 양쪽을 계산하면 다음과 같습니다.
| 입력 + 출력 토큰 | GPT-6.1 Sol | Opus 5.5 | Sol이 싼 정도 |
|---|---|---|---|
| 272,000 + 20,000 | 0.272 × $2 + 0.02 × $10 = $0.744 | 0.272 × $4 + 0.02 × $20 = $1.488 | 50% |
| 273,000 + 20,000 | 0.273 × $4 + 0.02 × $15 = $1.392 | 0.273 × $4 + 0.02 × $20 = $1.492 | 약 7% |
| 300,000 + 20,000 | 0.3 × $4 + 0.02 × $15 = $1.50 | 0.3 × $4 + 0.02 × $20 = $1.60 | 약 6% |
| 900,000 + 10,000 | 0.9 × $4 + 0.01 × $15 = $3.75 | 0.9 × $4 + 0.01 × $20 = $3.80 | 약 1% |
입력이 1,000토큰 늘었을 뿐인데 Sol의 요청 비용은 $0.744에서 $1.392로 87% 오릅니다. 경계 위에서는 입력 단가가 $4로 같아지고 출력만 $15 대 $20로 남습니다. Sol의 최대 입력은 922,000토큰이므로 90만 토큰대 문서는 한 요청에 들어가지만 가격 이점은 거의 없습니다. 긴 문서를 다루는 파이프라인이라면 요청을 272K 이하로 나눌 수 있는지가 Sol 쪽 비용을 좌우합니다.
속도 등급 비교: Sol Ultrafast 요금은 Opus Fast mode의 1.5배
Ultrafast와 Fast mode는 별도 모델이 아니라 같은 모델을 더 빠른 설정으로 돌리는 속도 등급입니다. GPT-6.1 Sol은 Responses API에서 service_tier: "ultrafast" 또는 "fast"를 지정하고, Opus 5.5는 fast-mode-2026-02-01 베타 헤더와 speed: "fast"를 붙입니다. OpenAI와 Anthropic 모두 모델의 지능은 그대로라고 설명합니다.
| 속도 등급(입력 272K 이하) | 입력 | 캐시 읽기 | 출력 | 표준 대비 요금 | 공급사가 밝힌 속도 |
|---|---|---|---|---|---|
| GPT-6.1 Sol 표준 | $2 | $0.10 | $10 | 1배 | — |
| GPT-6.1 Sol Fast | $4 | $0.20 | $20 | 2배 | — |
| GPT-6.1 Sol Ultrafast | $12 | $0.60 | $60 | 6배 | 출력 토큰 생성 최대 8배 |
| Opus 5.5 표준 | $4 | $0.20 | $20 | 1배 | — |
| Opus 5.5 Fast mode | $8 | $0.40 | $40 | 2배 | 초당 출력 토큰 최대 2.5배 |
Sol Ultrafast의 272K 초과 요청은 $24 / $1.20 / $90, 캐시 쓰기는 $15(초과 시 $30)입니다. Opus Fast mode의 캐시 읽기 $0.40은 가격표에 따로 적힌 값이 아니라 "캐시 배수는 Fast mode 요금 위에 적용된다"는 문서 규칙대로 $8에 0.05를 곱한 값입니다. Opus Fast mode는 1M 컨텍스트 전체에 같은 2배가 붙습니다.
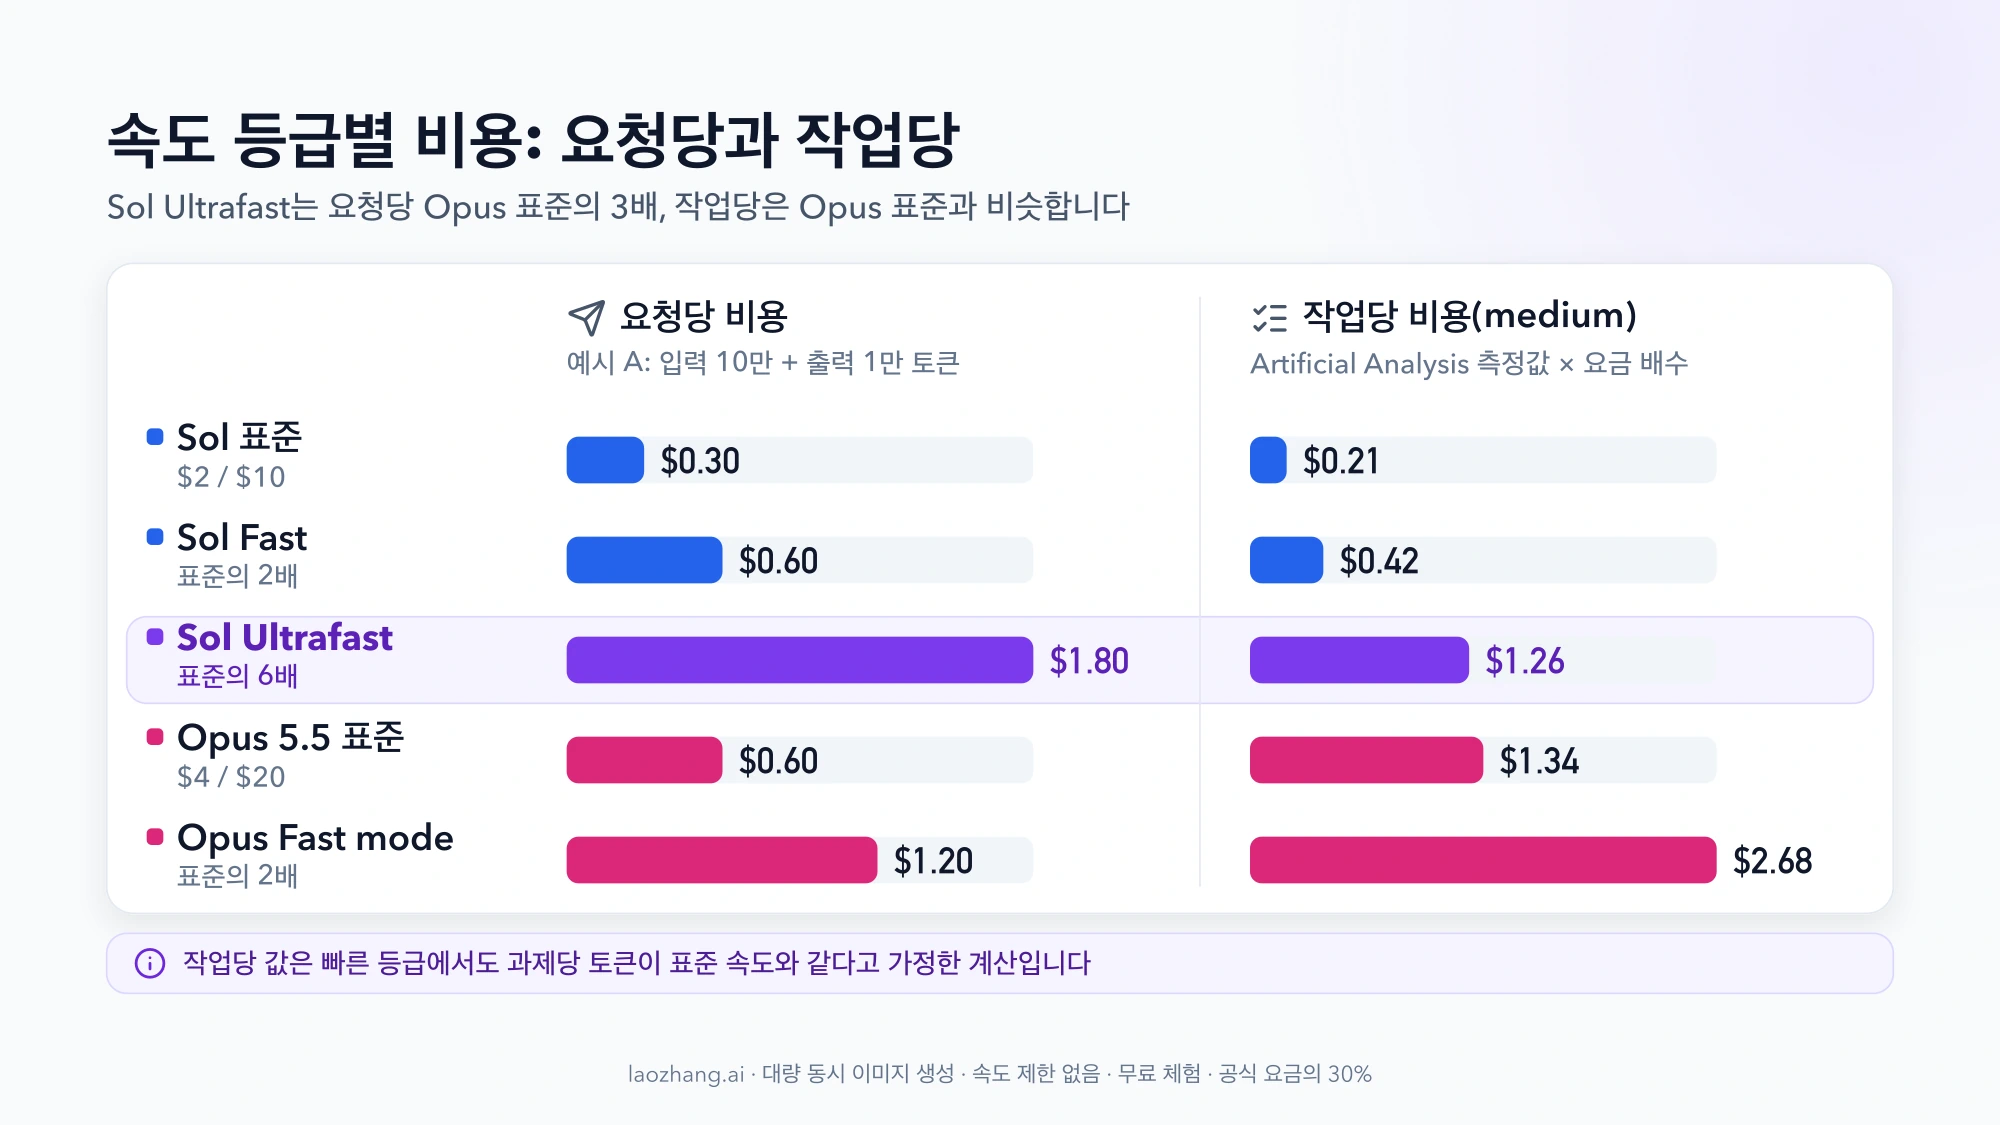
Sol Ultrafast 비용: 요청당 Opus 표준의 3배, 작업당은 비슷
아래 표는 토큰 수가 같다고 놓고 두 가지 요청의 비용을 계산한 값입니다(입력 272K 이하, 캐시 쓰기 비용 제외).
| 속도 등급 | A: 입력 10만 + 출력 1만 | B: 새 입력 5만 + 캐시 입력 20만 + 출력 1만 |
|---|---|---|
| GPT-6.1 Sol 표준 | $0.30 | $0.22 |
| GPT-6.1 Sol Fast | $0.60 | $0.44 |
| GPT-6.1 Sol Ultrafast | 0.1 × $12 + 0.01 × $60 = $1.80 | 0.05 × $12 + 0.2 × $0.60 + 0.01 × $60 = $1.32 |
| Opus 5.5 표준 | $0.60 | $0.44 |
| Opus 5.5 Fast mode | 0.1 × $8 + 0.01 × $40 = $1.20 | 0.05 × $8 + 0.2 × $0.40 + 0.01 × $40 = $0.88 |
두 경우 모두 Sol Fast는 Opus 표준과 같은 값이고, Sol Ultrafast는 Opus Fast mode의 1.5배, Opus 표준의 3배입니다.
그런데 두 모델은 같은 과제에 쓰는 토큰 수가 다릅니다. 속도 등급은 모델의 동작을 바꾸지 않으므로, 과제당 토큰이 표준 속도와 같다고 가정하고 Artificial Analysis의 작업당 비용에 등급별 배수를 곱하면 그림이 달라집니다.
| 작업당 비용 환산 | medium | max |
|---|---|---|
| GPT-6.1 Sol 표준 | $0.21 | $0.72 |
| GPT-6.1 Sol Fast(×2) | $0.42 | $1.44 |
| GPT-6.1 Sol Ultrafast(×6) | $1.26 | $4.32 |
| Opus 5.5 표준 | $1.34 | $5.98 |
| Opus 5.5 Fast mode(×2) | $2.68 | $11.96 |
작업 하나로 보면 Sol Ultrafast는 Opus 5.5 표준과 비슷하거나 조금 싸고, Opus Fast mode의 절반 아래입니다. Artificial Analysis는 빠른 등급을 따로 측정하지 않았으므로 이 표는 측정값이 아니라 표준 속도 측정값에 정가 배수를 곱한 계산입니다.
Sol Ultrafast와 Opus Fast mode를 쓸 수 있는 조건
가격보다 먼저 갈리는 것은 이용 조건입니다.
| 조건 | GPT-6.1 Sol Ultrafast | Opus 5.5 Fast mode |
|---|---|---|
| API 접근 | 모든 API 사용자, 표준과 별도 한도(TPM: Build 1M, Launch 4M, Grow 40M) | 연구 프리뷰. 계정 담당자에게 요청하거나 대기자 명단 신청 |
| 플랫폼 | Responses API 전용, 미국·EU 데이터 레지던시 지원 | Claude API(Managed Agents 포함) 전용. Bedrock, Google Cloud, Microsoft Foundry, Claude Platform on AWS 불가, Batch 불가 |
| 코딩 도구 | Codex·ChatGPT Work는 Pro $500과 조건을 충족한 Enterprise·Edu만. 포함 사용량은 표준의 8배 속도로, 크레딧은 6배로 차감 | Claude Code /fast: Pro·Max·Team·Enterprise에서 사용량 크레딧(usage credits)으로만 과금, 요금제 한도는 쓰지 않음 |
| 주의할 점 | OpenAI는 지연 이점을 지키려면 WebSocket 연결을 권장 | 표준과 Fast 사이를 오가면 프롬프트 캐시를 공유하지 않음 |
ChatGPT 속도 설정 문서는 다른 셀프서비스 요금제에서는 크레딧을 구매해도 Ultrafast를 쓸 수 없다고 적고 있습니다. Claude Code 쪽 조건은 Claude Code fast mode 문서에 있습니다. Ultrafast의 요청 방법과 GPT-6 Astra Ultrafast까지 포함한 비교는 OpenAI Ultrafast vs Sol 차이: 모델이 아닌 속도 등급, 요금 6배에서 다룹니다.
빠른 등급으로 몇 초 줄어드는지는 아직 계산할 수 없습니다
"최대 8배"와 "최대 2.5배"는 각 모델의 표준 속도를 기준으로 공급사가 밝힌 최대치입니다. 출발점이 다르므로 두 숫자를 나란히 놓고 어느 쪽이 빠르다고 말할 수 없고, Sol Ultrafast나 Opus Fast mode의 초당 토큰을 실측해 공개한 자료도 2026년 10월 10일 기준 없습니다.
표준 속도에서는 지표마다 앞서는 쪽이 다릅니다. Artificial Analysis 측정에서 초당 출력 토큰은 Opus 5.5가 빠르고(medium 79.2 대 52.4, max 97.0 대 59.3), 첫 답변 토큰이 나오기까지의 시간은 medium에서 Sol이 짧습니다(5.93초 대 21.89초). Anthropic은 Fast mode의 이점이 첫 토큰까지의 시간이 아니라 초당 출력 토큰에 있다고 밝히고 있으므로, 같은 측정에서 Opus 5.5의 첫 답변 토큰까지 시간은 low 8.7초, medium 21.9초였습니다. 첫 응답이 늦어서 답답한 경우라면 Opus Fast mode보다 추론 강도를 낮추는 쪽이 효과가 큽니다.
6.1 Sol 벤치마크: 추론 강도 5단계별 점수와 작업당 비용
두 모델을 다섯 추론 강도 모두에서 같은 방식으로 잰 자료로는 Artificial Analysis Intelligence Index가 있습니다. 2026년 10월 10일 기준 릴리스 비교 페이지의 값입니다.
| 추론 강도 | 지수(Sol / Opus 5.5) | 작업당 비용(Sol / Opus 5.5) | 비용 배수 | 첫 답변 토큰까지(Sol / Opus 5.5) |
|---|---|---|---|---|
| low | 42 / 42 | $0.13 / $0.55 | 4.2배 | 3.0초 / 8.7초 |
| medium | 48 / 51 | $0.21 / $1.34 | 6.4배 | 5.9초 / 21.9초 |
| high | 50 / 54 | $0.32 / $1.82 | 5.7배 | 62.3초 / 39.6초 |
| xhigh | 51 / 56 | $0.39 / $3.46 | 8.9배 | 173.7초 / 127.9초 |
| max | 52 / 58 | $0.72 / $5.98 | 8.3배 | 309.0초 / 704.2초 |
점수 차이는 low에서 0점으로 시작해 강도를 올릴수록 3, 4, 5, 6점으로 벌어집니다. 강도를 섞어서 보면 다른 선택지도 보입니다.
- Sol xhigh(51점, $0.39)는 Opus 5.5 medium(51점, $1.34)과 같은 점수를 작업당 약 3.4분의 1 비용으로 냅니다. 대신 첫 답변 토큰까지 173.7초가 걸려 Opus medium의 21.9초보다 훨씬 늦습니다.
- Sol max(52점, $0.72)는 Opus medium보다 1점 높고 비용은 54% 수준입니다.
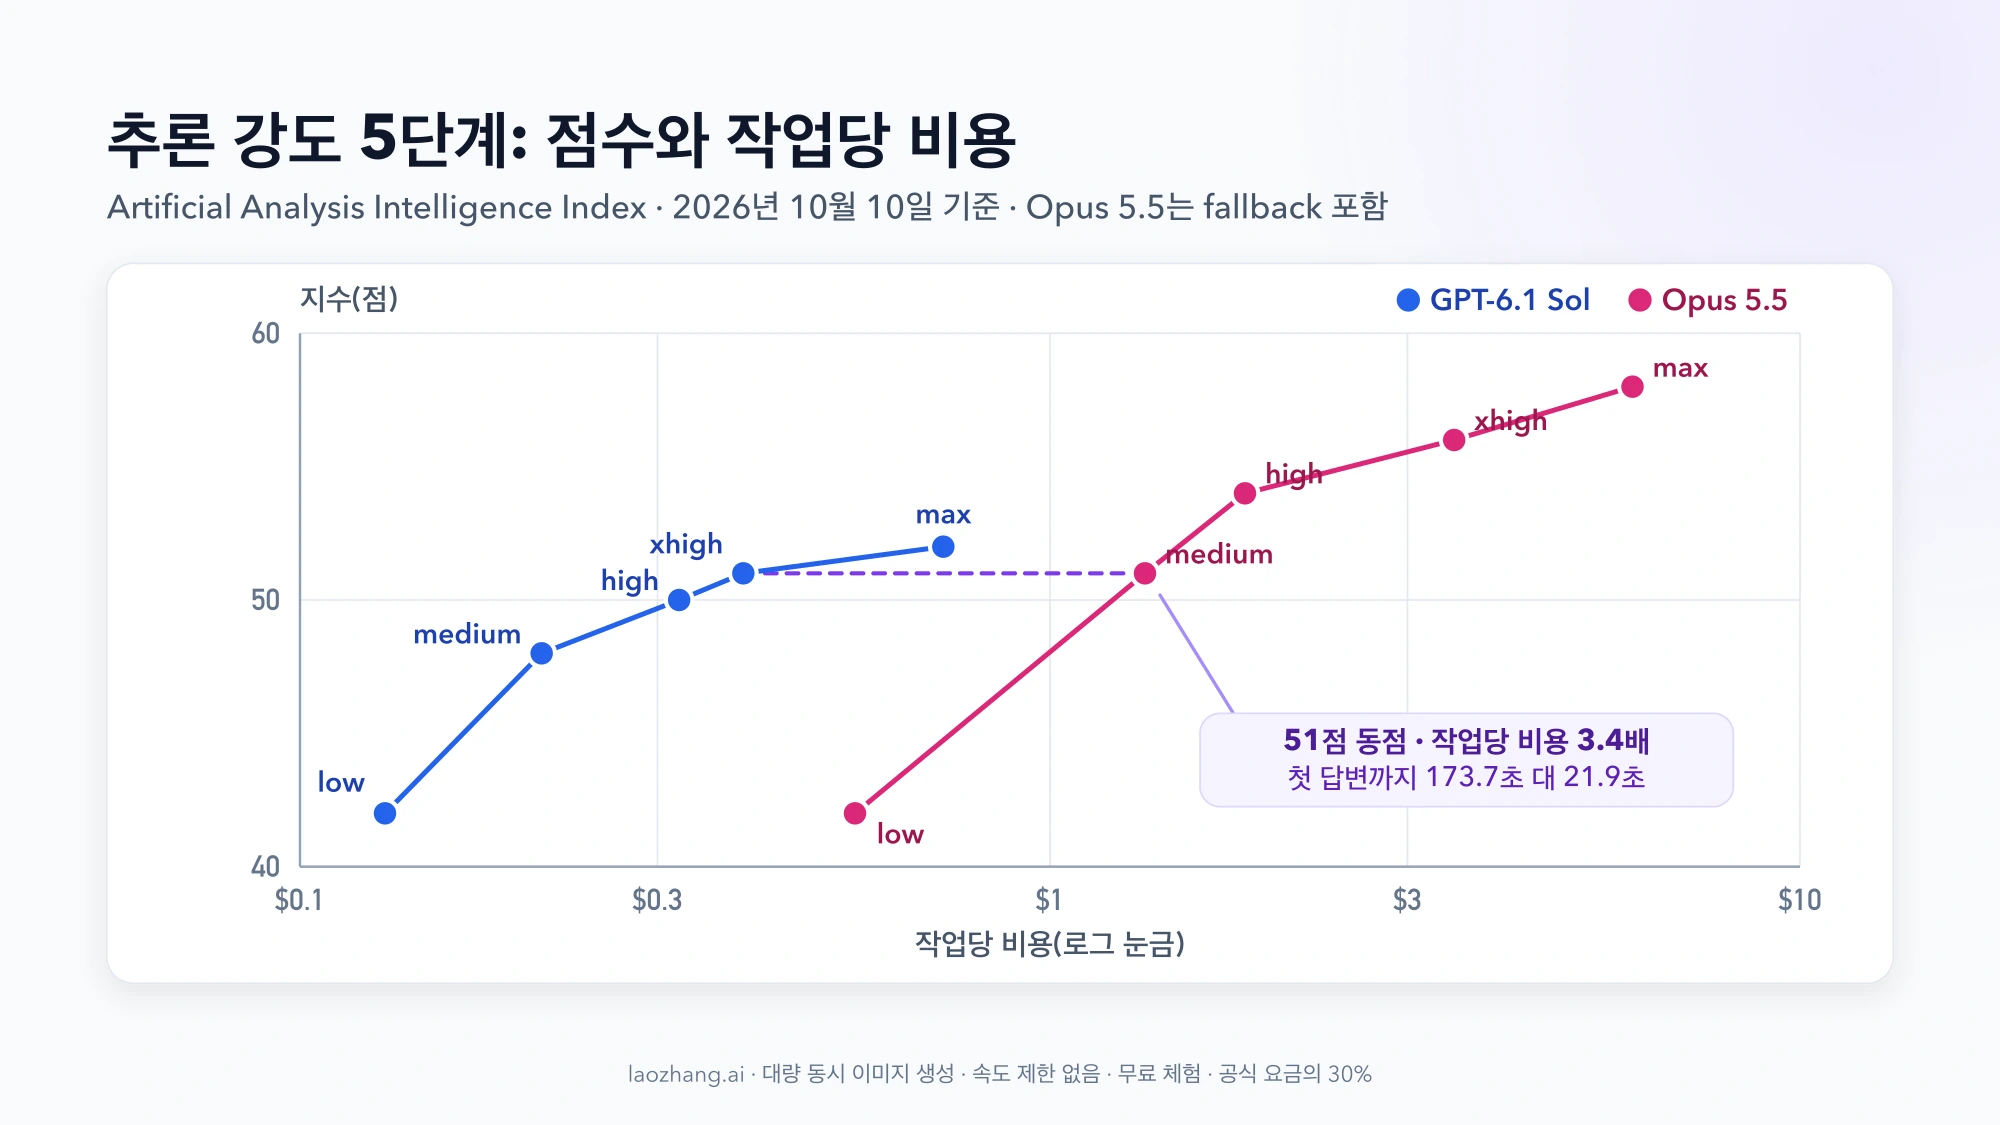
결국 "Sol을 높은 강도로 돌릴지, Opus를 낮은 강도로 돌릴지"는 점수보다 응답 시간을 얼마나 참을 수 있는지로 갈립니다. Opus 5.5의 강도별 선택 기준은 Claude Opus 5.5 effort 설정: 다섯 단계 중 어디서 시작할까?에 정리되어 있습니다.
단가 차이가 2배인데 작업당 비용이 49배로 벌어지는 이유는 출력량입니다. medium 비교에서 작업당 출력 토큰은 Sol 8k 대 Opus 5.5 26k(그중 추론 토큰 3k 대 12k), max에서는 38k 대 119k로 Opus가 약 3.13.3배 많습니다. 출력 단가 2배에 출력량 약 3배가 겹친 결과입니다. 같은 사이트의 "지수 전체 실행 비용"은 medium $361 대 $1,627(약 4.5배), max $1,082 대 $8,708(약 8.0배)로 작업당 비용과 배수가 다르니, 인용할 때 어느 지표인지 밝혀야 합니다.
코딩만 보고 싶다면 같은 측정의 Terminal-Bench 4.0이 참고가 됩니다. Sol은 medium 48.0%, max 56.1%, Opus 5.5는 medium 52.5%, max 59.6%입니다.
Vals와 OpenAI 발표 수치: 측정 주체에 따라 순위가 바뀝니다
| 평가 | 설정 | GPT-6.1 Sol | Opus 5.5 | 측정 주체 |
|---|---|---|---|---|
| Vals Index v2.1(10월 7일 갱신) | 설정 표기 없음 | 61.15%, 테스트당 $3.24 | 66.97%, 테스트당 $32.14 | Vals |
| GDP.pdf | high | 32.0%, $0.35 | 28.8%, $0.83 | OpenAI 발표 |
| AutomationBench 1.0.6 | medium | 31.7%, $0.19 | 29.5%, $0.65 | OpenAI 발표 |
| AutomationBench 1.0.6 | max | 36.1%, $0.30 | 42.5%, $1.44 | OpenAI 발표 |
| Terminal-Bench Science 0.1 | max | 57.0%, $5.47 | 63.3%, $23.21 | OpenAI 발표 |
Vals Index에서는 Opus 5.5가 5.82%p 높고 테스트당 비용은 약 9.9배, 소요 시간은 1시간 19분 대 43분 10초입니다. OpenAI가 고른 평가에서는 medium과 high 설정에서 Sol이 앞서지만, max 설정에서는 OpenAI 자신의 차트에서도 Opus 5.5가 높습니다. OpenAI는 GPT 쪽 점수를 자체 환경이나 API에서 돌렸고 경쟁 모델 점수는 공개 보고에서 가져왔다고 각주에 적었습니다. Anthropic의 Opus 5.5 발표 표(Terminal-Bench 4.0 66.4% 등)에는 GPT-6.1 Sol 행이 없어서, 두 회사 자료에서 같은 버전의 벤치마크로 두 모델을 직접 비교할 수 있는 항목은 없습니다.
정리하면 중간 강도에서는 격차가 작거나 평가에 따라 Sol이 앞서고, 최고 강도에서는 Opus 5.5가 일관되게 높되 작업당 비용이 4~8배 듭니다.
Opus 5.5 점수의 fallback 표기: 다른 Claude 모델이 처리한 분량 포함
Artificial Analysis는 Opus 5.5 행에 "Default Fallback"을, OpenAI는 "with fallback"을 붙입니다. Opus 5.5의 안전 분류기가 요청을 거부했을 때 다른 Claude 모델이 대신 처리한 결과가 점수와 비용에 섞여 있다는 뜻입니다. Anthropic 문서에 따르면 거부는 오류가 아니라 HTTP 200 응답과 stop_reason: "refusal"로 돌아오고, 베타 헤더 server-side-fallback-2026-07-01과 fallbacks: "default"를 설정하면 API가 Anthropic이 권장하는 다른 모델로 다시 시도합니다.
- Vals는 fallback이 처리한 과제를 실패로 치면 Opus 5.5가 66.97%에서 65.05%로 내려간다고 밝혔습니다. Sol과의 차이는 5.82%p에서 3.90%p로 줄어듭니다.
- 요금은 각 시도를 실제로 실행한 모델의 단가로 청구됩니다. 출력 전에 거부된 요청은
bio,frontier_llm,reasoning_extraction유형만 과금되지만, 모든 시도가 속도 한도에는 잡힙니다. - Anthropic은 사이버 보안 과제 대부분을 Opus 4.8로 넘긴다고 밝혔습니다. 보안 관련 작업이 많다면 Opus 5.5를 지정해도 다른 모델의 답을 받는 비중이 커집니다.
기본 모델을 바꿀지 계산하기: 통과율과 검수 비용 공식
싼 모델이 더 자주 실패하면 재시도와 검수 비용이 절감액을 넘을 수 있습니다. 한 번 시도하는 토큰 비용을 c, 결과가 기준을 통과할 확률을 p, 시도마다 사람이 검수하는 비용을 R이라고 하면 다음과 같습니다.
통과 결과 1건의 기대 비용 = (c + R) ÷ p

Opus 5.5가 더 싼 조건:
p_opus ÷ p_sol  >  (c_opus + R) ÷ (c_sol + R)
통과할 때까지 독립적으로 다시 시도하고, 검수 시간이 두 모델에서 같다는 가정입니다. p와 R은 측정값이 아니라 자기 작업에서 재서 넣는 값입니다. 아래 예시에는 c로 Artificial Analysis medium 작업당 비용($0.21, $1.34)을 넣었습니다.
검수 없는 자동 파이프라인(R = 0): 필요한 통과율 비는 1.34 ÷ 0.21 ≈ 6.38입니다. Opus 5.5가 매번 통과해도 Sol의 통과율이 1 ÷ 6.38 ≈ 15.7%보다 낮을 때만 Opus 5.5가 쌉니다.
검수에 시도당 $5가 드는 경우(시간당 $60인 사람이 5분 확인한다고 가정): 필요한 비는 (1.34 + 5) ÷ (0.21 + 5) = 6.34 ÷ 5.21 ≈ 1.217입니다. Sol의 통과율이 70%라면 Opus 5.5는 85.2%를 넘어야 합니다.
| Sol 통과율 70%일 때 | Sol 기대 비용 | Opus 5.5 기대 비용 | 더 싼 쪽 |
|---|---|---|---|
| Opus 5.5 통과율 90% | 5.21 ÷ 0.7 = $7.44 | 6.34 ÷ 0.9 = $7.04 | Opus 5.5 |
| Opus 5.5 통과율 80% | 5.21 ÷ 0.7 = $7.44 | 6.34 ÷ 0.8 = $7.93 | GPT-6.1 Sol |
사람의 시간이 비쌀수록 토큰 가격 차이는 묻히고 통과율 차이가 결론을 정합니다. 빠른 등급을 쓸 계획이라면 c에 등급 배수를 곱해 넣으면 됩니다. 예를 들어 Sol Ultrafast medium은 c_sol = $1.26이 되어, R = 0일 때 필요한 비가 1.34 ÷ 1.26 ≈ 1.06으로 좁아집니다. Opus 5.5 표준의 통과율이 Sol Ultrafast보다 약 6%만 높아도 Opus 5.5 쪽이 싸진다는 뜻입니다. 실제 작업 수십 건을 두 모델에 같은 조건으로 돌려 통과 건수와 usage 필드의 비용을 기록하면 공식에 넣을 값이 나옵니다.
월 20달러 요금제·Codex·Claude Code에서는 횟수로 비교할 수 없습니다
구독으로 쓸 때는 두 회사가 공개한 정보의 형태가 달라 숫자로 맞대기 어렵습니다.
- ChatGPT: GPT-6.1 Sol은 Plus($20), Pro, Business, Enterprise, Edu의 ChatGPT Work와 Codex에서 쓸 수 있고, 일반 채팅(Chat)에는 없습니다. 10월 7일부터 채팅 탭에 들어간 모델은 유료 요금제의 GPT-6 Sol과 무료·Go(10월 8일부터)의 GPT-6 Luna입니다. 요금 안내는 Plus의 5시간당 로컬 메시지를 GPT-6.1 Sol 15~160회로 추정합니다. Pro는 $100, $200, $500 세 가지이고 Ultrafast는 Pro $500에만 들어갑니다.
- Pro 200 사용량 변경: OpenAI 도움말에 따르면 새로 가입하는 Pro 200은 이전보다 낮은 사용량이 적용되고 가격은 월 $200 그대로입니다. 9월 22일부터 9월 29일 오전 10시(태평양 시간) 사이에 구독 중이던 사용자는 10월 29일까지 이전 사용량을 유지합니다. 얼마나 줄었는지는 OpenAI가 숫자로 밝히지 않았습니다.
- Claude: Claude Pro는 월 $20(연간 결제 시 월 $17), Max는 $100부터이며 Pro 대비 5배 또는 20배 사용량입니다. Opus는 Pro와 Max에 포함되고 Claude Code는 모든 유료 요금제에 들어 있습니다. Opus 5.5의 메시지 수나 토큰 한도는 공개되어 있지 않습니다.
한쪽은 추정 범위, 다른 쪽은 숫자가 없으므로 "20달러로 몇 번"을 계산할 근거가 없습니다. 외부 추정으로는 SemiAnalysis가 에이전트 작업에서 Claude 요금제가 GPT-6.1 Sol 요금제보다 API 정가 환산 가치로 약 5배(다른 대목에서는 약 4배)를 준다고 분석했습니다. 다만 Opus 토큰은 정가가 2배라 환산 가치도 그만큼 커지므로 "5배 많은 작업"이라는 뜻은 아닙니다.
속도도 구독과 API가 다릅니다. OpenAI의 Tibo Sottiaux는 10월 5일 X 게시물에서 구독을 통한 GPT-6 Astra와 GPT-6.1 Sol의 기본 속도를 약 50% 높였다고 밝혔지만, API에 대해서는 언급하지 않았습니다. 평소 하는 작업 몇 개를 양쪽에서 돌려 5시간 한도가 얼마나 줄어드는지 직접 보는 방법이 가장 확실합니다. Plus에서 Work와 Codex를 쓰는 방법은 GPT-6 Astra 사용법: Plus는 Chat이 아닌 Work·Codex에서, Codex 크레딧 단가는 GPT-6 Luna와 Sol 가격 비교: API 요금과 Codex 크레딧, Max에 붙는 월 API 크레딧은 Claude Max API 크레딧 받는 법에 있습니다.
GPT-6.1 Sol이나 Opus 5.5로 옮길 때 막히는 설정
GPT-6 Sol에서 GPT-6.1 Sol로: 입력 $2, 출력 $10와 272K 규칙은 같고 캐시 입력만 $0.20에서 $0.10로 내려갑니다. gpt-6.1-sol은 추론 강도 low, medium(기본값), high, xhigh, max만 받고 none과 minimal은 지원하지 않습니다. 추론을 끄고 쓰던 호출은 모델 ID만 바꾸면 실패하므로 low 이상으로 바꾸고 지연 시간을 다시 재야 합니다. 도구 호출은 Responses API에서만 되고 Chat Completions에서는 도구 없이만 쓸 수 있습니다. API 사용 등급 이름도 10월 6일부터 Tier 1~5가 아니라 Build, Launch, Grow 세 단계입니다.
OpenAI 쪽에서 Claude Opus 5.5로: 적응형 사고(adaptive thinking)가 항상 켜져 있어 끌 수 없고, 특정 도구를 강제로 호출하게 하는 설정은 오류를 냅니다. 도구 호출 사이의 텍스트는 thinking 블록으로 오며 기본 표시 설정에서는 비어 있어서, 진행 상황을 사용자에게 보여 주던 앱은 display 값을 바꿔야 합니다. 이용 경로와 Opus 5에서 옮길 때의 점검 항목은 Claude Opus 5.5 이용 경로·실제 비용·Opus 5 이전 점검에서 이어집니다.
GPT-6.1 Sol vs Opus 5.5 자주 묻는 질문
GPT-6.1 Sol 가격은 Opus 5.5의 절반이 맞나요?
입력이 272K 토큰 이하인 표준 요청에서는 맞습니다. 입력 $2 대 $4, 출력 $10 대 $20, 캐시 읽기 $0.10 대 $0.20, 5분 캐시 쓰기 $2.50 대 $5로 모든 항목이 절반이고, Batch와 Fast 등급도 같은 비율입니다. 272K를 넘으면 입력 단가가 $4로 같아져 차이가 1~7%로 줄고, Sol Ultrafast는 Opus 5.5 표준의 3배입니다. 실제 청구액은 Opus 5.5의 출력량이 많아 절반보다 더 크게 벌어지는 경우가 많습니다(Artificial Analysis medium 작업당 약 6.4배).
"GPT 6.1"은 어떤 모델을 가리키나요?
GPT-6.1 Sol 하나입니다. API 모델 ID는 gpt-6.1-sol이고, "Sol 6.1"이라고 줄여 부르기도 합니다. 접미사 없는 GPT-6.1이나 GPT-6.1 Astra, GPT-6.1 Luna는 발표된 적이 없습니다. ChatGPT에서는 Work와 Codex에서만 고를 수 있고, 10월 7~8일 일반 채팅에 들어간 것은 GPT-6 Sol과 GPT-6 Luna입니다. 비교 상대인 Claude Opus 5.5도 Opus 5와는 다른 모델로, Opus 5는 그 이전 세대입니다.
GPT-6.1 Sol의 현재 가격은 프로모션 가격인가요?
아닙니다. 2026년 10월 10일 기준 OpenAI 가격표에서 GPT-6.1 Sol 요금에는 프로모션 표시가 없습니다. "최소 2026년 11월 21일까지"라는 프로모션 문구는 GPT-5.6 Sol 요금에 붙은 것입니다. 이전 세대와의 비교는 Claude Opus 5.5 vs GPT-5.6 Sol: 같은 단가, 다른 작업당 비용에 있습니다. 다만 현재 요금이 언제까지 유지되는지는 OpenAI와 Anthropic 모두 밝히지 않았습니다.
Opus 5.5와 GPT-6.1 Sol 말고 고려할 모델이 있나요?
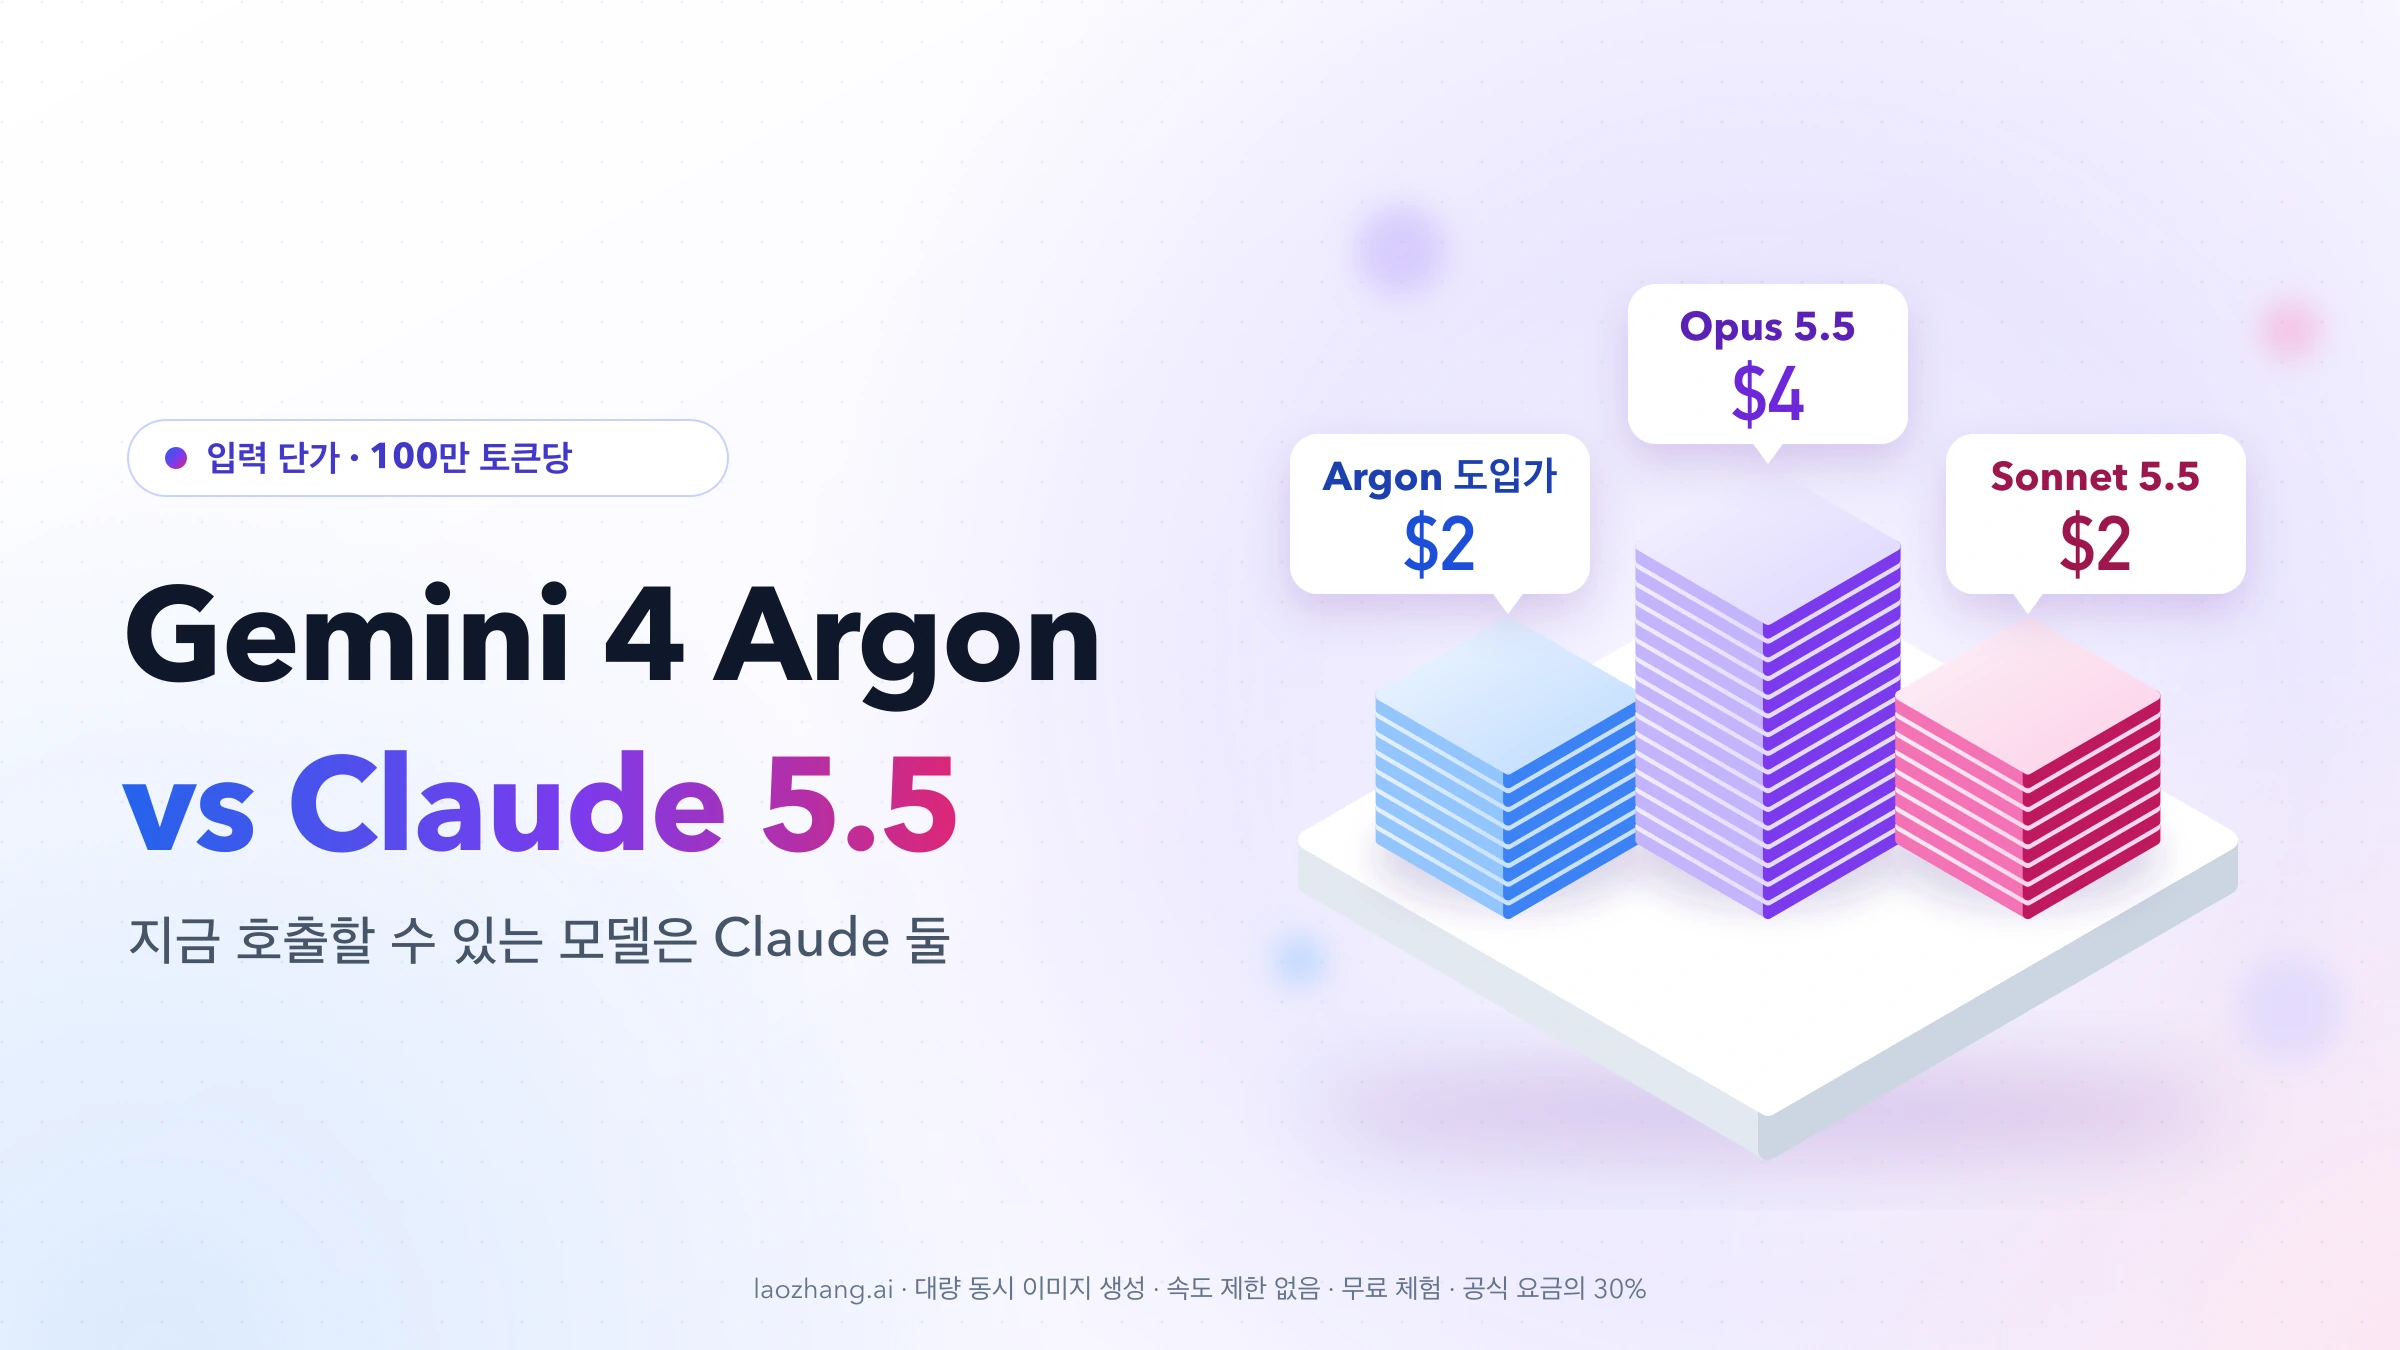
Claude 쪽에 남되 비용을 줄이고 싶다면 Claude Sonnet 5.5가 후보입니다. 단가가 입력 $2, 출력 $10로 Sol과 같고, Vals Index v2.1에서 67.04%로 Opus 5.5(66.97%)와 비슷한 점수를 냈습니다. OpenAI에서 가장 높은 성능이 필요하면 GPT-6 Astra($10 / $50), 속도가 필요하면 위의 Sol Ultrafast가 선택지입니다. Gemini 4 Argon까지 넣은 비교는 Gemini 4 Argon·Opus 5.5·Sonnet 5.5 선택 기준에서 볼 수 있습니다.