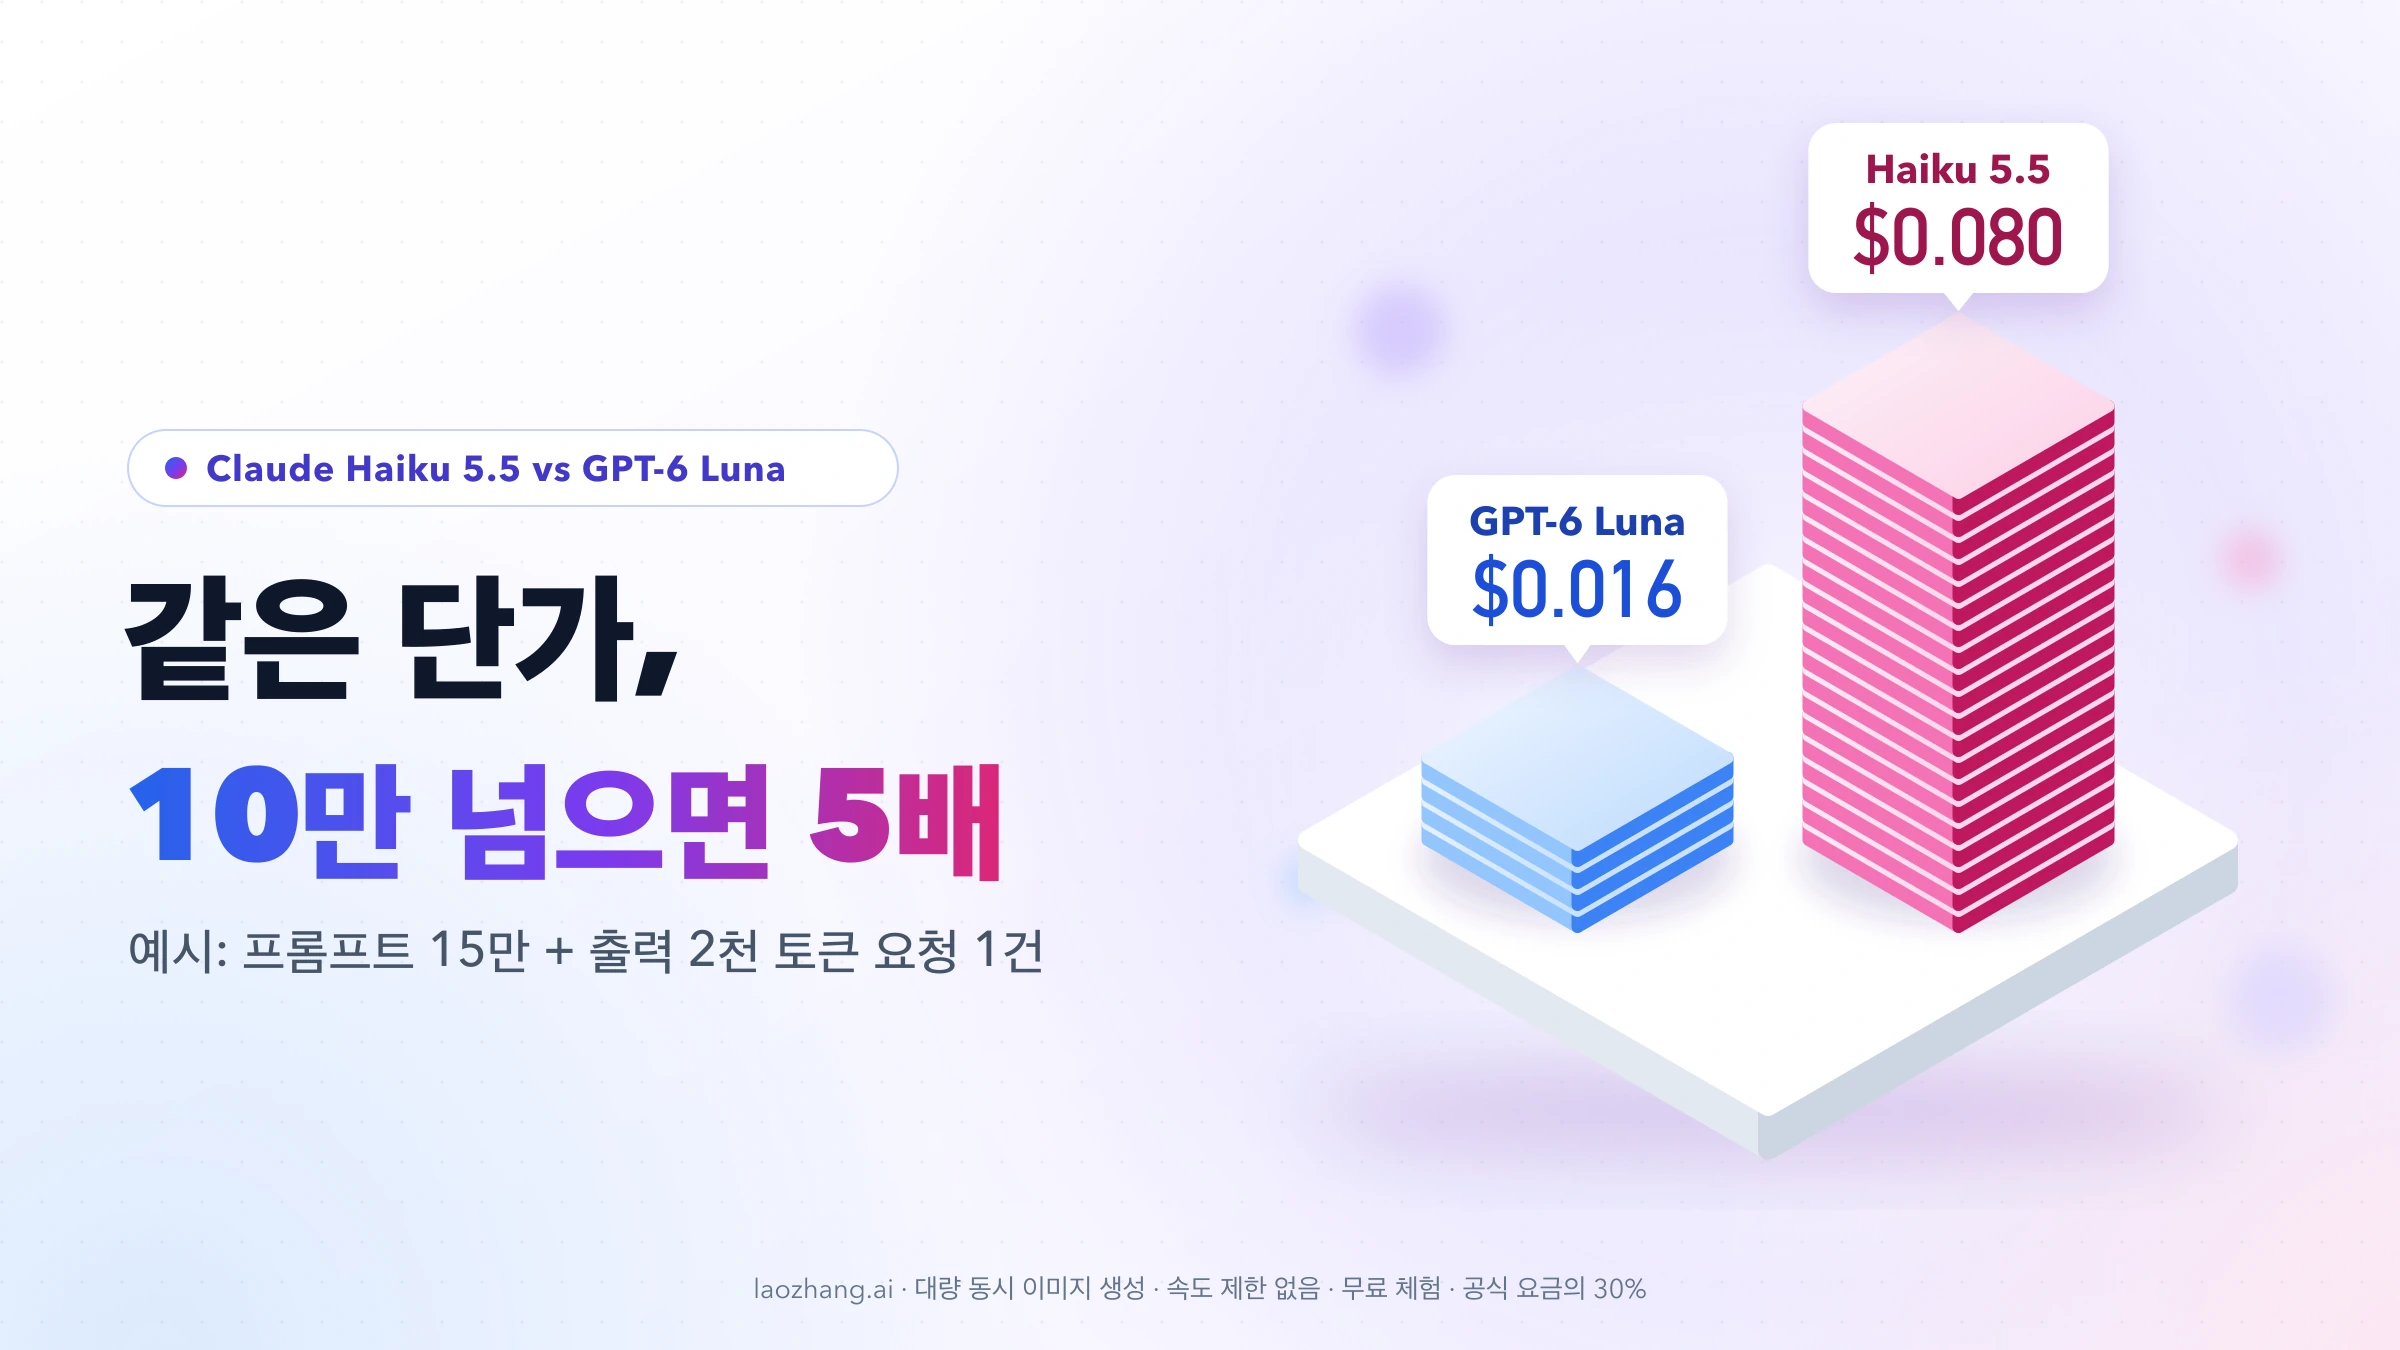
2026년 10월 8일 기준 공식 정가로 보면, 프롬프트가 10만 토큰 이하인 요청에서 Claude Haiku 5.5와 GPT-6 Luna의 토큰 단가는 완전히 같습니다. 100만 토큰당 입력 $0.10, 캐시 적중 $0.01, 캐시 쓰기 $0.125, 출력 $0.50입니다. 갈리는 지점은 그 위입니다. Haiku 5.5는 프롬프트가 10만 토큰을 넘는 요청이면 입력·캐시·출력 단가가 모두 5배가 되고, Luna는 입력 27만 2천 토큰까지 같은 요율을 유지합니다. Anthropic 가격표 · OpenAI 가격표
어느 쪽이 싼지는 트래픽 형태로 정해집니다.
- 요청이 늘 10만 토큰 아래인 분류·추출·라우팅: 단가로는 무승부입니다. 청구액은 같은 작업에 각 모델이 쓰는 토큰 수, 즉 출력·사고 토큰과 토크나이저 차이로 갈리므로 자기 샘플로 재 봐야 합니다.
- 긴 문서 RAG나 대화가 쌓이는 에이전트: 토큰 수가 같다면 Luna가 쌉니다. 10만~27만 2천 토큰 구간에서는 Luna가 정확히 5분의 1입니다. Haiku를 쓰려면 컨텍스트를 10만 토큰 아래로 묶어 두는 설계가 필요합니다.
- 품질을 맞춘 작업당 비용: 제3자 평가인 Artificial Analysis에서는 같은 effort 이름(Medium·High)끼리 비교하면 Haiku가 출력 토큰을 약 3배 써서 더 비쌌습니다. 반면 지수가 비슷한 조합끼리 맞추면 작업당 비용 차이가 거의 사라집니다.
Haiku 5.5·Luna 요금표: 10만 토큰까지 같은 $0.10/$0.50
아래는 Claude API와 OpenAI API를 직접 쓸 때의 Standard 정가입니다. 단위는 100만 토큰당 미국 달러이며 2026년 10월 8일 기준입니다. Haiku 5.5 가격은 2026년 10월 7일 출시 때 발표된 값입니다.
| 항목 | Haiku 5.5 프롬프트 10만 이하 | Haiku 5.5 프롬프트 10만 초과 | Luna 입력 27만 2천 이하 | Luna 입력 27만 2천 초과 |
|---|---|---|---|---|
| 입력 | $0.10 | $0.50 | $0.10 | $0.20 |
| 캐시 적중(캐시 입력) | $0.01 | $0.05 | $0.01 | $0.02 |
| 캐시 쓰기(Haiku는 5분 TTL) | $0.125 | $0.625 | $0.125 | $0.25 |
| 캐시 쓰기 1시간 TTL | $0.20 | $1.00 | 별도 항목 없음 | 별도 항목 없음 |
| 출력 | $0.50 | $2.50 | $0.50 | $0.75 |
| Batch 입력/출력 | $0.05 / $0.25 | $0.25 / $1.25 | $0.05 / $0.25 | $0.10 / $0.375 |
표를 읽을 때 놓치기 쉬운 규칙은 다음과 같습니다.
- 기준이 되는 숫자가 다릅니다. Anthropic은 "프롬프트 길이"가 10만 토큰을 넘으면 높은 요율을 매깁니다. 정확히 100,000토큰은 낮은 구간입니다. 가격표의 출력·캐시 행도 같은 프롬프트 길이 구간으로 나뉘어 있어서, 긴 프롬프트 요청은 출력까지 $2.50으로 계산됩니다. Haiku 5.5 장문맥 가격
- OpenAI는 입력 토큰 수가 기준입니다. 입력이 27만 2천 토큰을 넘으면 그 요청 전체에 입력·캐시 2배, 출력 1.5배가 적용됩니다. GPT-6 Luna 모델 페이지
- 캐시에서 읽은 토큰이 이 기준에 들어가는지는 두 회사 문서 모두 밝히지 않습니다. Anthropic의 컨텍스트 문서는
input_tokens,cache_read_input_tokens,cache_creation_input_tokens가 모두 컨텍스트 창에 포함된다고만 적고 있습니다. 예산을 잡을 때는 캐시 토큰까지 포함된다고 보는 편이 안전하며, 아래 계산도 같은 가정을 씁니다. 컨텍스트 창 문서 - 그 밖의 조정 요인: Haiku 5.5는
inference_geo: "us"로 미국 내 추론을 지정하면 모든 항목이 1.1배이고, Priority Tier와 Fast 모드를 지원하지 않습니다. Luna는 Flex가 Batch와 같은 절반 가격, Fast가 2배입니다.
컨텍스트 창 크기는 비교 기준이 되지 않습니다. Haiku 5.5는 100만 토큰, Luna는 105만 토큰(최대 입력 92만 2천)이고 최대 출력은 둘 다 12만 8천 토큰입니다. 긴 입력을 넣을 수 있느냐보다 넣었을 때 얼마를 내느냐가 문제입니다. Haiku 5.5 개요
요청 크기별 비용: 100,001토큰부터 Haiku가 5배
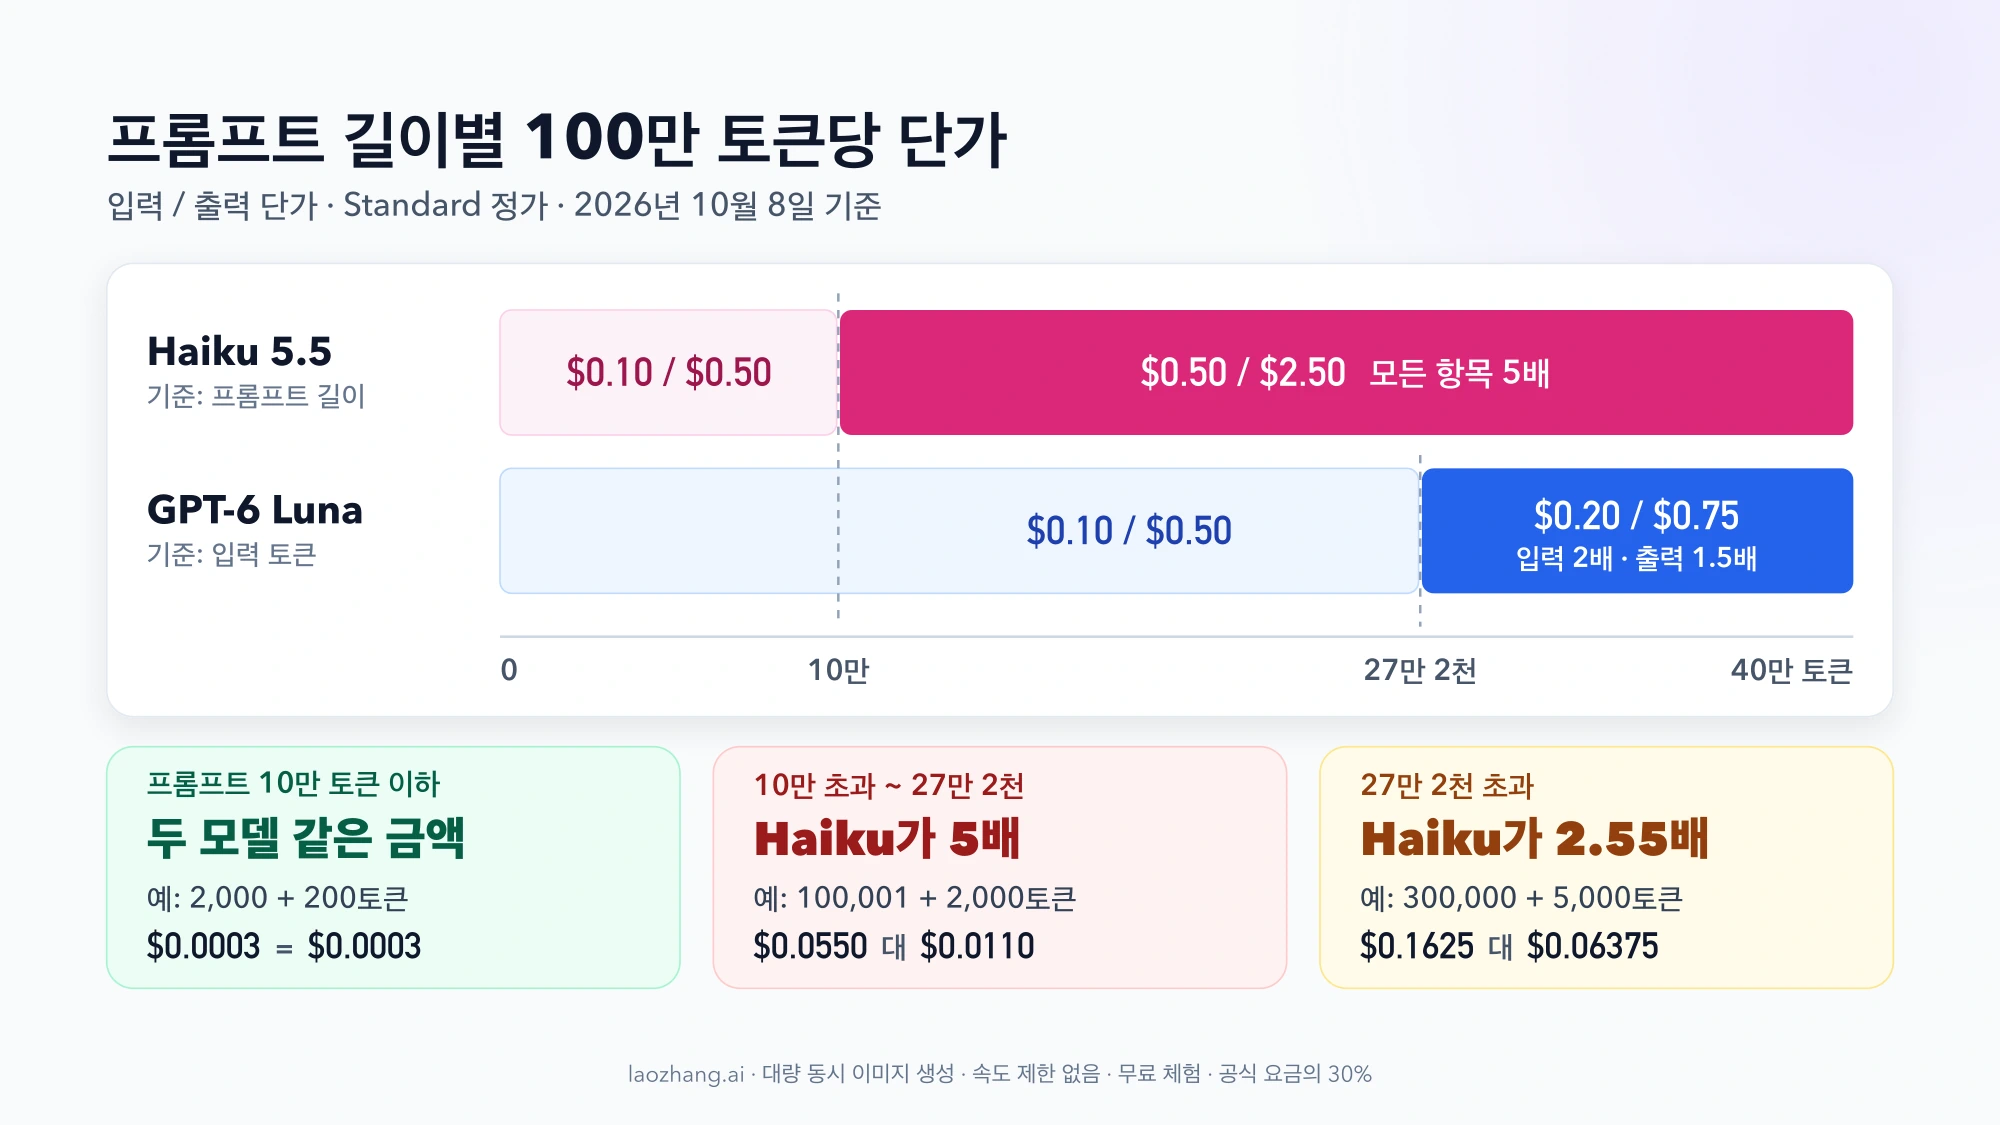
캐시와 도구 없이 Standard 요금으로 요청 1건을 보낼 때의 비용입니다. 공식은 단순합니다.
요청 비용 = 입력 토큰 × 입력 단가 ÷ 1,000,000 + 출력 토큰 × 출력 단가 ÷ 1,000,000
단가는 요청의 프롬프트(입력) 길이로 고른 구간의 값을 씁니다. 예를 들어 100,001 + 2,000토큰이면 Haiku는 100,001 × $0.50 ÷ 100만 + 2,000 × $2.50 ÷ 100만 = $0.0550, Luna는 100,001 × $0.10 ÷ 100만 + 2,000 × $0.50 ÷ 100만 = $0.0110입니다.
| 요청(입력 + 출력 토큰) | Haiku 5.5 | GPT-6 Luna | Haiku/Luna |
|---|---|---|---|
| 2,000 + 200 | $0.0003 | $0.0003 | 1배 |
| 20,000 + 1,000 | $0.0025 | $0.0025 | 1배 |
| 100,000 + 2,000 | $0.011 | $0.011 | 1배 |
| 100,001 + 2,000 | $0.0550 | $0.0110 | 5배 |
| 150,000 + 2,000 | $0.080 | $0.016 | 5배 |
| 272,000 + 2,000 | $0.141 | $0.0282 | 5배 |
| 300,000 + 5,000 | $0.1625 | $0.06375 | 2.55배 |
| Batch 150,000 + 2,000 | $0.040 | $0.008 | 5배 |
2,000 + 200토큰짜리 분류 요청을 100만 건 돌리면 양쪽 모두 $300입니다. 프롬프트가 10만 토큰을 1토큰만 넘어도 Haiku의 같은 요청은 5배가 되고, 이 배율은 Luna가 높은 구간에 들어가는 27만 2천 토큰까지 그대로 유지됩니다. 둘 다 높은 구간에 있는 30만 토큰 요청에서도 Haiku가 2.55배입니다. Batch로 돌려도 두 회사 모두 50%를 할인하므로 배율은 바뀌지 않습니다.
이 표는 두 모델이 같은 텍스트를 같은 토큰 수로 센다고 가정합니다. 실제로는 다음 절의 이유로 토큰 수 자체가 달라집니다. 캐시 쓰기·적중까지 넣어 직접 계산하려면 아래 함수를 쓰면 됩니다.
# 100만 토큰당 미국 달러, Standard 정가(2026년 10월 8일 기준)
# (입력, 캐시 쓰기, 캐시 적중, 출력) — Haiku의 캐시 쓰기는 5분 TTL 요율
RATES = {
    "haiku-5.5": {"limit": 100_000, "low": (0.10, 0.125, 0.01, 0.50), "high": (0.50, 0.625, 0.05, 2.50)},
    "gpt-6-luna": {"limit": 272_000, "low": (0.10, 0.125, 0.01, 0.50), "high": (0.20, 0.25, 0.02, 0.75)},
}

def request_cost(model, fresh, cache_write=0, cache_read=0, output=0):
    """요청 1건의 달러 비용. 캐시 토큰도 구간 판정에 포함한다고 가정한다."""
    r = RATES[model]
    prompt = fresh + cache_write + cache_read
    i, w, c, o = r["high"] if prompt > r["limit"] else r["low"]
    return (fresh * i + cache_write * w + cache_read * c + output * o) / 1_000_000

for model in RATES:
    print(model, round(request_cost(model, 150_000, output=2_000), 6))
# haiku-5.5 0.08
# gpt-6-luna 0.016output에는 사고(thinking)·추론 토큰까지 포함한 출력 토큰 수를 넣어야 합니다. 사용량 응답에서 이 값을 어디서 읽는지는 추론 토큰 요금, 두 번 더하고 있나요? Gemini·OpenAI·Claude 사용량 검산에 정리되어 있습니다.
같은 단가, 다른 청구서: 출력 토큰·토크나이저·사고 블록
토큰 단가가 같다는 말은 같은 토큰 수에 같은 금액을 낸다는 뜻일 뿐, 같은 작업에 같은 금액을 낸다는 뜻은 아닙니다. 차이를 만드는 요인은 네 가지입니다.
작업당 출력·사고 토큰: 같은 effort 이름에서 Haiku가 약 3배
Haiku 5.5는 adaptive thinking이 기본으로 켜져 있고 기본 effort는 medium입니다. 사고 토큰은 출력 토큰으로 과금되고 max_tokens에도 포함됩니다. Artificial Analysis(Intelligence Index v4.3.2)의 Medium 대 Medium 비교에서 작업당 출력 토큰은 Haiku 33k, Luna 11k였고, 그중 추론 토큰은 20k 대 6k였습니다. 출력 단가가 같아도 출력량이 3배면 출력 비용도 3배입니다. Artificial Analysis Medium 비교
effort에 따른 폭도 큽니다. Simon Willison이 같은 프롬프트를 Haiku 5.5에 한 번씩 보냈을 때 low effort는 0.0936센트, max effort는 3.3826센트였습니다. 표본 1건이라 평균값으로 쓸 수는 없지만, 이 표본에서 effort 설정 하나로 비용이 약 36배 벌어졌습니다. Simon Willison의 Haiku 5.5 메모
토크나이저: Haiku 4.5보다 약 30% 많게, Luna와의 비율은 공개 자료 없음
Haiku 5.5는 Claude 4.7 이후 모델과 같은 새 토크나이저를 써서, 같은 텍스트가 Haiku 4.5보다 약 30% 많은 토큰으로 계산됩니다. 증가 폭은 내용에 따라 다르며, Simon Willison의 프롬프트에서는 약 1.25배였습니다. Haiku 5.5 변경 사항
같은 텍스트를 Haiku 5.5와 Luna가 각각 몇 토큰으로 세는지는 두 회사 문서 어디에도 나와 있지 않습니다. 이 비율이 1이 아니면 단가가 같아도 입력 비용이 그만큼 달라지므로, 자기 프롬프트 샘플을 두 API에서 직접 세어 보는 수밖에 없습니다.
이전 사고 블록 유지: 멀티턴에서 입력이 빨리 불어남
Haiku 5.5는 이전 턴의 사고 블록을 기본으로 컨텍스트에 남깁니다. 남은 블록은 다음 요청의 입력으로 다시 과금되고 컨텍스트 창도 차지합니다. 사고 블록을 버리던 Haiku 4.5보다 대화가 빨리 길어지고, 그만큼 10만 토큰 경계에 일찍 닿습니다. Haiku 5.5 마이그레이션 가이드
멀티턴 컨텍스트: 한 번 10만 토큰을 넘으면 그 뒤 모든 턴이 높은 요율
에이전트나 상담 챗봇은 턴마다 이전 대화, 도구 결과, 문서를 다시 보냅니다. 첫 턴이 1만 2천 토큰이어도 턴마다 6천 토큰씩 늘면 16턴째에 10만 토큰을 넘고, 그 시점부터 Haiku의 요청은 출력까지 5배 요율이 됩니다. Luna는 같은 대화가 27만 2천 토큰에 닿기 전까지 요율이 바뀌지 않습니다. 다음 절의 예시가 이 차이를 보여 줍니다.
에이전트 20턴 비용 예시: 캐시를 써도 Haiku가 약 2.2배
가정은 다음과 같습니다. 세션 하나에서 첫 턴 프롬프트가 12,000토큰이고, 도구 결과 등으로 턴마다 6,000토큰씩 늘어 20턴째에는 126,000토큰이 됩니다. 턴당 출력은 1,500토큰이며, 16~20턴의 다섯 턴이 10만 토큰을 넘습니다. 캐시를 쓸 때는 매 턴 이전 프롬프트를 캐시에서 읽고 새로 붙은 6,000토큰을 5분 TTL 요율로 쓰며, 캐시 토큰도 10만 토큰 기준에 들어간다고 가정합니다. 두 모델의 토큰 수는 같다고 둡니다.
| 20턴 세션 비용 | Haiku 5.5 | GPT-6 Luna | Haiku/Luna |
|---|---|---|---|
| 캐시 없음 | $0.396 | $0.153 | 2.59배 |
| 프롬프트 캐시 사용 | $0.0949 | $0.0433 | 2.19배 |
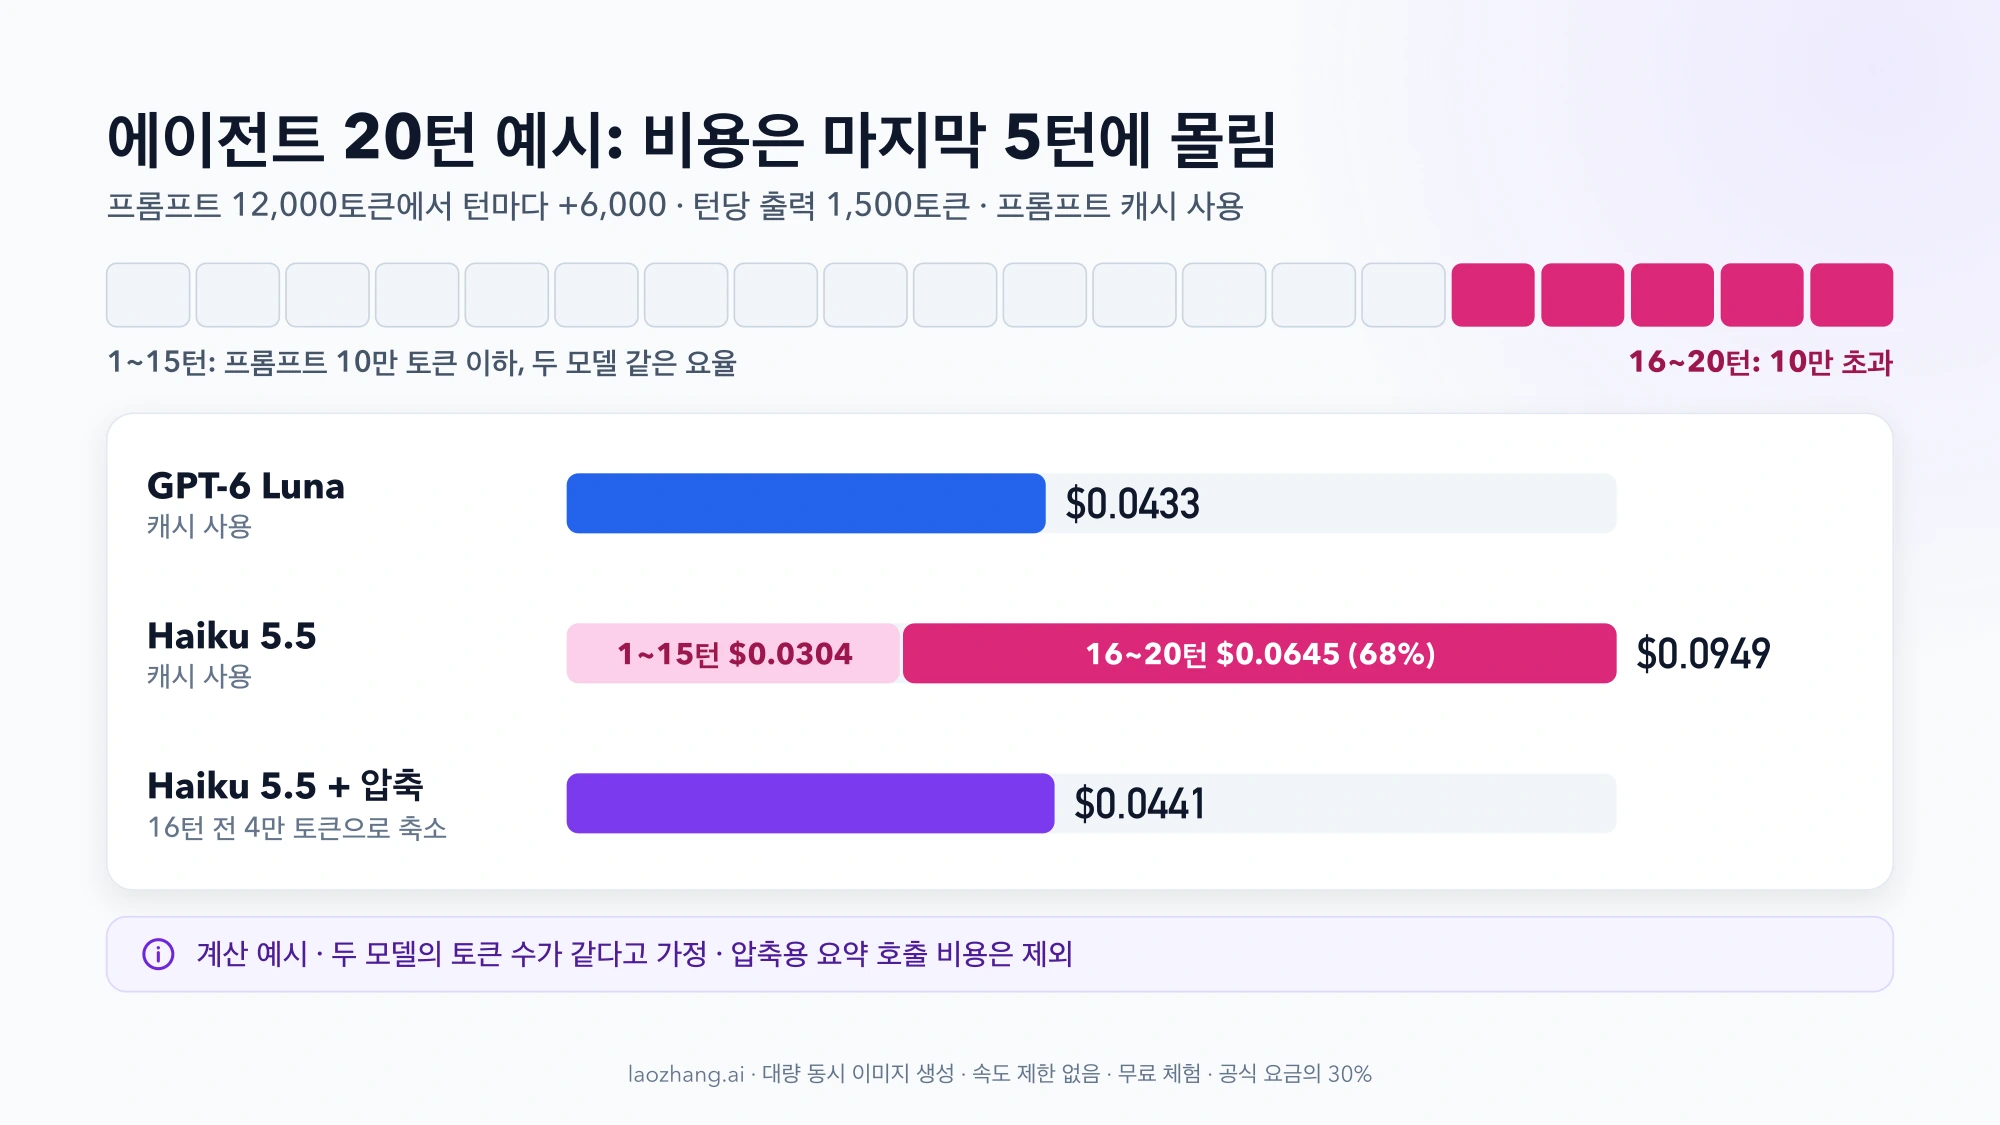
캐시를 쓰면 양쪽 모두 비용이 4분의 1 안팎으로 줄지만 배율은 남습니다. 캐시를 쓴 Haiku 비용 $0.0949 가운데 $0.0645, 약 68%가 10만 토큰을 넘은 다섯 턴에서 나옵니다. 열다섯 턴 동안은 Luna와 같은 금액을 내다가 마지막 다섯 턴에서 차이가 거의 다 생기는 구조입니다.
거꾸로 보면 Haiku의 해법도 분명합니다. 16턴 직전에 대화를 요약해 컨텍스트를 4만 토큰으로 줄이면 Haiku의 캐시 사용 비용은 $0.0441로 내려가 Luna의 $0.0433과 거의 같아집니다. 다만 요약을 만드는 호출 비용은 이 숫자에 포함되지 않습니다. 또 이 계산에는 Haiku가 사고 블록을 남겨 컨텍스트가 더 빨리 커지는 효과가 빠져 있으므로, 실제 Haiku 세션은 더 일찍 10만 토큰을 넘을 수 있습니다. 실측한 청구서가 아니라 구간 규칙이 어떻게 작동하는지 보여 주는 계산입니다.
비슷한 품질에서 작업당 비용: Haiku Low와 Luna Medium 모두 $0.02
effort 이름은 회사마다 뜻이 다르므로 같은 이름끼리 비교하면 공정하지 않습니다. Artificial Analysis의 Intelligence Index v4.3.2(평가 10종) 결과를 지수 순으로 늘어놓으면 품질을 맞춘 비교가 됩니다. 수치는 2026년 10월 8일 기준이며, 출시 다음 날 한 기관의 측정이라 수정될 수 있습니다.
| 모델과 effort | 지수 | 작업당 비용 | 작업당 출력 토큰 | 첫 토큰까지 |
|---|---|---|---|---|
| Luna Low | 22 | $0.0045 | 2k | 3.05초 |
| Haiku Low | 29 | $0.02 | 17k | 9.93초 |
| Luna Medium(기본값) | 30 | $0.02 | 11k | 표시 없음 |
| Luna High | 33 | $0.03 | 20k | 21.08초 |
| Haiku Medium(기본값) | 34 | $0.05 | 33k | 13.40초 |
| Haiku High | 38 | $0.08 | 55k | 28.01초 |
| Luna Max | 38 | $0.07 | 표시 없음 | 111.31초 |
| Haiku Max | 43 | $0.21 | 표시 없음 | 432.21초 |
Max 행은 Artificial Analysis 기본 비교 페이지(Max 대 Max)의 수치로, 표에서 가장 불확실하며 바뀔 수 있습니다.
읽는 법은 이렇습니다.
- 지수가 비슷한 쌍끼리는 작업당 비용이 비슷합니다. Haiku Low(29)와 Luna Medium(30)은 둘 다 $0.02이고, Haiku High(38)는 $0.08, Luna Max(38)는 $0.07입니다. Haiku Medium(34)은 $0.05로 Luna High(33)의 $0.03보다 비쌉니다.
- 기본값끼리 쓰면 Haiku가 2.5배입니다. 설정을 바꾸지 않으면 Haiku Medium은 지수 34에 $0.05, Luna Medium은 지수 30에 $0.02입니다. Haiku 쪽이 지수가 조금 높은 대신 비용이 더 듭니다.
- 품질을 맞추면 Haiku가 첫 토큰을 빨리 냅니다. 지수 38에서 Haiku High는 28초, Luna Max는 111초였습니다. 응답 지연이 중요한 작업이라면 이 차이가 선택 이유가 될 수 있습니다.
- Haiku의 Low·High 작업당 비용에는 별표(*)가 붙어 있습니다. 인용하기 전에 비교 페이지의 각주 조건을 함께 확인하세요. 장문맥 평가(AA-LCR)에서 일부 Haiku 요청이 10만 토큰을 넘어 높은 요율이 적용됐는지는 공개되어 있지 않습니다.
지수는 여러 평가의 평균이라 자기 업무의 정확도를 대신하지 못합니다. 이 표는 "어떤 effort 조합끼리 맞붙여 테스트할지"를 정하는 데 쓰는 것이 맞습니다.
내 트래픽에는 어느 쪽이 싼가: 워크로드별 판단 기준
앞의 계산과 평가를 워크로드별로 정리하면 다음과 같습니다.
| 워크로드 | 비용상 유리한 쪽 | 결론이 바뀌는 조건 |
|---|---|---|
| 짧은 분류·추출·라우팅(요청당 수천 토큰) | 단가는 같음 | 출력 토큰이 비슷하면 무승부. 기본값(Medium)끼리는 AA 기준 Haiku 출력이 약 3배라 Haiku가 비쌈 |
| 프롬프트 10만~27만 2천 토큰 RAG·문서 처리 | Luna(같은 토큰이면 5분의 1) | 문서를 잘라 Haiku 요청을 10만 토큰 아래로 유지할 수 있을 때만 Haiku가 같은 요율 |
| 대화가 쌓이는 에이전트·상담 봇 | Luna | Haiku에서 컨텍스트 압축으로 매 턴을 10만 토큰 아래에 둘 수 있으면 차이가 크게 줄어듦 |
| 27만 2천 토큰을 넘는 초장문 | Luna(30만 + 5천 토큰 예시에서 2.55배 차이) | 출력 비중이 클수록 차이가 커짐(높은 구간 출력 Haiku $2.50, Luna $0.75) |
| 응답 지연이 중요한 실시간 처리 | 품질을 맞추면 비용은 비슷, 첫 토큰은 Haiku가 빠름(지수 38에서 28초 대 111초) | Luna Low(지수 22) 수준으로 충분한 작업이면 Luna가 더 싸고 빠름($0.0045, 3.05초) |
Haiku를 고를 이유가 남는 경우는 세 가지입니다. 낮은 effort의 Haiku가 높은 effort의 Luna와 같은 정확도를 내서 작업당 비용이 맞을 때, 첫 토큰 지연이 중요할 때, 이미 Claude API로 운영 중이라 Haiku 4.5에서 옮기는 것만으로 비용이 크게 줄 때입니다. 반대로 긴 입력이 흔하거나 대화가 길어지는 작업은 Luna가 기본 선택입니다.
두 모델로도 정확도가 부족하다면 상위 모델 비용을 따져야 합니다. 플래그십끼리의 비교는 GPT-6.1 Sol vs Opus 5.5 비교: 정가 2배, 작업당 비용 6배에, Luna와 Sol의 단가 차이와 27만 2천 토큰 규칙은 GPT-6 Luna와 Sol 가격 비교: API 요금과 Codex 크레딧에 있습니다.
Haiku와 Luna 전환 전에 측정할 것과 바꿀 설정
결론을 뒤집을 수 있는 변수는 모두 자기 트래픽에서 잴 수 있습니다. 실제 요청 수백 건을 표본으로 뽑아 아래 순서로 확인합니다.
- 같은 프롬프트의 토큰 수를 두 API에서 셉니다. Anthropic은
model을claude-haiku-5-5로 지정해 다시 세라고 안내합니다. Haiku 4.5에서 잰 값을 재사용하면 약 30% 적게 잡힙니다. 두 모델의 입력 토큰 비율이 단가 비교의 첫 보정값입니다. - 프롬프트 길이 분포를 봅니다. 전체 요청 중 10만 토큰을 넘는 비율과 27만 2천 토큰을 넘는 비율을 구합니다. 캐시 적중 토큰까지 합산한 값으로 보는 편이 안전합니다.
- effort 조합별로 같은 작업을 돌립니다. Haiku는
thinking: {"type": "disabled"}(efforthigh이하에서 가능)와low,medium을, Luna는 reasoning effortnone,low,medium을 시험합니다. 요청마다 출력 토큰(사고·추론 포함)과 성공 여부를 기록합니다. - 성공한 작업 기준으로 나눕니다. 작업당 비용 = 모든 요청 비용의 합 ÷ 성공한 작업 수입니다. 실패해서 다시 보낸 요청까지 넣어야 토큰 단가가 아닌 실제 비용이 나옵니다.
- 멀티턴이면 턴별 입력 증가량을 봅니다. Haiku의 사용량 응답에서
input_tokens,cache_read_input_tokens,cache_creation_input_tokens의 합이 턴마다 얼마씩 늘어나는지, 몇 번째 턴에서 10만 토큰을 넘는지 확인합니다. 남은 사고 블록이 원인이면 컨텍스트 편집으로 정리하는 방법을 검토합니다.
Haiku 쪽에서 비용을 바꾸는 설정은 effort, 사고 끄기, 컨텍스트 압축, 프롬프트 캐시(최소 512토큰부터)입니다. Haiku 4.5 코드에서 넘어온다면 temperature, top_p, top_k를 기본값이 아닌 값으로 보내거나 assistant prefill을 쓰면 400 오류가 나므로 먼저 제거해야 합니다. 안전 분류기가 요청을 거절하면 stop_reason: "refusal"이 돌아오고 서버 쪽 대체 처리는 없으니, 재시도와 다른 모델 전환을 클라이언트에서 처리해야 합니다.
Haiku 4.5에서 옮기는 경우: 요청당 약 88% 절감, 경계는 약 7만 6,900토큰
Anthropic은 Haiku 5.5가 Haiku 4.5보다 10만 토큰 이하 요청에서 90%, 그 위에서 50% 싸고, 토크나이저 변화를 반영하면 평균 약 75% 절감된다고 밝혔습니다. 75%는 Anthropic 트래픽 전체의 평균이라 개별 워크로드에 보장되는 값은 아닙니다. Haiku 5.5 발표
직접 계산하면 이렇습니다. Haiku 4.5에서 10,000토큰이던 프롬프트는 Haiku 5.5에서 약 13,000토큰이 됩니다. 출력 500토큰을 붙이면 Haiku 4.5는 10,000 × $1 ÷ 100만 + 500 × $5 ÷ 100만 = $0.0125, Haiku 5.5는 13,000 × $0.10 ÷ 100만 + 500 × $0.50 ÷ 100만 = $0.00155로 약 88% 줄어듭니다. 단, 사고 없이 쓰던 작업에서 5.5의 기본 사고가 켜지면 출력이 늘어 절감 폭이 작아집니다.
경계선도 옮겨집니다. Haiku 5.5의 10만 토큰은 Haiku 4.5 기준으로 약 76,900토큰(100,000 ÷ 1.3)입니다. 4.5에서 8만 토큰 안팎이던 프롬프트는 5.5에서 높은 구간에 들어갈 수 있으니, 기존 로그의 토큰 수로 판단하지 말고 다시 세어야 합니다.
Haiku 4.5는 2026년 10월 8일 기준 Active 상태이고, 퇴역 시점은 '2026년 10월 15일 이전은 아님'으로만 표시되어 있으며 지원 종료 공지는 없습니다. 서둘러 옮길 이유는 비용이지 종료 일정이 아닙니다. 이후 공지가 나올 수 있으므로 모델 지원 종료 페이지를 확인하세요.
Haiku 5.5와 Luna 요금에서 남는 질문
정확히 100,000토큰인 프롬프트는 어느 요율인가요?
낮은 구간입니다. Anthropic 가격표는 "10만 토큰 이하"와 "10만 토큰 초과"로 나누므로 100,000토큰까지는 입력 $0.10, 출력 $0.50이고 100,001토큰부터 $0.50, $2.50입니다.
캐시 토큰도 Haiku·Luna의 요율 경계 계산에 들어가나요?
두 회사의 가격·캐시·컨텍스트 문서 어디에도 명시되어 있지 않습니다. Anthropic 문서는 세 가지 입력 토큰이 모두 컨텍스트 창에 포함된다고만 적고 있습니다. 예산을 잡을 때는 포함된다고 보고, 실제 청구서에서 경계 근처 요청의 단가를 확인하는 것이 안전합니다.
한국에서 Claude API와 OpenAI API를 둘 다 쓸 수 있나요?
네. Anthropic과 OpenAI의 API 지원 국가 목록에 모두 대한민국이 들어 있습니다. 자기 계정과 키를 어떻게 관리할지는 Claude API 키 구매 전에 확인할 것: 키가 아니라 통제권을 확보하세요를 참고하세요. Anthropic 지원 국가 · OpenAI 지원 국가
Amazon Bedrock나 Google Cloud에서도 Haiku 5.5 가격이 같나요?
같다고 볼 근거가 없습니다. Haiku 5.5는 Amazon Bedrock, Google Cloud, Microsoft Foundry에서도 제공되지만 각 클라우드가 자체 가격을 정합니다. 위 숫자는 모두 Claude API와 OpenAI API를 직접 쓸 때의 정가이므로, 클라우드 경유라면 해당 콘솔의 당일 가격표로 다시 계산해야 합니다.
Haiku 5.5보다 높은 성능이 필요하면 무엇을 봐야 하나요?
Claude 계열의 상위 모델인 Opus 5.5의 비용과 이용 경로는 Claude Opus 5.5 이용 경로·실제 비용·Opus 5 이전 점검에서 다룹니다. 작은 모델로 대부분을 처리하고 어려운 요청만 상위 모델로 보내는 라우팅도 위의 작업당 비용 계산법을 그대로 적용해 비교할 수 있습니다.