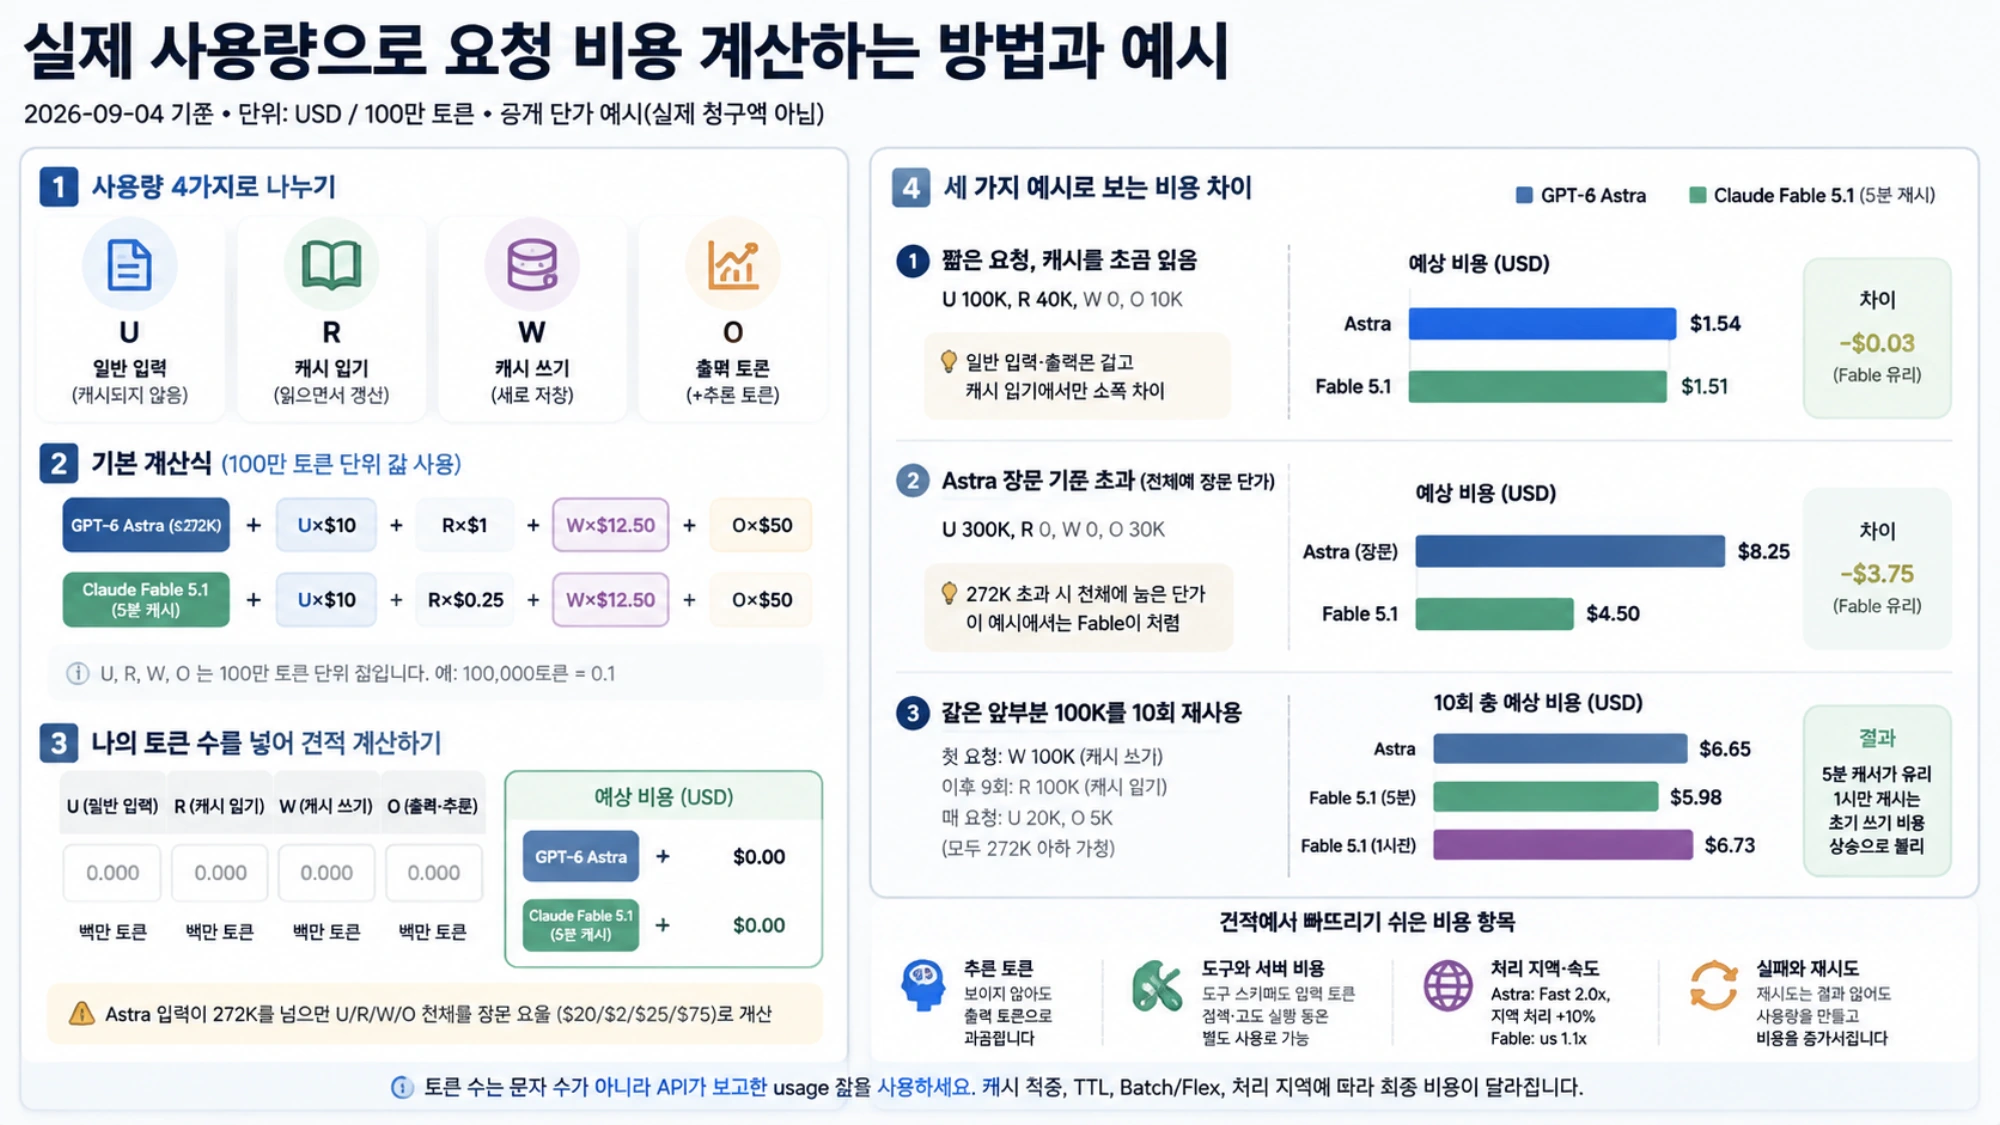
입력 272,000토큰 이하의 표준 요청이라면 두 모델의 일반 입력과 출력 단가는 같습니다. 차이는 캐시 읽기에서 먼저 생깁니다. Claude Fable 5.1은 캐시 읽기가 더 저렴합니다. 반대로 입력이 272,000토큰을 넘는 순간 GPT-6 Astra는 초과분만이 아니라 요청 전체에 장문 단가를 적용하므로 격차가 커질 수 있습니다.
다만 이것만으로 작업당 최저가 모델을 정할 수는 없습니다. 같은 문장도 모델별 토크나이저가 만드는 토큰 수가 다르고, 출력·추론·도구·재시도 사용량도 달라질 수 있기 때문입니다. 공개 단가는 예산의 재료이고, 최종 판단은 동일한 작업을 완료했을 때 API가 반환한 실제 사용량으로 내려야 합니다.
아래 내용은 2026년 9월 5일에 확인한 미국 달러 표시의 공식 API 직접 이용 가격을 기준으로 합니다. 소비자용 앱 구독료, 세금, 기업 계약 할인, AWS·Google Cloud·Microsoft 등 협력 플랫폼의 별도 가격은 포함하지 않습니다.
먼저 확인할 표준 단가
단위는 모두 100만 토큰당 USD입니다. GPT-6 Astra의 공식 API 모델 ID는 gpt-6-astra, Claude Fable 5.1은 claude-fable-5-1입니다. OpenAI 모델 문서와 Anthropic 모델 문서에서 현재 모델 상태와 지원 경로를 확인할 수 있습니다.
| 모델과 조건 | 일반 입력 | 캐시 읽기 | 캐시 쓰기 | 출력 |
|---|---|---|---|---|
| GPT-6 Astra, 입력 272K 이하 | $10 | $1 | $12.50 | $50 |
| GPT-6 Astra, 입력 272K 초과 | $20 | $2 | $25 | $75 |
| Claude Fable 5.1, 1M 컨텍스트 내 표준 가격 | $10 | $0.25 | $12.50(5분) / $20(1시간) | $50 |
GPT-6 Astra의 272K 기준은 계단식 초과 요금이 아닙니다. 입력이 272,000토큰을 넘으면 일반 입력, 캐시 읽기, 캐시 쓰기와 출력 모두 해당 요청 전체에 장문 단가가 붙습니다. 예를 들어 입력 300K 중 28K에만 높은 단가를 적용하면 비용을 과소 계산하게 됩니다. 정확한 구간과 비율은 OpenAI API 가격표에 나와 있습니다.
Claude Fable 5.1은 공식 장문 가격 기준에서 100만 토큰 컨텍스트 전체에 표준 단가를 유지합니다. 캐시 쓰기는 유지 시간에 따라 5분과 1시간 가격이 다릅니다. 캐시 읽기에는 읽으면서 유효 시간을 갱신하는 경우도 포함됩니다. 세부 조건은 Anthropic API 가격 문서를 확인해야 합니다.
따라서 요청이 272K 이하이고 캐시를 쓰지 않는다면, 토큰 수가 같다는 가정 아래 두 모델의 입력·출력 비용도 같습니다. 캐시가 이미 만들어져 있고 반복해서 읽는 요청에서는 Fable 5.1의 낮은 읽기 단가가 유리합니다. 1시간 캐시를 새로 만드는 비중이 높다면 쓰기 비용도 함께 계산해야 하므로 읽기 단가만 보고 결론 내리면 안 됩니다.
실제 요청 비용을 계산하는 식
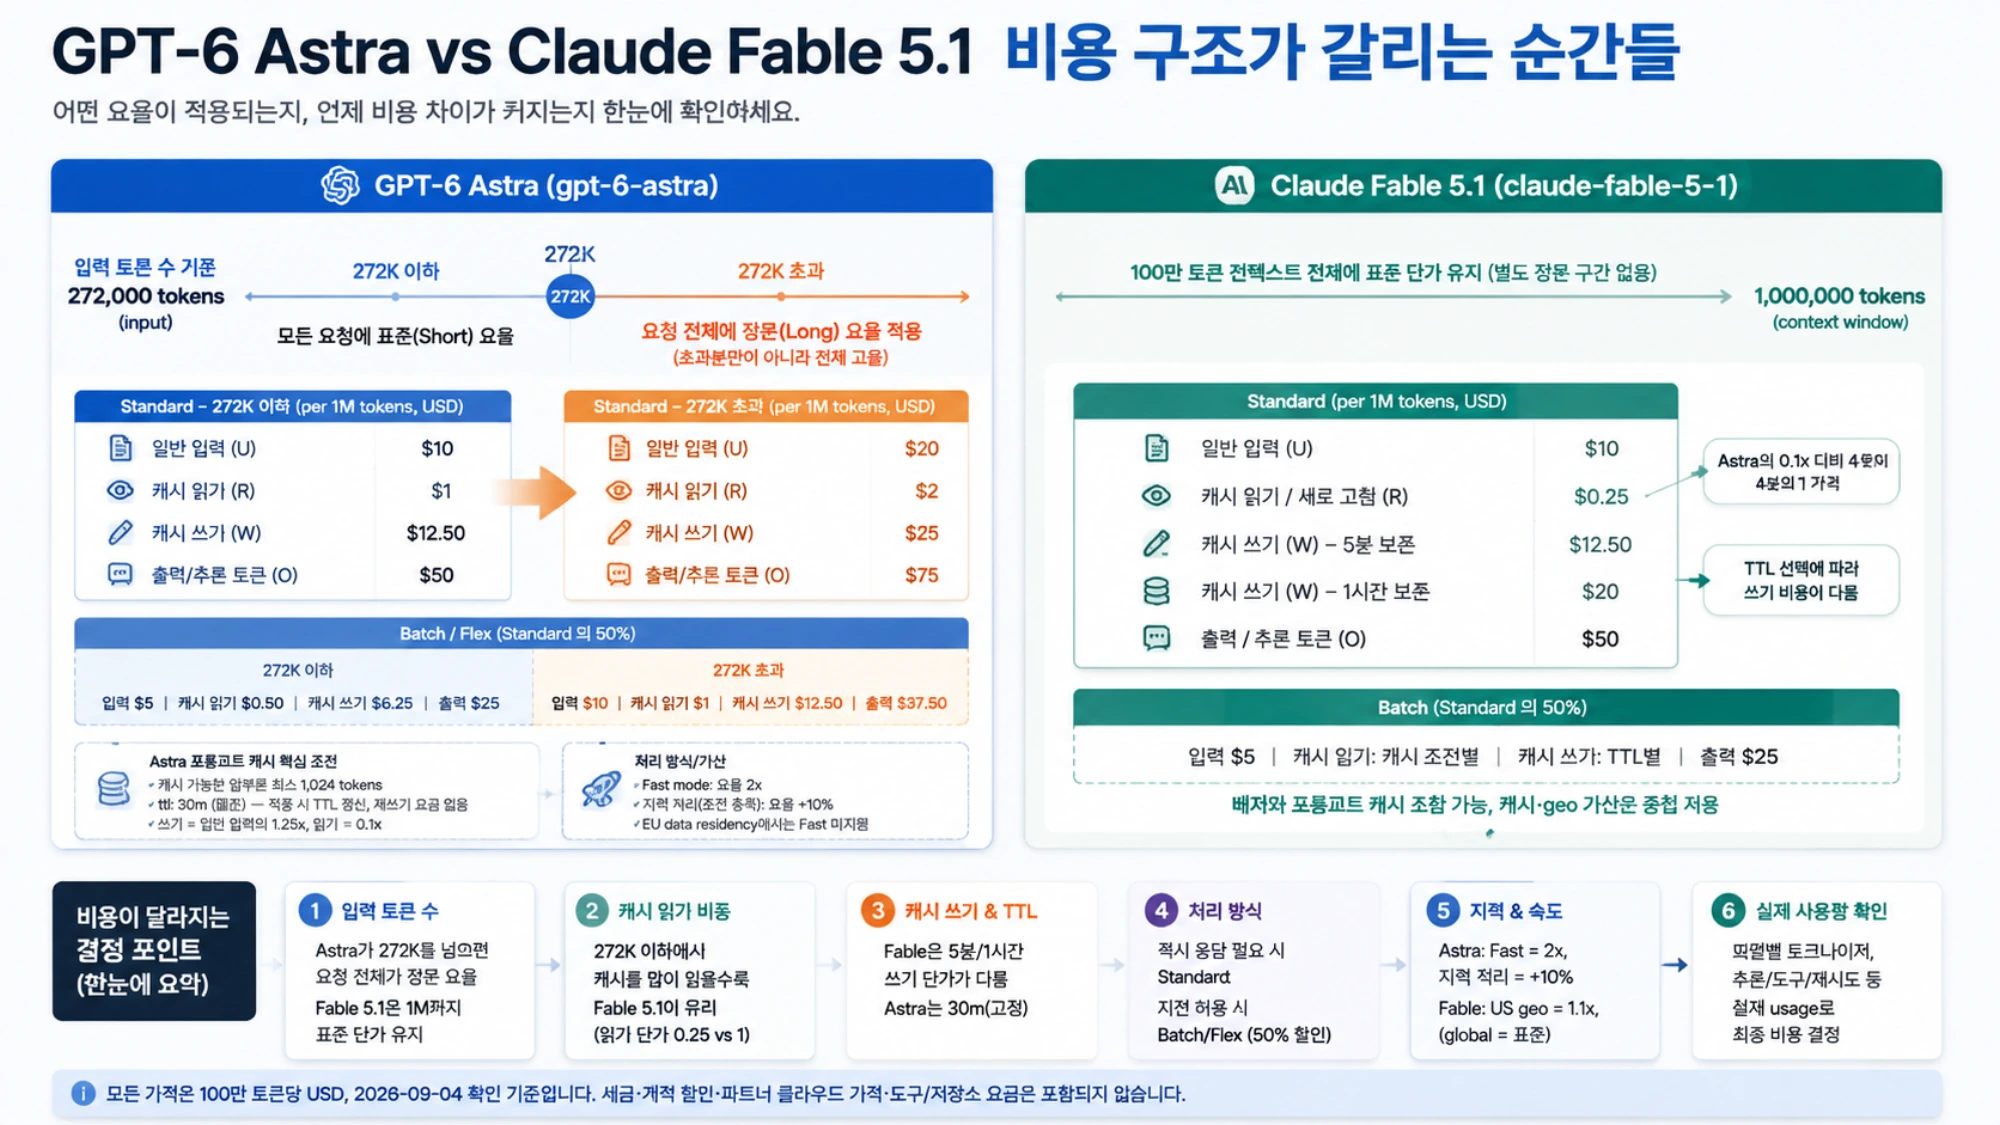
먼저 사용량을 네 종류로 나눕니다.
U: 캐시되지 않은 일반 입력 토큰R: 캐시에서 읽은 입력 토큰W: 새로 캐시에 쓴 입력 토큰O: 출력 토큰
Responses의 일반 입력은 input_tokens에서 input_tokens_details.cached_tokens와 input_tokens_details.cache_write_tokens를 뺀 값입니다. Claude Messages의 input_tokens는 이미 캐시 읽기·쓰기를 제외한 값이므로 다시 빼지 않습니다.
각 값을 100만 단위로 바꾼 뒤 해당 단가를 곱하면 됩니다. 짧은 표준 요청의 기본 식은 다음과 같습니다.
textGPT-6 Astra = U×$10 + R×$1 + W×$12.50 + O×$50

Claude Fable 5.1 (5분 캐시) = U×$10 + R×$0.25 + W×$12.50 + O×$50
Claude Fable 5.1 (1시간 캐시) = U×$10 + R×$0.25 + W×$20 + O×$50
여기서 U, R, W, O는 토큰 수 자체가 아니라 100만 토큰 단위의 값입니다. 예를 들어 100,000토큰은 0.1로 넣습니다. Astra의 입력이 272K를 넘었다면 식 전체를 장문 단가인 $20 / $2 / $25 / $75로 바꿔야 합니다.
이 식에 도구 호출료, 서버 측 검색·코드 실행·저장소 요금, 지역 처리 가산, 세금은 들어 있지 않습니다. 그런 기능을 사용했다면 토큰 비용과 별도 항목을 합산해야 합니다.
세 가지 숫자로 보면 차이가 선명해진다
다음 계산은 토큰 수가 두 모델에서 같고, 도구·세금·재시도·기업 할인이 없다는 가정의 예시입니다. 실제 청구액이 아닙니다.
1. 짧은 요청에서 캐시를 조금 읽는 경우
일반 입력 100K, 캐시 읽기 40K, 출력 10K를 사용하고 캐시는 앞서 생성돼 쓰기 비용이 없는 요청을 생각해 보겠습니다.
| 모델 | 계산 | 예상 비용 |
|---|---|---|
| GPT-6 Astra | 0.1×10 + 0.04×1 + 0.01×50 | $1.54 |
| Claude Fable 5.1 | 0.1×10 + 0.04×0.25 + 0.01×50 | $1.51 |
일반 입력과 출력 가격은 같고 캐시 읽기에서만 3센트 차이가 납니다. 짧은 단발 요청에서는 모델 선택을 바꿀 만큼 큰 차이가 아닐 수 있지만, 동일한 긴 앞부분을 수천 번 재사용하면 누적 차이가 커집니다.
2. Astra의 장문 기준을 넘는 경우
일반 입력 300K와 출력 30K인 한 요청은 Astra의 장문 구간에 들어갑니다.
| 모델 | 계산 | 예상 비용 |
|---|---|---|
| GPT-6 Astra | 0.3×20 + 0.03×75 | $8.25 |
| Claude Fable 5.1 | 0.3×10 + 0.03×50 | $4.50 |
Astra는 300K 입력 전체와 출력 전체에 높은 단가가 적용됩니다. 이 예시에서는 Fable 5.1이 저렴하지만, 실제 비교에서는 두 API가 보고한 각자의 토큰 수를 써야 합니다. Anthropic 가격 문서는 Fable 5.1의 새 토크나이저에서 같은 텍스트가 Claude Sonnet 4.6 이하보다 약 30% 많은 토큰이 될 수 있다고 설명합니다. 이는 콘텐츠에 따라 달라지는 전작 대비 수치이며, Astra와의 환산율이 아닙니다.
3. 같은 앞부분을 열 번 재사용하는 경우
100K짜리 안정된 앞부분을 첫 요청에서 캐시에 쓰고, 다음 아홉 번 읽는다고 가정합니다. 요청마다 별도로 일반 입력 20K와 출력 5K가 있으며 모든 요청은 Astra의 272K 기준 아래입니다.
| 모델 | 캐시 비용을 포함한 10회 예상 합계 |
|---|---|
| GPT-6 Astra | $6.65 |
| Claude Fable 5.1, 5분 쓰기 | 약 $5.98 |
| Claude Fable 5.1, 1시간 쓰기 | 약 $6.73 |
5분 안에 요청을 끝낼 수 있다면 Fable의 낮은 읽기 단가가 이 예시에서 유리합니다. 반면 요청 간격 때문에 1시간 캐시가 필요하면 최초 쓰기 비용이 올라가 결과가 뒤집힙니다. 캐시 적중률이 낮거나 앞부분이 자주 바뀌면 기대한 절감도 사라집니다.
GPT-6 Astra의 프롬프트 캐시는 캐시 가능한 앞부분이 최소 1,024토큰이어야 하며, prompt_cache_options.ttl은 현재 30m만 지원합니다. 적중하면 유효 기간이 갱신되고 다시 캐시 쓰기 요금을 부과하지 않습니다. 구현 전에 OpenAI 프롬프트 캐시 안내에서 앞부분 배치와 수명 조건을 함께 확인하세요.
배치 처리는 절반 가격이지만 실시간 요청은 아니다
두 모델 모두 비동기 배치 처리에 50% 할인된 입력·출력 가격을 제공합니다. 캐시와 Astra의 장문 구간까지 포함한 현재 요율은 다음과 같습니다.
| 처리 방식 | 입력 | 캐시 읽기 | 캐시 쓰기 | 출력 |
|---|---|---|---|---|
| Astra Batch, 272K 이하 | $5 | $0.50 | $6.25 | $25 |
| Astra Batch, 272K 초과 | $10 | $1 | $12.50 | $37.50 |
| Fable 5.1 Batch | $5 | 캐시 조건 별도 적용 | 캐시 조건 별도 적용 | $25 |
Anthropic은 Message Batches와 프롬프트 캐시를 함께 사용할 수 있으며 관련 가격 조정이 중첩된다고 명시합니다. 다만 실제 합계는 캐시 쓰기 유지 시간과 적중 사용량에 따라 달라집니다. OpenAI의 Astra에는 Batch와 같은 50% 요율의 Flex 처리도 있지만, 대기 시간과 처리 특성이 표준 요청과 다릅니다. 즉시 응답이 필요 없는 평가, 대량 분류, 야간 생성처럼 지연을 감수할 수 있는 작업만 배치 후보로 두는 편이 안전합니다.
배치 할인은 모델 간 기본 차이를 없애지 않습니다. 예를 들어 일반 입력 300K와 출력 30K를 배치로 처리하면, 같은 토큰 수라는 가정에서 Astra는 0.3×10 + 0.03×37.50 = $4.125, Fable 5.1은 0.3×5 + 0.03×25 = $2.25입니다. Astra의 장문 구간이 배치에서도 유지되기 때문입니다.
견적에서 빠뜨리기 쉬운 비용
숨은 출력 토큰: GPT-6 Astra의 추론 토큰은 화면에 보이지 않아도 컨텍스트를 사용하며 출력 토큰으로 과금됩니다. 응답 글자 수만 세지 말고 API 응답의 usage를 확인해야 합니다. 자세한 기준은 OpenAI 추론 모델 안내에 설명돼 있습니다.
도구와 도구 정의: 모델에 전달하는 도구 스키마도 입력 토큰에 포함될 수 있고, 검색·코드 실행 같은 서버 측 도구에는 별도 사용료가 붙을 수 있습니다. Astra에서 도구 호출을 사용하려면 Responses API가 필요합니다. Anthropic 릴리스 기록에 따르면 Fable 5.1은 tool_choice의 any와 tool 유형을 지원하지 않습니다. 기존 호출을 그대로 보내 재시도가 늘어나지 않게 호환성을 먼저 확인해야 합니다.
처리 지역과 속도: OpenAI 가격표에 따르면 Fast mode는 해당 요율의 2배이며, 요건을 충족하는 지역 처리에는 10% 가산이 붙을 수 있습니다. Anthropic 데이터 처리 지역 안내에 따르면 inference_geo: "us"는 입력·출력·캐시 요율에 1.1배를 적용하고 기본 global은 표준 가격을 사용합니다. 데이터 위치가 필수 조건이라면 단가표의 최저 숫자가 아니라 실제로 허용된 처리 지역으로 견적을 내야 합니다.
실패와 재시도: 처리에 실패한 호출, 너무 긴 출력, 잘못된 도구 스키마로 인한 재시도는 완료된 결과가 없어도 사용량을 만들 수 있습니다. 한 번의 성공 요청 가격보다 일정 기간의 전체 비용을 완료된 작업 수로 나눈 값이 예산에 더 가깝습니다.
실제 예산을 내는 순서
- 접근 권한부터 확인합니다. GPT-6 Astra는 2026년 9월 3일 발표됐지만 출시 초기에는 Trusted Access Program 기업부터 단계적으로 열렸습니다. 문서와 가격표가 보인다고 모든 조직에서 즉시 호출할 수 있는 것은 아닙니다. OpenAI API 변경 기록과 실제 조직·프로젝트의 호출 결과를 함께 확인하세요. Anthropic 릴리스 기록에 따르면 Claude Fable 5.1은 2026년 9월 1일 공개됐고 공식 문서에서 Active 모델로 표시되지만, 협력 클라우드의 지역·계약은 별도입니다.
- 같은 완료 조건으로 표본을 수집합니다. 두 모델에 같은 작업을 주되 각 모델이 실제로 사용한 입력, 캐시 읽기, 캐시 쓰기, 출력과 재시도를 따로 저장합니다. 같은 문자 수나 다른 모델의 토큰 수를 복사하지 않습니다.
- 요청별 가격 구간을 정합니다. Astra는 각 요청의 입력이 272K를 넘는지 먼저 판정한 뒤 그 요청 전체에 한 세트의 요율을 적용합니다. Fable은 캐시 쓰기의 5분·1시간 선택과 실제 적중량을 구분합니다.
- 처리 방식과 가산 항목을 붙입니다. Standard, Batch, Flex, Fast, 처리 지역, 서버 측 도구, 파트너 클라우드를 한 칸에 섞지 말고 별도 열로 기록합니다.
- 완료 건당 비용을 비교합니다. 성공 호출뿐 아니라 필요한 재시도와 도구 비용을 모두 더한 뒤, 합의한 완료 조건을 충족한 결과 수로 나눕니다.
기록표에는 최소한 모델 ID, 처리 등급, 일반 입력, 캐시 읽기, 캐시 쓰기와 TTL, 출력·추론, 도구 사용, 재시도, 처리 지역, 통화를 남기는 것이 좋습니다. 월 예산은 이 표본의 평균만 곱하지 말고 긴 입력이 몰리는 구간과 캐시 적중률이 낮아지는 경우도 별도 시나리오로 계산하세요.
어떤 조건에서 어느 쪽이 저렴한가
- 272K 이하, 캐시 없음: 같은 사용량이면 일반 입력·출력 단가가 같아 비용도 같습니다.
- 272K 이하, 캐시 읽기 많음: 같은 캐시 사용량이라면 Fable 5.1의 읽기 단가가 낮습니다. 다만 캐시 쓰기 TTL과 실제 적중률을 함께 봐야 합니다.
- Astra 입력 272K 초과: 요청 전체에 장문 단가가 적용되므로, Fable 5.1이 1M 표준 구간 안에 있는 동일 사용량 예시에서는 더 저렴합니다.
- 지연 허용 대량 작업: 두 모델 모두 Batch가 기준 단가의 50%입니다. Astra는 Flex도 선택지지만 처리 특성을 실시간 Standard와 같다고 보면 안 됩니다.
- 실제 제품 예산: 토크나이저, 추론·출력량, 도구, 재시도, 처리 지역과 계약 가격이 달라져 공개 단가만으로 승자를 정할 수 없습니다.
결국 비교의 핵심은 “100만 토큰당 얼마인가”에서 끝나지 않습니다. 요청이 Astra의 272K 기준을 넘는지, 캐시를 읽고 쓰는 비중이 얼마인지, 배치를 허용할 수 있는지, 두 API가 같은 완료 작업에서 실제로 몇 토큰과 몇 번의 호출을 사용했는지를 차례로 확인해야 합니다. 이 네 가지를 실제 사용량 기록에 대입했을 때 비로소 팀의 비용 차이가 계산됩니다.