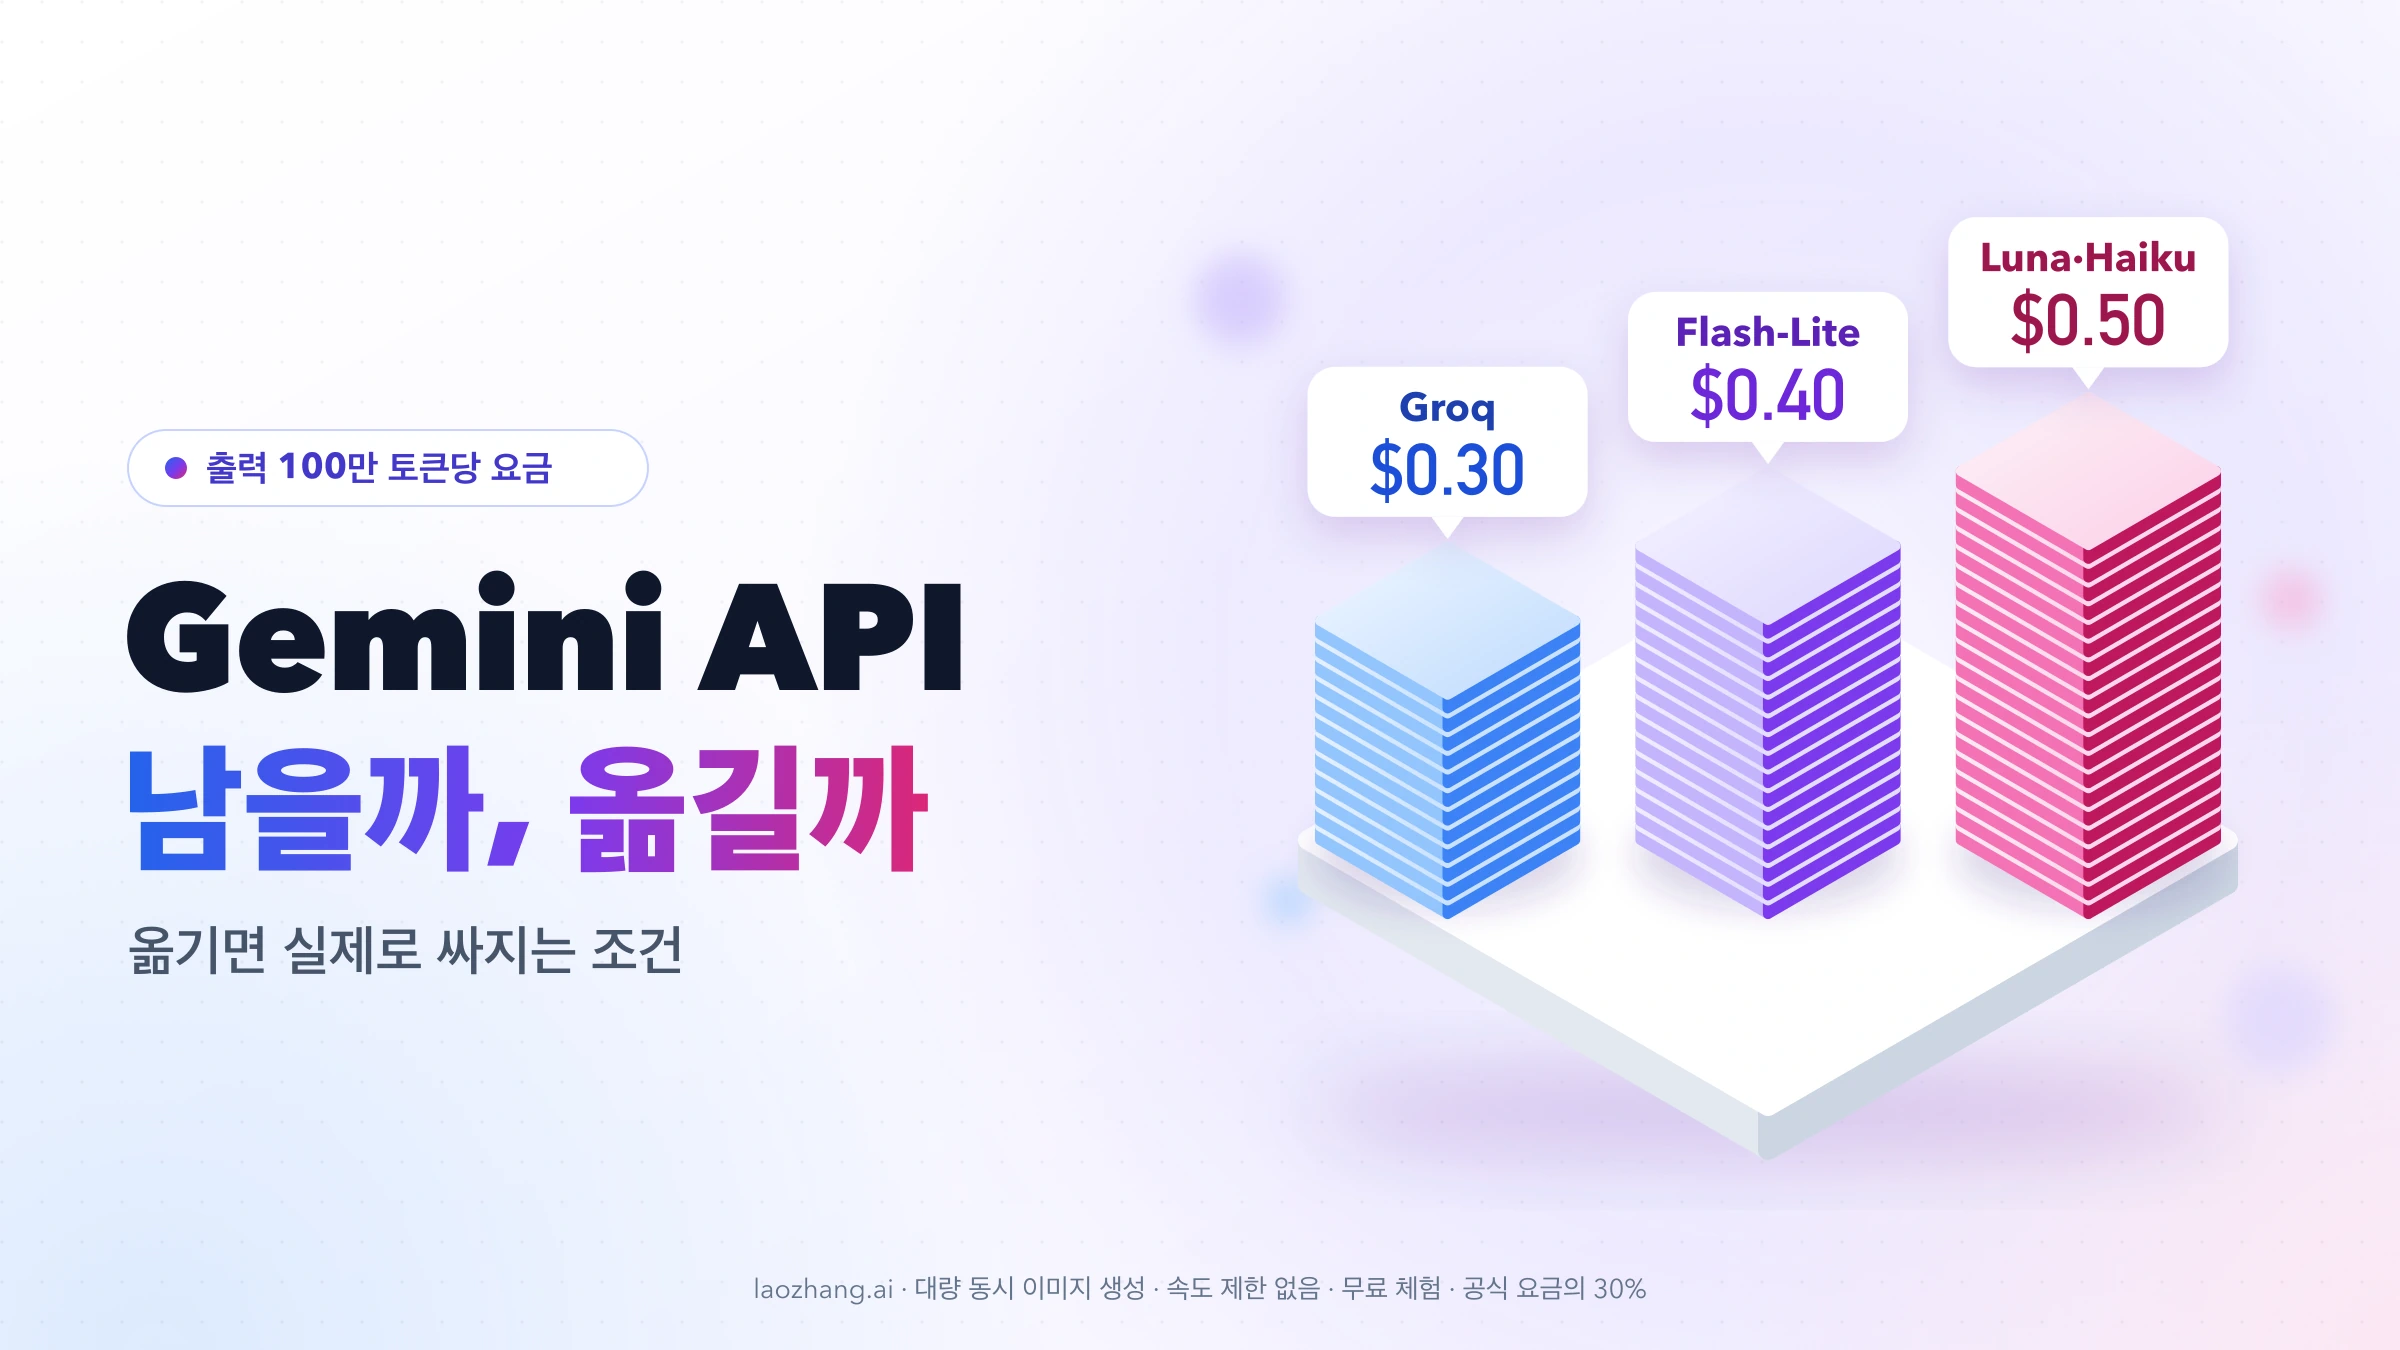
2026년 10월 8일 기준으로 가장 싼 Gemini 텍스트 모델은 2.5 모델을 써 온 사용자라면 여전히 Gemini 2.5 Flash-Lite, 새 프로젝트라면 Gemini 3.1 Flash-Lite 입니다. Google이 2026년 9월 18일부터 2.5 모델을 과거에 사용한 적이 있는 사용자에게만 제공하고 있기 때문입니다(지원 종료 일정). 표준 요금은 100만 토큰당 2.5 Flash-Lite가 입력 $0.10, 출력 $0.40, 3.1 Flash-Lite가 입력 $0.25, 출력 $1.50이고 둘 다 무료 등급이 있습니다(Google Gemini API 가격). 새로 나온 GPT-6 Luna 와 Claude Haiku 5.5 는 둘 다 입력 $0.10, 출력 $0.50이라 2.5 Flash-Lite와 비교하면 입력은 같고 출력은 25% 비싸지만, 3.1 Flash-Lite보다는 입력과 출력 모두 쌉니다. 아래 비교 대상 가운데 표준 요금으로 2.5 Flash-Lite보다 입력과 출력이 모두 더 싼 곳은 Groq의 GPT OSS 20B($0.075/$0.30) 하나입니다.
그래서 판단은 단순해집니다.
- 지금 Gemini 3.x Flash나 Pro를 쓰고 있고 2.5 모델을 써 온 사용자라면 다른 회사보다 2.5 Flash-Lite로 내려가는 쪽이 훨씬 큰 절감입니다. 3.8 Flash의 프로모션 요금 $0.75/$3.75도 2027년 1월 1일부터 $1.50/$7.50으로 두 배가 됩니다.
- 이미 2.5 Flash-Lite를 쓰고 있다면 단가 때문에 옮길 곳은 거의 없습니다. 텍스트만 대량으로 처리하는 작업을 Groq로 나누는 정도가 실제로 싸지는 경우입니다.
- 2.5 모델을 써 본 적이 없는 새 프로젝트라면 Gemini 안에서는 3.1 Flash-Lite까지만 내려갈 수 있습니다. 1M 입력 + 200K 출력 작업이 3.1 Flash-Lite에서 $0.55, Luna·Haiku 5.5에서 $0.20, Groq GPT OSS 20B에서 $0.135이므로 이때는 옮기는 쪽이 쌉니다.
- 2.5 Flash-Lite를 쓸 수 있다면 Luna나 Haiku 5.5로 가는 이유는 가격이 아니어야 합니다. 출력이 많을수록 차이가 벌어지고, Haiku 5.5는 프롬프트가 10만 토큰을 넘으면 모든 단가가 5배가 됩니다.
Gemini API 대안 가격 비교: 1M 입력 + 200K 출력 비용
아래 표는 2026년 10월 8일 기준 각 회사 공식 가격표의 표준 요금(캐시·Batch 할인 없음)입니다. 오른쪽 열은 입력 100만 토큰과 출력 20만 토큰을 처리하는 작업 하나의 비용으로, 입력 단가 × 1 + 출력 단가 × 0.2로 계산했습니다.
| 모델 | 입력 / 출력 (100만 토큰당) | 1M 입력 + 200K 출력 | Gemini 2.5 Flash-Lite 대비 |
|---|---|---|---|
| Groq GPT OSS 20B | $0.075 / $0.30 | $0.135 | 입력·출력 모두 더 쌈 |
| Gemini 2.5 Flash-Lite (2.5 모델을 써 온 사용자) | $0.10 / $0.40 | $0.18 | 기준 |
| GPT-6 Luna (입력 27.2만 토큰 이하) | $0.10 / $0.50 | $0.20 | 입력 같음, 출력 25% 비쌈 |
| Claude Haiku 5.5 (프롬프트 10만 토큰 이하) | $0.10 / $0.50 | $0.20 | 입력 같음, 출력 25% 비쌈 |
| Mistral Small 4 | $0.15 / $0.60 | $0.27 | 둘 다 비쌈 |
| DeepSeek V4.1-Flash 비혼잡 시간 | $0.15 / $0.60 | $0.27 | 둘 다 비쌈 |
| DeepSeek V4.1-Flash 혼잡 시간 | $0.30 / $1.20 | $0.54 | 둘 다 비쌈 |
| Gemini 3.1 Flash-Lite (신규 프로젝트의 Gemini 최저가) | $0.25 / $1.50 | $0.55 | 둘 다 비쌈 |
| Gemini 3.8 Flash (2026년 말까지) | $0.75 / $3.75 | $1.50 | 둘 다 비쌈 |
가격 출처: Gemini, OpenAI, Anthropic, Mistral Small 4, DeepSeek, Groq.
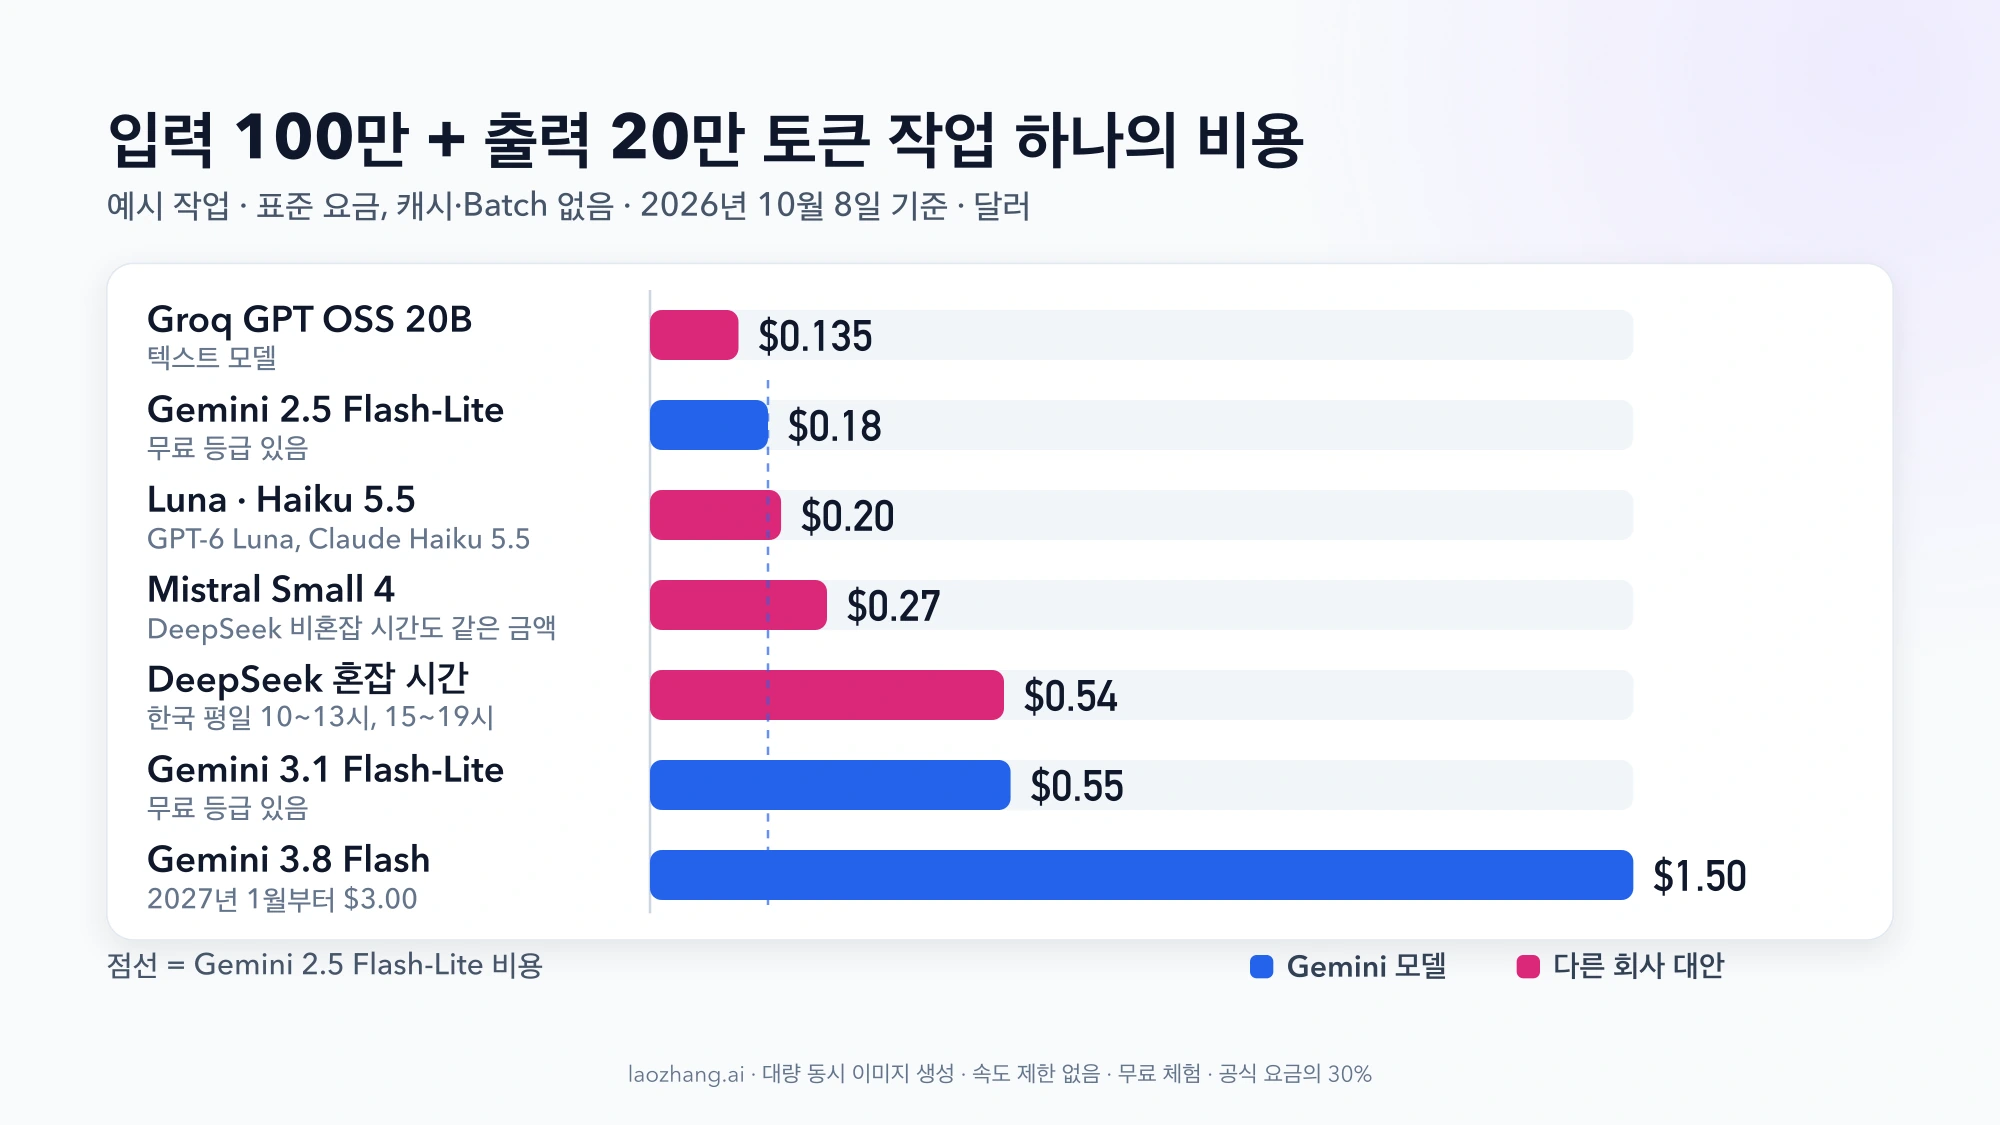
이 표에서 읽어야 할 것은 순위보다 간격입니다. 2.5 Flash-Lite와 Luna·Haiku 5.5의 차이는 이 작업에서 $0.02, Groq와의 차이는 $0.045입니다. 반면 Gemini 3.8 Flash와 2.5 Flash-Lite의 차이는 $1.32입니다. 2.5 모델을 써 온 사용자가 비용을 줄이려는 목적이라면 회사를 바꾸는 것보다 Gemini 안에서 모델을 내리는 효과가 훨씬 큽니다. 새 프로젝트는 계산이 반대입니다. 3.8 Flash에서 3.1 Flash-Lite로 내리면 $0.95($1.50 → $0.55)가 줄지만, Luna·Haiku 5.5로 옮기면 $1.30($1.50 → $0.20)이 줄어듭니다.
같은 토큰 수라도 회사마다 토크나이저가 달라 실제로 세어지는 토큰은 조금씩 다릅니다. 품질, 컨텍스트 길이, 이미지 입력 지원, 사용량 한도도 다르므로 표는 단가 비교일 뿐 모델 선택 자체를 대신하지 않습니다.
가장 싼 Gemini API는 2.5 Flash-Lite, 신규 프로젝트는 3.1 Flash-Lite
Gemini 안에서 모델별 요금과 무료 등급 여부를 보면 다음과 같습니다(2026년 10월 10일 기준, 100만 토큰당 표준 요금). 표의 2.5 Flash-Lite·2.5 Flash·2.5 Pro는 2.5 모델을 써 온 사용자만 호출할 수 있습니다.
| Gemini 모델 | 입력 / 출력 | 무료 등급 | 1M 입력 + 200K 출력 |
|---|---|---|---|
| Gemini 2.5 Flash-Lite | $0.10 / $0.40 | 있음 | $0.18 |
| Gemini 3.1 Flash-Lite | $0.25 / $1.50 | 있음 | $0.55 |
| Gemini 3.5 Flash-Lite | $0.30 / $2.50 | 있음 | $0.80 |
| Gemini 2.5 Flash | $0.30 / $2.50 | 있음 | $0.80 |
| Gemini 3.6·3.8 Flash | $0.75 / $3.75 (2026년 12월 31일까지), 2027년 1월 1일부터 $1.50 / $7.50 | 있음 | $1.50 → $3.00 |
| Gemini 3.5 Flash·3.7 Flash | 2026년 10월 8일 지원 중단, 가격표에서 삭제. 요청은 각각 3.6 Flash·3.8 Flash로 자동 전환 | — | — |
| Gemini 2.5 Pro (20만 토큰 이하) | $1.25 / $10 | 있음 | $3.25 |
| Gemini 3.1 Pro Preview (20만 토큰 이하) | $2 / $12 | 없음 | $4.40 |
| Gemma 4 | 유료 등급 없음 | 무료 등급만 | — |
Batch와 Flex는 표준 요금의 절반이고 Priority는 1.8배입니다. Batch·Flex 요금은 2.5 Flash-Lite가 $0.05/$0.20, 3.1 Flash-Lite가 $0.125/$0.75입니다. 오디오 입력은 텍스트보다 비싸서 2.5 Flash-Lite는 $0.30, 3.1 Flash-Lite는 $0.50입니다.
표에서 눈여겨볼 점은 세 가지입니다.
첫째, 숫자가 높다고 싼 것이 아닙니다. 3.1 Flash-Lite는 2.5 Flash-Lite보다 입력 2.5배, 출력 3.75배 비쌉니다. 3.5 Flash도 지원 중단 전에는 $1.50/$9.00으로 프로모션 중인 3.8 Flash보다 오히려 비쌌습니다. Google은 2026년 10월 8일 릴리스 노트에서 3.5 Flash와 3.7 Flash를 지원 중단하고 요청을 각각 3.6 Flash와 3.8 Flash로 자동 전환했습니다. 전환된 요청에 어느 가격이 적용되는지는 공개되지 않았으므로, 예전 ID를 쓰고 있다면 Cloud Billing 보고서에서 SKU별 청구를 확인하고 모델 ID를 gemini-3.6-flash나 gemini-3.8-flash로 바꾸세요. 3.x 기능이 꼭 필요하지 않다면 가장 싼 경로는 여전히 2.5 Flash-Lite입니다. 다만 Google은 2026년 9월 18일부터 2.5 계열을 과거에 사용한 적이 있는 사용자에게만 제공하고, 신규 프로젝트에는 3.5 Flash-Lite나 3.8 Flash를 쓰라고 안내합니다(지원 종료 일정). 2.5 Flash-Lite를 써 본 적이 없는 새 프로젝트라면 Gemini 안의 저가 선택지는 3.1 Flash-Lite($0.25/$1.50, 가장 이른 종료일 2027년 5월 7일)나 Google이 권하는 3.5 Flash-Lite($0.30/$2.50)입니다.
둘째, 3.6·3.8 Flash의 $0.75/$3.75는 2026년 12월 31일까지의 요금입니다. 2027년 예산을 잡을 때는 $1.50/$7.50으로 계산해야 하며, 이 경우 1M 입력 + 200K 출력 작업은 $3.00이 되어 Luna·Haiku 5.5의 15배입니다.
셋째, Gemma 4 는 Gemini API에서 무료 등급으로만 제공되고 유료 등급이 없습니다. 시제품 단계에서는 쓸 수 있지만, 사용량이 늘어 유료로 전환해야 하는 서비스의 기본 모델로 두기는 어렵습니다. 예전에 쓰이던 Gemini 2.0 Flash와 2.0 Flash-Lite는 현재 가격표에 없습니다.
Gemini 2.5 Flash API 가격이 궁금해 찾아왔다면, 2.5 Flash는 $0.30/$2.50으로 3.5 Flash-Lite와 같은 요금입니다. 2.5 Flash를 쓰고 있다면 출력 단가가 2.5 Flash-Lite의 6배를 넘으므로, 요약·분류·추출처럼 출력이 짧은 작업은 2.5 Flash-Lite로 내리는 것이 먼저입니다. 2.5 모델을 써 본 적이 없는 새 프로젝트라면 같은 작업에 쓸 수 있는 가장 싼 Gemini는 3.1 Flash-Lite($0.25/$1.50)이고, 출력 단가는 2.5 Flash의 60%입니다.
무료 등급의 모델별 하루 요청 한도는 가격표에 나오지 않고 AI Studio에서 프로젝트별로 확인합니다. 모델 목록과 한도 확인 방법은 Gemini API 무료 티어 모델 목록, 하루 한도보다 먼저 확인할 것에 정리되어 있습니다.
옮기면 실제로 싸지는 조건: 출력 비중, 프롬프트 길이, 캐시, 시간대
위의 1M + 200K 예시는 한 가지 작업 형태일 뿐입니다. 아래 조건 중 하나라도 내 작업에 해당하면 순위가 달라질 수 있으니, 해당하는 조건의 숫자로 다시 계산해 보세요.
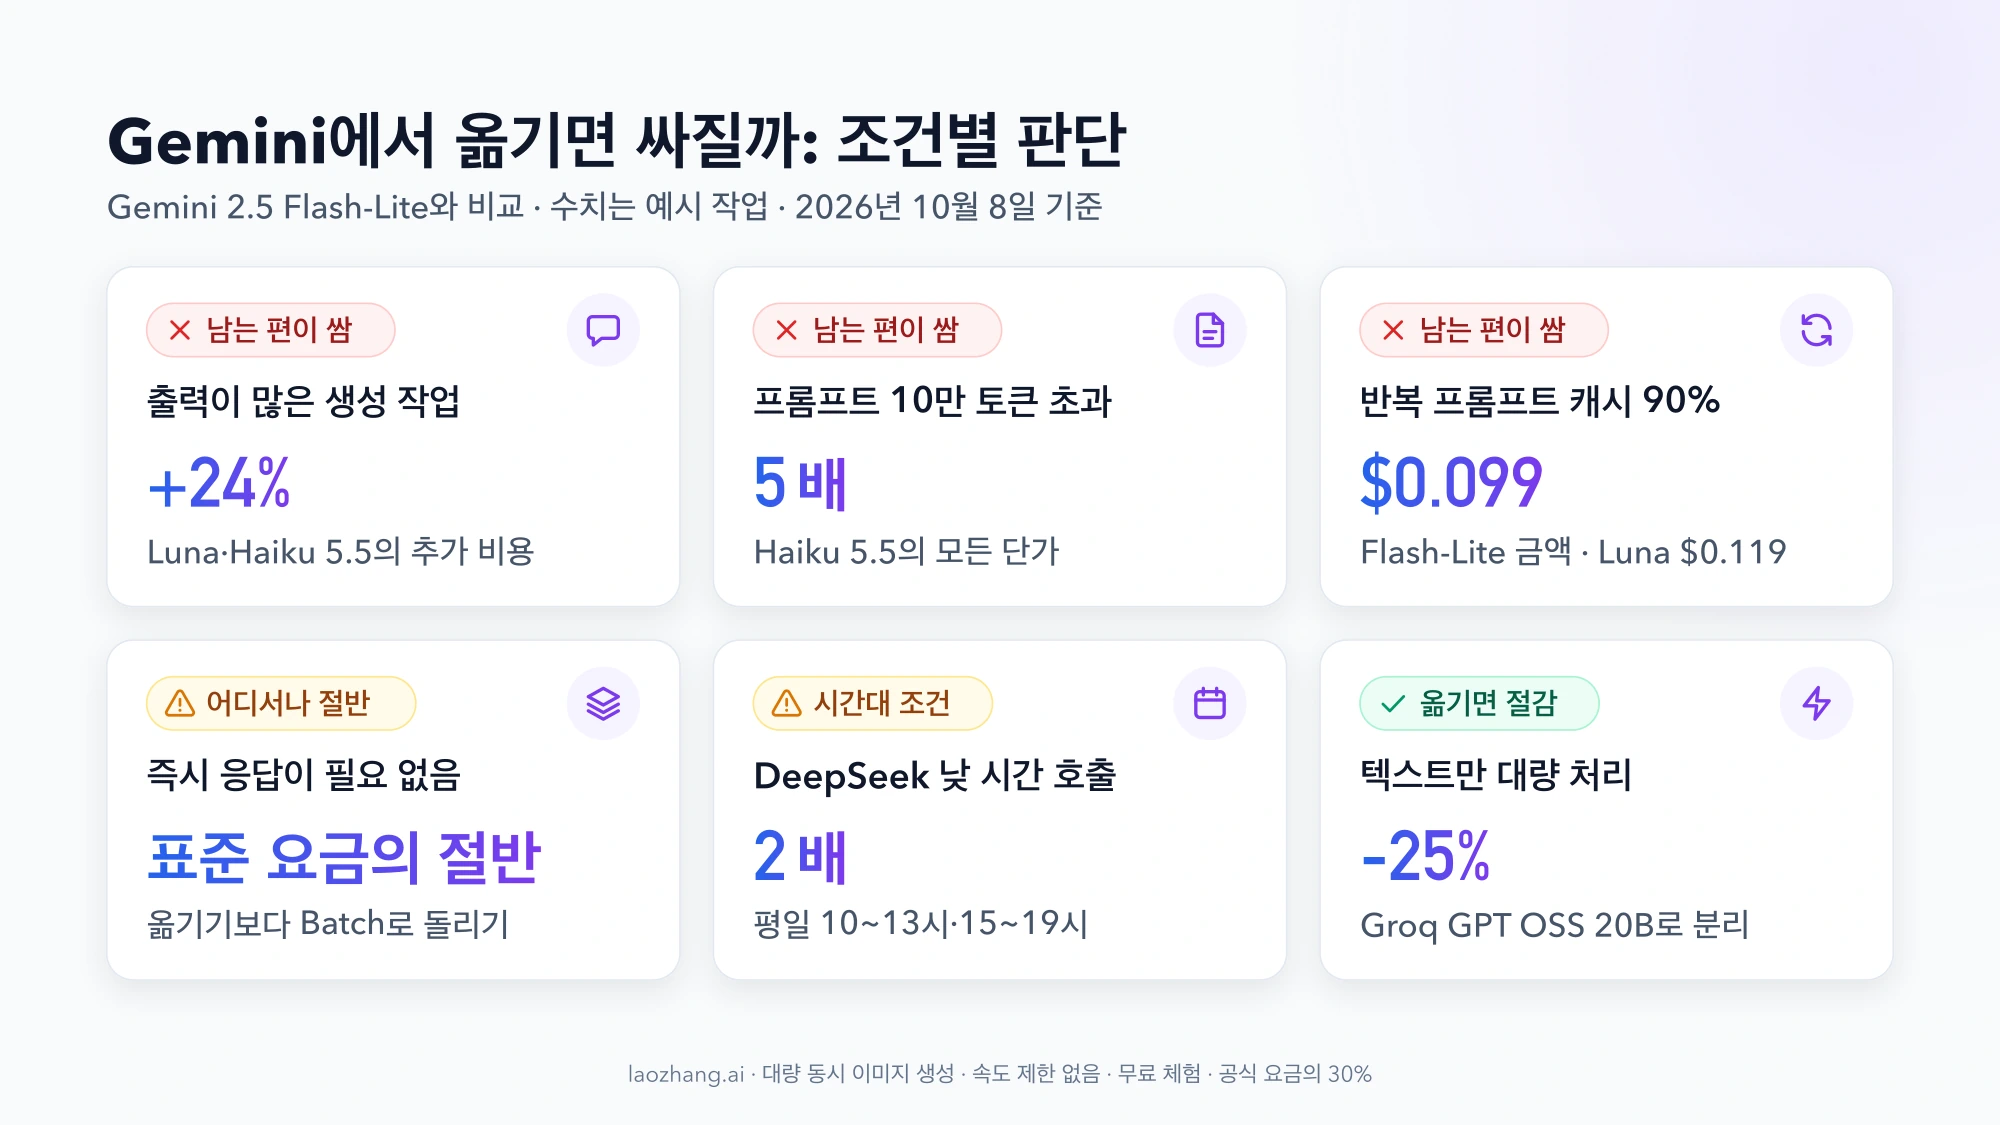
출력이 많은 작업일수록 Luna·Haiku 5.5와의 차이가 커진다
입력 단가가 같으니 차이는 출력에서만 납니다. 입력 20만 토큰, 출력 100만 토큰인 생성 위주 작업을 계산하면 다음과 같습니다.
- Gemini 2.5 Flash-Lite(2.5 모델을 써 온 사용자): $0.10 × 0.2 + $0.40 × 1 = $0.42
- GPT-6 Luna, Claude Haiku 5.5: $0.10 × 0.2 + $0.50 × 1 = $0.52
- Groq GPT OSS 20B: $0.075 × 0.2 + $0.30 × 1 = $0.315
- Mistral Small 4, DeepSeek 비혼잡 시간: $0.15 × 0.2 + $0.60 × 1 = $0.63
- Gemini 3.1 Flash-Lite(신규 프로젝트): $0.25 × 0.2 + $1.50 × 1 = $1.55
2.5 모델을 써 온 사용자라면 생성 위주 작업에서 Luna·Haiku 5.5는 2.5 Flash-Lite보다 약 24% 비쌉니다. 반대로 긴 문서를 읽고 짧게 답하는 작업이라면 입력이 같은 가격이라 차이가 거의 없습니다. 새 프로젝트라면 비교 기준이 3.1 Flash-Lite($1.55)가 되어 Luna·Haiku 5.5의 비용이 3분의 1 수준이고, 입력 단가도 $0.10 대 $0.25라 읽기 위주 작업에서도 Luna·Haiku 5.5가 쌉니다(Haiku 5.5는 프롬프트 10만 토큰 이하일 때).
프롬프트가 10만 토큰을 넘으면 Haiku 5.5는 5배
Claude Haiku 5.5의 $0.10/$0.50은 프롬프트가 10만 토큰 이하일 때만 적용됩니다. 넘으면 모든 단가가 5배인 $0.50/$2.50이 됩니다. GPT-6 Luna는 입력 27.2만 토큰까지 $0.10/$0.50이고, 넘으면 그 요청 전체가 $0.20/$0.75로 계산됩니다.
입력 15만 토큰, 출력 2,000토큰짜리 요청 하나를 계산하면 차이가 분명합니다.
- Gemini 2.5 Flash-Lite(2.5 모델을 써 온 사용자): $0.10 × 0.15 + $0.40 × 0.002 = 약 $0.0158
- Gemini 3.1 Flash-Lite(신규 프로젝트): $0.25 × 0.15 + $1.50 × 0.002 = 약 $0.0405
- GPT-6 Luna: $0.10 × 0.15 + $0.50 × 0.002 = $0.016
- Claude Haiku 5.5: $0.50 × 0.15 + $2.50 × 0.002 = $0.080
같은 요청을 1,000번 보내면 2.5 Flash-Lite $15.8, 3.1 Flash-Lite $40.5, Luna $16, Haiku 5.5 $80입니다. 긴 계약서나 코드베이스를 통째로 넣는 작업에서 Haiku 5.5는 저가 선택지가 아닙니다. 두 모델의 임계값과 캐시 요금은 Claude Haiku 5.5 vs GPT-6 Luna 가격 비교: 10만 토큰 넘으면 5배에서 더 자세히 다룹니다.
반복 프롬프트를 캐시하면 순위는 그대로, 금액만 줄어든다
시스템 프롬프트나 공유 문서가 매번 반복된다면 캐시 요금으로 다시 계산해야 합니다. 입력 100만 토큰 중 90%가 캐시에서 읽히고 출력이 20만 토큰이라고 가정하면 다음과 같습니다.
- Gemini 2.5 Flash-Lite(2.5 모델을 써 온 사용자, 캐시 $0.01): $0.01 × 0.9 + $0.10 × 0.1 + $0.40 × 0.2 = $0.099, 여기에 캐시 저장료(100만 토큰당 시간당 $1)가 붙습니다.
- Gemini 3.1 Flash-Lite(신규 프로젝트, 캐시 $0.025): $0.025 × 0.9 + $0.25 × 0.1 + $1.50 × 0.2 = 약 $0.348, 캐시 저장료는 같은 시간당 $1입니다.
- GPT-6 Luna(캐시 입력 $0.01): $0.01 × 0.9 + $0.10 × 0.1 + $0.50 × 0.2 = $0.119
- DeepSeek V4.1-Flash 비혼잡 시간(캐시 적중 $0.003): $0.003 × 0.9 + $0.15 × 0.1 + $0.60 × 0.2 = 약 $0.138
캐시 저장료는 캐시해 둔 토큰 양과 시간에 비례합니다. 1만 토큰짜리 시스템 프롬프트를 1시간 유지하면 $0.01이므로, 호출이 많을수록 부담이 작아집니다. 캐시를 써도 출력 단가가 그대로라 2.5 모델을 써 온 사용자에게는 2.5 Flash-Lite가 앞서고, 새 프로젝트에서는 3.1 Flash-Lite가 Luna의 약 3배라는 구도가 바뀌지 않습니다.
Batch로 돌리면 모두 절반, 차이도 절반
Gemini의 Batch·Flex, GPT-6 Luna의 Batch·Flex, Claude Haiku 5.5의 Batch는 모두 표준 요금의 절반입니다. 2.5 Flash-Lite는 $0.05/$0.20, 3.1 Flash-Lite는 $0.125/$0.75, Luna와 Haiku 5.5는 $0.05/$0.25가 되어 상대적인 순위는 그대로입니다. 결과를 바로 받지 않아도 되는 작업이라면 회사를 바꾸기보다 지금 쓰는 API에서 Batch로 돌리는 것이 비용을 반으로 줄이는 가장 쉬운 방법입니다.
DeepSeek은 한국 업무 시간이 혼잡 요금 구간이다
DeepSeek V4.1-Flash는 혼잡 시간 요금이 비혼잡 시간의 두 배입니다. 혼잡 시간은 월금 UTC 01:0004:00, 06:0010:00으로, 한국 시간으로는 평일 오전 10시오후 1시와 오후 3시~7시입니다. 낮에 실시간으로 호출하는 서비스라면 $0.30/$1.20을 기준으로 봐야 하고, 이때 1M 입력 + 200K 출력 작업은 $0.54로 2.5 Flash-Lite($0.18)의 3배이고, 새 프로젝트의 Gemini 최저가인 3.1 Flash-Lite($0.55)와 거의 같습니다. 밤이나 주말에 몰아서 돌리는 배치 작업이라면 $0.15/$0.60으로 Mistral Small 4와 같은 수준까지 내려갑니다.
GPT-6 Luna와 Claude Haiku 5.5는 Gemini보다 싼가
2.5 Flash-Lite를 쓸 수 있는 사용자에게는 둘 다 더 싸지 않습니다. 입력 $0.10은 같고 출력은 $0.50 대 $0.40입니다. 대신 Gemini 3.x Flash 계열과 비교하면 크게 쌉니다. 3.8 Flash를 쓰는 서비스를 Luna로 옮기면 1M + 200K 작업 기준 $1.50이 $0.20이 됩니다. 다만 같은 작업을 2.5 Flash-Lite로 내리면 $0.18이므로, 이 비교만으로는 Gemini를 떠날 이유가 생기지 않습니다. 반대로 2.5 모델을 써 본 적이 없는 새 프로젝트라면 Gemini 최저가가 3.1 Flash-Lite($0.55)이므로 Luna·Haiku 5.5($0.20)가 약 64% 쌉니다.
Luna나 Haiku 5.5를 고를 이유는 OpenAI 또는 Anthropic 생태계를 이미 쓰고 있거나, 내 작업에서 품질 차이가 확인된 경우입니다. 그 판단은 단가표가 아니라 내 프롬프트로 직접 돌려 본 결과로 해야 합니다. Luna를 상위 모델과 함께 보고 싶다면 GPT-6 Luna와 Sol 가격 비교: API 요금과 Codex 크레딧을 참고하세요. 이전 세대 Claude Haiku 4.5($1/$5)는 레거시 모델이 되었으므로 저가 비교에서는 Haiku 5.5를 기준으로 삼아야 합니다.
DeepSeek·Mistral Small 4·Groq: 텍스트 전용이라면 어디까지 싸지나
Groq 는 아래 세 곳 중 유일하게 2.5 Flash-Lite보다 싼 경로입니다. GPT OSS 20B가 $0.075/$0.30, 더 큰 GPT OSS 120B가 $0.15/$0.60입니다. 예전에 $0.05/$0.08로 공개되어 있던 Llama 3.1 8B와 Llama 3.3 70B는 이제 공개 가격 없이 엔터프라이즈 문의로 바뀌었습니다. GPT OSS 20B는 텍스트 모델이므로 분류, 추출, 짧은 요약처럼 텍스트만 오가는 대량 작업을 맡기는 용도입니다.
Mistral Small 4 는 $0.15/$0.60입니다. 이전 저가 선택지였던 Mistral Small 3.2($0.10/$0.30)는 2026년 7월 31일에 종료되었고 Small 4가 후속 모델입니다. 지금 요금으로는 입력과 출력 모두 2.5 Flash-Lite보다 50% 비쌉니다.
DeepSeek 은 deepseek-flash(DeepSeek V4.1-Flash)가 입력 $0.15~$0.30, 출력 $0.60~$1.20이고 캐시 적중 입력은 $0.003~$0.006입니다. 컨텍스트는 100만 토큰, 최대 출력은 38.4만 토큰입니다. 예전 모델 이름으로 호출해도 V4.1-Flash가 V4.1-Flash 요금으로 응답합니다. 예전 V3.2의 $0.28/$0.42 같은 요금은 더 이상 적용되지 않습니다.
정리하면 텍스트 전용 작업에서 단가로 2.5 Flash-Lite를 이기는 곳은 Groq GPT OSS 20B이고, 그 폭은 입력 25%, 출력 25%입니다. 새 프로젝트의 기준인 3.1 Flash-Lite($0.25/$1.50)와 비교하면 세 곳 모두 출력 단가가 더 낮습니다. 월 비용이 수십 달러 수준이라면 이 차이가 옮기는 데 드는 작업 시간을 넘기 어렵습니다.
429 오류와 할당량 문제는 가격 문제가 아니다
Gemini를 떠나려는 이유가 요금보다 429 오류인 경우도 많습니다. 이때는 다른 회사로 옮기기 전에 한도가 어떻게 계산되는지부터 보는 것이 맞습니다. Google의 한도 문서에 따르면 다음과 같습니다.
- 한도는 API 키가 아니라 프로젝트 단위 로 적용됩니다. 같은 프로젝트에서 키를 여러 개 만들어도 한도는 늘지 않습니다.
- 하루 요청 수(RPD)는 미국 태평양 시간 자정 에 초기화됩니다. 한국 시간으로는 오후 4시이고, 미국 서머타임이 끝나는 2026년 11월 1일 이후에는 오후 5시입니다.
- 실험·프리뷰 모델은 한도가 더 엄격합니다. 3.1 Pro Preview처럼 이름에 Preview가 붙은 모델에서 429가 잦다면 정식 모델로 바꾸는 것만으로 줄어들 수 있습니다.
- 실제 적용 중인 한도는 AI Studio의 한도 페이지에서 확인합니다.
무료 등급에서 429가 반복된다면 결제를 연결해 유료 등급으로 올리는 것이 먼저이고, 그래도 부족할 때 다른 회사를 백업 경로로 붙이는 순서가 비용과 작업량 모두에서 낫습니다. 결제 연결과 등급 구조는 Gemini API 키는 사는 것이 아닙니다: 발급, 결제, 등급 가이드에 정리되어 있습니다.
Gemini를 유지하면서 비용을 줄이는 나눠 쓰기 구성
전부 옮기기보다 작업별로 나누는 것이 실제로 가장 많이 아끼는 방법입니다.
- 이미지·영상 입력이 섞이는 작업: Gemini 2.5 Flash-Lite에 둡니다. 이미지와 영상 입력도 텍스트와 같은 $0.10이라 별도 비용이 붙지 않습니다. 새 프로젝트라면 3.1 Flash-Lite가 같은 역할을 하며, 이미지·영상 입력도 텍스트와 같은 $0.25입니다.
- 텍스트만 오가는 대량 분류·추출: Groq GPT OSS 20B로 나눌 수 있습니다.
- 즉시 응답이 필요 없는 작업: 어느 회사든 Batch로 돌려 절반으로 줄입니다.
- 긴 문서 입력: Haiku 5.5는 10만 토큰을 넘기지 않게 나누거나, Luna로 보냅니다. 2.5 모델을 써 온 사용자라면 2.5 Flash-Lite도 Luna와 거의 같은 비용입니다.
나눠 쓰는 데 드는 코드 수정은 생각보다 적습니다. Gemini는 OpenAI 라이브러리로 호출할 수 있는 호환 엔드포인트를 제공하고, base_url을 https://generativelanguage.googleapis.com/v1beta/openai/로 바꾸고 Gemini API 키를 넣으면 됩니다. 이 호환 기능은 아직 베타입니다. Groq도 https://api.groq.com/openai/v1로 OpenAI 라이브러리를 그대로 쓸 수 있고(logprobs 등 일부 파라미터 미지원), DeepSeek은 https://api.deepseek.com으로 OpenAI 형식을 지원합니다.
결국 옮기는 비용은 SDK보다 프롬프트 재조정과 출력 품질 검증에서 나옵니다. 월 비용 차이가 그 작업 시간보다 클 때만 옮기는 것이 맞습니다. Gemini, OpenAI, Claude 상위 모델까지 포함한 전체 비용 비교는 Gemini API vs OpenAI vs Claude: 2026년 완벽 비용 비교 가이드를 참고하세요.
자주 묻는 질문
지금 가장 싼 Gemini API는 무엇인가요?
2.5 모델을 과거에 사용한 적이 있는 사용자라면 Gemini 2.5 Flash-Lite($0.10/$0.40), 새 프로젝트라면 Gemini 3.1 Flash-Lite($0.25/$1.50)입니다(2026년 10월 10일 기준, 100만 토큰당 표준 요금). Google은 2026년 9월 18일부터 2.5 모델을 이전 사용자에게만 제공합니다. Batch로 돌리면 2.5 Flash-Lite는 $0.05/$0.20, 3.1 Flash-Lite는 $0.125/$0.75이고 둘 다 무료 등급이 있습니다. 3.1 Flash-Lite의 가장 이른 종료일은 2027년 5월 7일이며 후속 모델은 3.5 Flash-Lite입니다. Gemma 4는 무료 등급으로만 제공되어 유료로 확장할 수 없습니다.
Gemini 2.5 Flash API 가격은 얼마인가요?
2026년 10월 8일 기준 100만 토큰당 입력 $0.30, 출력 $2.50이고 오디오 입력은 $1.00이며, 2.5 모델을 과거에 사용한 적이 있는 사용자만 호출할 수 있습니다. 무료 등급이 있고 Batch·Flex는 절반입니다. 출력이 짧은 작업이라면 2.5 Flash-Lite($0.10/$0.40)로 바꾸는 것만으로 출력 비용이 6분의 1 아래로 줄어듭니다. 2.5 모델을 써 본 적이 없는 새 프로젝트라면 Gemini에서 가장 싼 텍스트 모델은 3.1 Flash-Lite($0.25/$1.50)입니다.
가장 저렴한 AI API는 무엇인가요?
위에서 비교한 경로 중 표준 요금이 가장 낮은 곳은 Groq GPT OSS 20B($0.075/$0.30)이고, 그 다음은 2.5 모델을 써 온 사용자라면 Gemini 2.5 Flash-Lite($0.10/$0.40), 새 프로젝트라면 GPT-6 Luna와 Claude Haiku 5.5($0.10/$0.50)입니다. 새 프로젝트가 쓸 수 있는 가장 싼 Gemini인 3.1 Flash-Lite($0.25/$1.50)는 Mistral Small 4나 DeepSeek 비혼잡 시간($0.15/$0.60)보다도 비쌉니다. 다만 GPT OSS 20B는 텍스트 모델이고, Haiku 5.5는 프롬프트가 10만 토큰을 넘으면 5배, DeepSeek은 한국 평일 낮 시간에 두 배가 되므로 작업 형태에 따라 순서가 바뀝니다.
무료 AI API 중 어떤 것을 추천하시나요?
요금을 내기 전에 시험해 보려는 목적이라면 Gemini API 무료 등급에서 시작하기 쉽고, 2.5 모델을 써 본 적이 없는 새 프로젝트라면 3.1 Flash-Lite나 3.8 Flash처럼 3.x 모델로 시험하면 됩니다. 모델별 무료 등급 여부가 가격표에 공개되어 있고, 2.5 Flash-Lite, 3.1 Flash-Lite, 2.5 Flash, 3.8 Flash, 2.5 Pro 등 대부분의 Gemini 모델과 Gemma 4가 무료 등급을 지원합니다. 다만 2.5 모델은 과거에 사용한 적이 있는 사용자만 쓸 수 있습니다. 3.1 Pro Preview는 무료 등급이 없습니다. 모델별 하루 한도는 AI Studio에서 프로젝트별로 표시됩니다.
Gemini 3.1 Flash-Lite가 2.5 Flash-Lite보다 싼가요?
단가로는 아닙니다. 3.1 Flash-Lite는 $0.25/$1.50, 2.5 Flash-Lite는 $0.10/$0.40이지만, 2.5 모델을 써 본 적이 없는 새 프로젝트에는 3.1 Flash-Lite가 가장 싼 Gemini 텍스트 모델입니다. 1M 입력 + 200K 출력 기준으로 $0.55 대 $0.18이라 약 3배 차이가 납니다.
OpenAI 라이브러리를 계속 쓰려면 Gemini를 떠나야 하나요?
그렇지 않습니다. Gemini는 OpenAI 호환 엔드포인트를 제공하므로 base_url과 API 키, 모델 이름만 바꾸면 기존 OpenAI 라이브러리 코드로 Gemini를 호출할 수 있습니다. 이 기능은 2026년 10월 8일 기준 베타입니다.