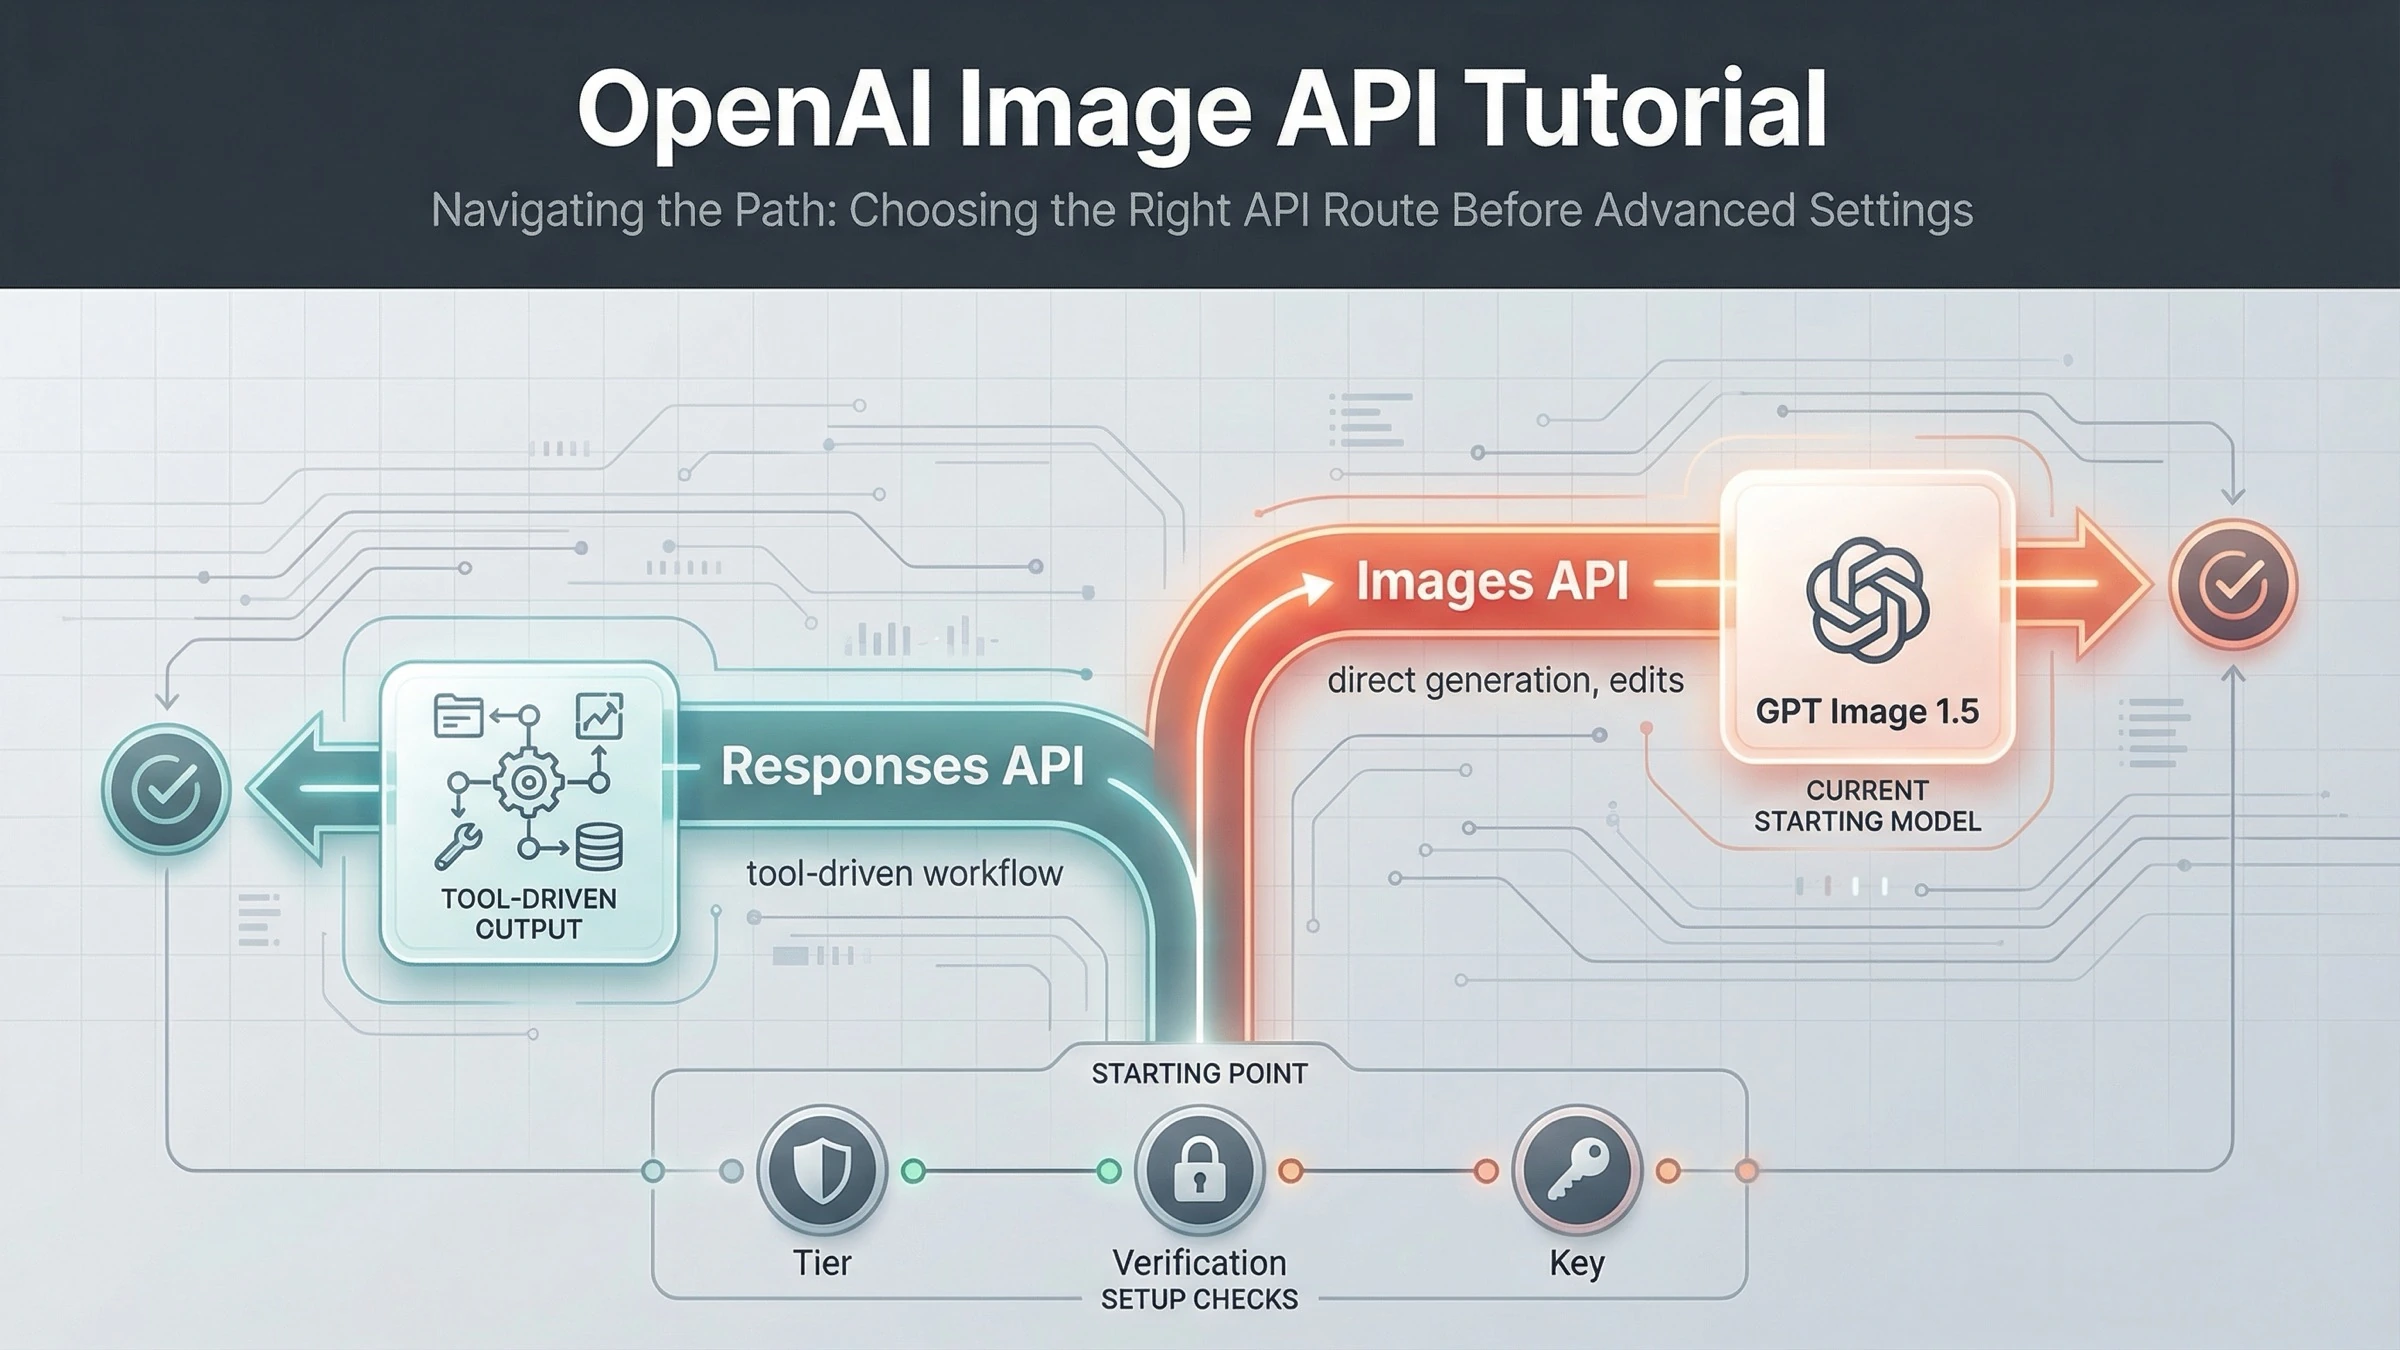
2026年10月9日時点で、OpenAIの公開APIで画像を扱うendpointは二つだけです。プロンプトから生成するならPOST https://api.openai.com/v1/images/generations、手元の画像を編集・合 成するならPOST https://api.openai.com/v1/images/editsを呼びます。どちらもmodelには現行のgpt-image-2.5-flare(速さ重視の日常用途 )かgpt-image-2.5-sunburst(編集精度重視)を指定し、画像はレスポンス本文にbase64で返るので、受け取ったバイト列はその場で自分の保存先に書き出します。会話や複数ステップの処理の一部として画像を作るときだけ、Responses APIのimage_generationツールに切り替えます。
もう一つ、先に答えておきます。ChatGPTの会話データに残るgen_id、parent_gen_id、referenced_image_ids、asset_pointer(file-service://file-…形式)を受け取って画像を返す公開endpointは存在しません。これらはChatGPT製品内部のimage_genツールが使う識別子で、Images APIにもResponses APIにもそれを引く仕組みがありません。画像を手に入れる正規の経路は、ChatGPTの画面やライブラリから保存する、設定からデータをエクスポートする、APIで作り直して自分で保存する、の三つです。なぜそうなるのかと、ChatGPT側の各フィールドがAPI側の何に相当するのかは「ChatGPTのgen_id・asset_pointerで画像を取り出せるか」の章で整理します。
endpoint一覧:generations、edits、Responsesツール、gen_id
Images APIリファレンスに載っている画像のendpointは、生成(generations)と編集(edits)の二つです。以前あったPOST /v1/images/variationsは「This endpoint is retired and no longer available」と明記され、GPT Imageモデルでプロンプトを添えてeditsを呼ぶのが代替です。画像をIDで後から取り直すGETの類は、リファレンスに存在しません。
| やりたいこと | 呼ぶもの | modelに入れる値 | 画像の返り方 | 補足 |
|---|---|---|---|---|
| プロンプトから画像を生成する(1回で1〜10枚) | POST https://api.openai.com/v1/images/generations | gpt-image-2.5-flareまたはgpt-image-2.5-sunburst(省略不可) | data[].b64_json | url形式はGPT Imageモデルでは使えない |
| 既存画像を編集・合成する(入力最大16枚) | POST https://api.openai.com/v1/images/edits | 省略時はgpt-image-2.5-sunburst | data[].b64_json | maskはimage_urlかfile_idで渡す |
| バリエーションを作る | /v1/images/variationsは廃止 | — | — | editsにプロンプトを添えて代替 |
| 会話・エージェントの一部として画像を作る | Responses API(client.responses.create())+tools: [{ type: "image_generation" }] | 上位modelはgpt-5以降のテキストモデル、ツール側modelにgpt-image-2.5-* | image_generation_callのresult(base64)とid | previous_response_idで続きの編集 |
ChatGPTのgen_idやasset_pointerから画像を取得する | 該当するendpointは無い | — | — | 画面・エクスポート・API再生成の三経路 |
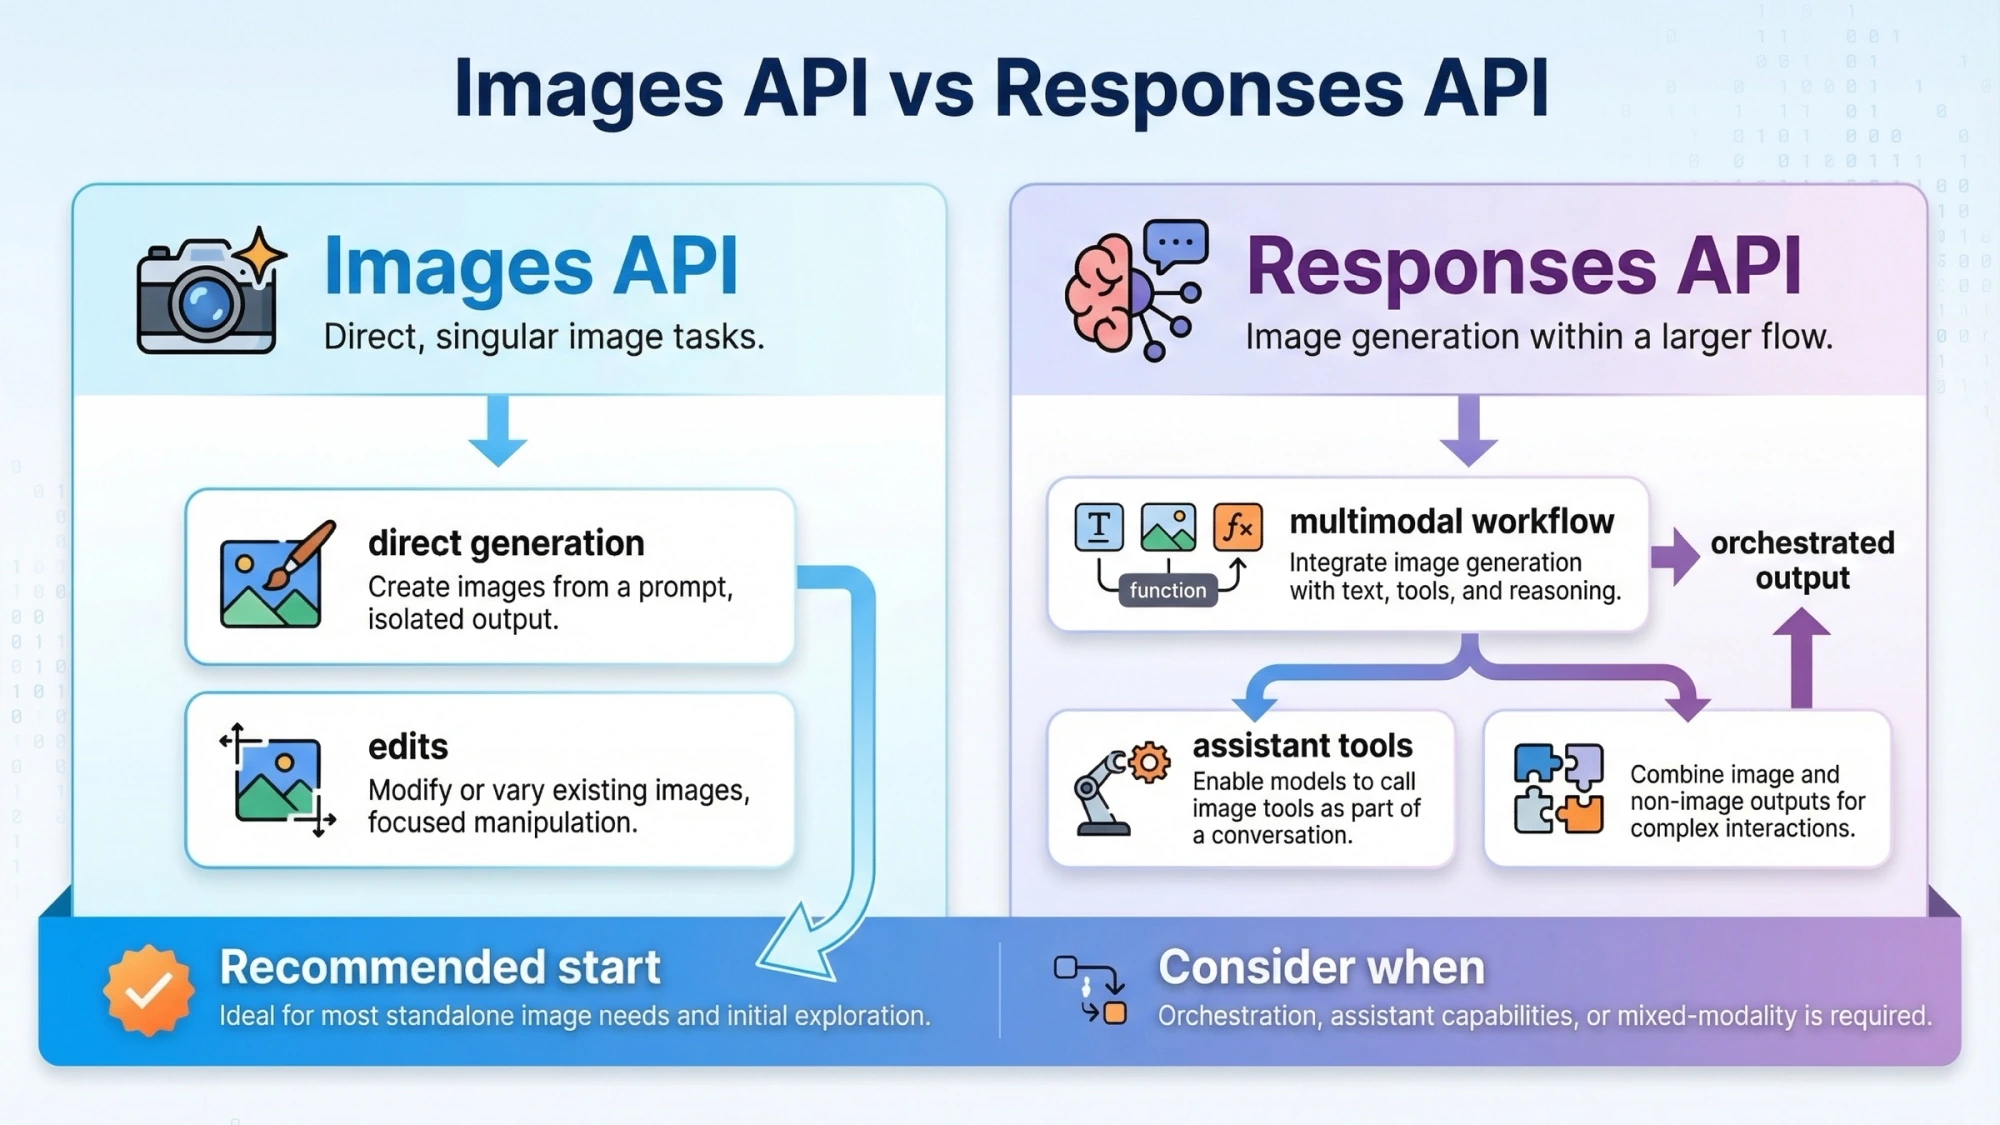
使い分けの基準は画像生成ガイドがそのまま書いています。「一つのプロンプトから1枚を生成・編集するだけならImage APIが最適」、会話や複数ステップの流れに組み込むならResponsesのimage_generationツール、という二本立てです。迷ったらImages APIから始めるほうがリクエストもデバッグも短く、Responsesは上位モデルの呼び出しとツール出力の取り出しが一層増えるぶん、必要になってから移れば十分です。
モデルの選び方そのものに迷っているなら、OpenAI Image Generation API Models:2026年のモデル一覧と選び方が各GPT Imageモデルの比較です。このページはendpointの選択と、ChatGPT側の識別子で何ができるかに絞ります。
単発生成はPOST /v1/images/generationsにgpt-image-2.5を指定
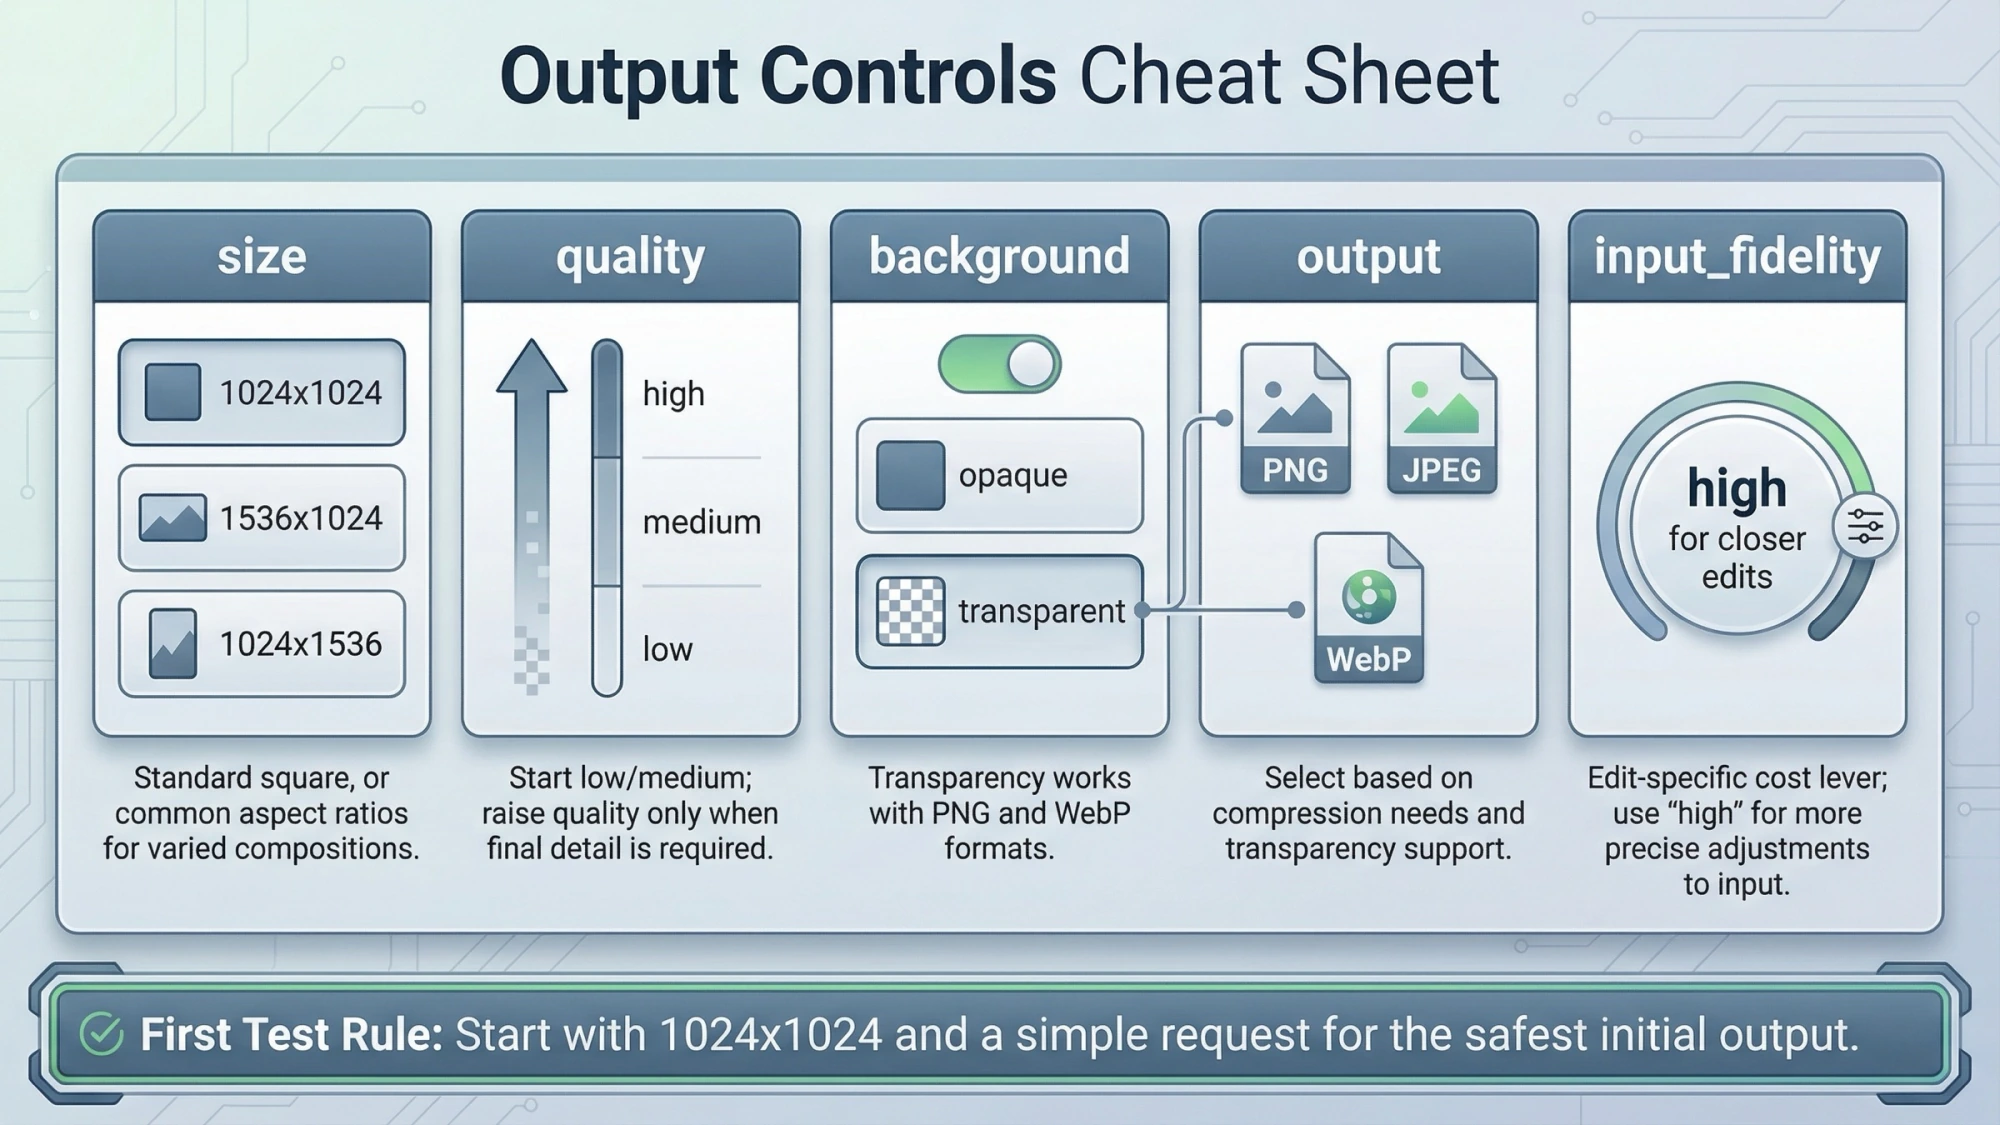
新規の実装で最初に動かすべきなのがこのendpointです。modelは省略できず(リファレンスは「Specify a model explicitly」としています)、現行ならgpt-image-2.5-flareかgpt-image-2.5-sunburstを入れます。最初のリクエストは1プロンプト・正方形・quality: "medium"程度に抑えておくと、APIキー、プロジェクト、モデルへのアクセス、ペイロードの形のどこが悪いかを切り分けやすくなります。
curl https://api.openai.com/v1/images/generations \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-image-2.5-flare",
    "prompt": "Create a clean editorial illustration of a robot camera operator in a bright studio",
    "size": "1024x1024",
    "quality": "medium"
  }'
ここで見落としやすい点が一つあります。GPT Imageモデルは画像を常にbase64で返します。リファレンスのdata[].b64_jsonは「Returned by default for GPT image models」、response_formatは「廃止済みモデル向けのレガシーなパラメータ」、urlは「GPT Imageモデルでは未対応」です。つまりHTTP 200が返っただけでは成功ではなく、b64_jsonをデコードしてファイルに書けた時点が成功です。サーバー側に画像の取り置きは無いので、ここで保存しなかった画像を後からIDで取り直すことはできません。
import fs from "node:fs";
import OpenAI from "openai";

const client = new OpenAI({ apiKey: process.env.OPENAI_API_KEY });

const result = await client.images.generate({
  model: "gpt-image-2.5-flare",
  prompt: "Create a clean editorial illustration of a robot camera operator in a bright studio",
  size: "1024x1024",
  quality: "medium",
});

fs.writeFileSync("robot.png", Buffer.from(result.data[0].b64_json, "base64"));
console.log(result.usage); // input_tokens / output_tokens / total_tokensレスポンスにはusage(入力トークンの画像・テキスト内訳と出力トークン)、created、size、quality、output_format、backgroundが付きます。GPT Imageモデルはrevised_promptを返しません。
主なパラメータは次のとおりです(generations・edits共通、2026年10月9日時点のリファレンスとガイドの値)。
size:auto、1024x1024、1536x1024、1024x1536。gpt-image-2では任意のWIDTHxHEIGHTも指定でき、長辺3,840px以下、両辺16の倍数、長短比3:1以内、総ピクセル655,360〜8,294,400の範囲です。quality:low、medium、high、auto。xhighとmaxはgpt-image-2.5系のみ。output_format:png(既定)、jpeg、webp。output_compressionは0〜100でjpeg・webpに適用。background:transparent、opaque、auto。透過はpngかwebpが必要で、gpt-image-2では「プレビュー」扱い。n:1〜10。partial_images:0〜3(streamと併用)。moderation:autoかlow。promptは32,000文字まで。
料金はトークン単価で決まります。GPT Image 2.5は画像入力$8/100万トークン、画像出力$30/100万トークン、テキスト入力$5/100万トークンで、ガイドは「単価が同じでも1枚あたりの費用は同じにならない」と注意しています。GPT Image 2.5には1枚あたりの固定の単価表が無く、ガイドの料金計算の計算ツールでモデル・品質・サイズを選んで見積もります。一方gpt-image-2には公式の1枚単価表があり、低品質$0.006(1024×1024)/$0.005(1024×1536・1536×1024)、中品質$0.053/$0.041、高品質$0.211/$0.165です。1枚いくらになるかの目安と予算の立て方はGPT Image 2のAPI料金はいくら?1枚の目安と制作費の計算方法に任せます。
生成と編集の両方の最小リクエストをコピーして試したいなら、OpenAI Image Generation API cURL: 現在使える生成リクエストと編集リクエストがそのまま使えます。
画像の編集はPOST /v1/images/edits(variationsは廃止済み)
「画像生成endpoint」を探していても、実際にやりたいのが手元の画像の修正であることは多いです。その場合もImages APIのままで、生成ではなく編集のendpointに移るだけです。Images APIリファレンスのPOST /v1/images/editsは、GPT Imageモデルで入力画像を最大16枚受け取り、任意でmask(image_urlまたはfile_id)を添えられます。modelを省略するとgpt-image-2.5-sunburstが使われ、ガイドもこのモデルを「編集精度を最重視する場合」の選択としています。
import fs from "node:fs";
import OpenAI from "openai";

const client = new OpenAI({ apiKey: process.env.OPENAI_API_KEY });

const result = await client.images.edit({
  model: "gpt-image-2.5-sunburst",
  image: [fs.createReadStream("product-shot.png")],
  prompt: "Keep the product shape, but place it on a clean studio shelf with warm lighting",
});

fs.writeFileSync("product-shelf.png", Buffer.from(result.data[0].b64_json, "base64"));編集だけにある指定がinput_fidelity(high/low)です。入力画像の顔やロゴをどれだけ忠実に保つかの指定で、gpt-image-1-miniはlowのみ、gpt-image-2ではガイドが「省略すべき」としています。gpt-image-2は常に高忠実度で処理するため、参照画像を使う編集では入力トークンが多めになります。
旧POST /v1/images/variationsに依存していたコードは、editsに「同じ構図で別案を」といったプロンプトを添える形に書き換えます。dall-e-2・dall-e-3は2026年5月12日に停止しているので、variationsと一緒に残っているdall-eのモデル指定もこの機会に置き換えます。
会話の一部ならResponses APIのimage_generationツール
Responsesに移る理由は「新しいから」ではなく、指示を読み、他のツールを呼び、会話の状態を保ちながら、その一部として画像を作る必要があるからです。image_generationツールのガイドに沿った形は次のとおりです。
import fs from "node:fs";
import OpenAI from "openai";

const client = new OpenAI({ apiKey: process.env.OPENAI_API_KEY });

const response = await client.responses.create({
  model: "gpt-5.5",
  input: "Generate a sticker-style icon of a paper airplane for a travel app",
  tools: [{ type: "image_generation", model: "gpt-image-2.5-sunburst" }],
});

const call = response.output.find((item) => item.type === "image_generation_call");
fs.writeFileSync("icon.png", Buffer.from(call.result, "base64"));
console.log(call.id); // 例: ig_...
押さえる点は四つです。
- 上位の
modelはテキストモデルで、GPT Imageモデルはツール側のmodelに入れます。gpt-image-2.5-sunburstを上位modelに書くのが最も多い間違いです。ツール側はgpt-image-2.5-sunburst、gpt-image-2.5-flare、gpt-image-2、gpt-image-1.5、gpt-image-1、gpt-image-1-miniを受け付けます。 - 上位モデルの要件は、画像生成ガイドが「gpt-5以降」と書く一方、ツールのガイドの対応一覧にはgpt-4oやgpt-4.1系も載っていて、二つのページが一致していません。現行のgpt-5系以降を使い、採用するモデルのページで対応を確認するのが安全です。
- 画像は
image_generation_call項目のresultにbase64で入り、id(例:ig_…)とrevised_promptが付きます。ここでもバイト列の保存は自分の仕事で、idは同じ会話の中で続きの編集を指すための手がかりに使います。 - 続きの編集は
previous_response_idを渡すか、入力に{"type": "image_generation_call", "id": "..."}を含めて新しい指示を送ります。actionはauto/generate/editで、文脈に画像が無い状態でeditを指定するとエラーになります。
const followUp = await client.responses.create({
  model: "gpt-5.5",
  previous_response_id: response.id,
  input: "Make the airplane blue and add a small cloud behind it",
  tools: [{ type: "image_generation", model: "gpt-image-2.5-sunburst" }],
});partial_imagesを1〜3にするとresponse.image_generation_call.partial_imageイベントで途中画像(partial_image_b64)が流れ、tool_choice: {"type": "image_generation"}で画像生成を強制できます。費用面では、画像入力のキャッシュ単価($2/100万トークン)が適用されるのはこのツール経由だけで、/v1/images/*の直接呼び出しには適用されません。代わりにResponsesでは上位モデルのトークンも課金され、途中画像1枚ごとに出力100トークンが加算されます。
ChatGPTのgen_id・asset_pointerで画像を取り出せるか
公開APIからは取り出せません。gen_idを受け取って画像を返すendpointは、Images APIリファレンスにもResponses APIにも存在せず、OpenAIの公開ドキュメントにそのような取得手段の記載もありません。gen_idはファイル名でもダウンロード用の資格情報でもなく、ChatGPT製品の内部で画像生成ツール(会話データではimage_genという名前で見えます)が生成物に付ける識別子です。
ChatGPT側で見かける各フィールドの意味を整理すると、次のようになります。
gen_id:ChatGPT内部で1回の生成に付くID。DALL·E 3時代(2023〜2024年)には、ユーザーがモデルにgen_idを尋ね、次のプロンプトでreferenced_image_idsに渡してキャラクターの一貫性を保つ使い方が見られました。parent_gen_id:その画像がどの生成物を編集して作られたかを指す、編集の系譜です。referenced_image_ids(reference_image_idsと書かれることもあります):参照画像として渡したgen_idの一覧。ChatGPTのツール呼び出しのフィールドで、APIのパラメータではありません。asset_pointer:file-service://file-…形式の、ChatGPT側ストレージ上の画像を指す参照です。エクスポートした会話データ(conversations.json)にimage_asset_pointerとして現れ、同じfile-…IDがアーカイブ内の画像ファイルと対応している、とユーザー側の報告(2026年7月)が述べています。backend-api:ChatGPTのWebクライアントがサーバーと通信する非公開のインターフェースで、api.openai.comの公開APIとは別物です。そこから得られる画像リンクは期限付きの署名URLで、時間が経つと無効になると報告されています。公開されたAPIではないので、ここに依存した取得処理を組むべきではありません。
画像の実体がどこにあり、どの識別子が見え、何ができるかを並べると、ChatGPTとAPIの差がはっきりします。
| 場所 | 画像の実体 | 見える識別子 | できること |
|---|---|---|---|
| ChatGPT(Web・アプリ) | ChatGPT側のストレージ | gen_id、parent_gen_id、referenced_image_ids、asset_pointer | 画面やライブラリから保存、データエクスポート |
| Images API(generations・edits) | レスポンス本文のbase64のみ。サーバー側の取り置き無し | 無し(createdのタイムスタンプだけ) | 受信時に保存する。後からの取り直しは不可 |
Responses API(image_generation) | image_generation_call.resultのbase64 | id(ig_…)、previous_response_id | 同じ会話で続きの編集にidを渡す。画像自体の保存は自分で行う |
gen_idしか残っていないときに画像を取り出す三つの経路
- ChatGPTの画面またはライブラリから保存する。該当する会話を開くか、ライブラリで画像を選んでダウンロードします。画像がまだ表示できるなら、これが最短です。
- データをエクスポートする。ChatGPTの履歴とデータのエクスポートの手順どおり、設定の「Data controls」にある「Export data」(またはプライバシーポータル)を使います。Free・Go・Plus・Proと対象のEduアカウントが利用でき、Business・Enterprise・Healthcareのワークスペースは対象外です。準備には最長7日かかり、届いたダウンロードリンクは受信から24時間で失効します。ZIPには「チャット履歴とその他の関連するアカウントデータ」が含まれると書かれていて、生成画像が含まれるかはヘルプページに明記がありません。先述の報告では
conversations.jsonのimage_asset_pointerとアーカイブ内の画像ファイルが対応するとされているので、届いたZIPでその対応を確認してください。削除済みの会話は復元できません。 - APIで作り直して自分で保存する。
gen_idをAPIに渡して同じ画像を取り出すことはできないので、プロンプト(ChatGPT側のrevised_prompt相当の文章があればそれ)から/v1/images/generationsで再生成し、返ってきたbase64を保存します。同一の画像になることは保証されず、以後は自分のストレージのIDで管理する前提に切り替わります。
ChatGPT側のフィールドをAPIの仕組みに対応させると、次の表になります。ChatGPTで組んでいた流れをAPIに移すときの読み替え表として使えます。
| ChatGPT側で見えるもの | 役割 | API側で相当するもの |
|---|---|---|
gen_id | 1回の生成に付くID | Responsesのimage_generation_callのid(ig_…)。Images APIには相当するものが無い |
parent_gen_id | 編集元の生成物 | previous_response_id、または入力に含めるimage_generation_callのid |
referenced_image_ids | 参照画像で一貫性を保つ | /v1/images/editsのimage(最大16枚、ファイルIDかbase64)、またはResponsesの多ターン編集 |
asset_pointer(file-service://) | ChatGPT側ストレージへの参照 | 相当するものは無い。APIはbase64を返すだけで保存先を持たない |
image_gen | ChatGPT内のツール名 | Responsesのimage_generationツール |
backend-api | ChatGPT Webクライアントの非公開インターフェース | https://api.openai.com/v1/…の公 開API |
ChatGPTの画面側で画像生成そのものが失敗していて、そもそもgen_id以前の問題なら、ChatGPTで画像生成できないときは、まず原因の分岐を切り分けるのほうが当てはまります。
gpt-image-1は10月23日、1.5は12月1日に停止:移行先は2.5
既存コードのmodelが旧IDのままなら、endpointを調べるより先にここを直します。非推奨化の一覧の2026年10月9日時点の内容です。
| モデルID | 発表日 | 停止日 | 推奨される移行先 |
|---|---|---|---|
gpt-image-1 | 2026年4月22日 | 2026年10月23日 | gpt-image-2.5-sunburstまたはgpt-image-2.5-flare |
gpt-image-1.5 | 2026年6月2日 | 2026年12月1日 | 同上 |
gpt-image-1-mini | 2026年6月2日 | 2026年12月1日 | 同上 |
chatgpt-image-latest | 2026年6月2日 | 2026年12月1日 | 同上 |
dall-e-2、dall-e-3 | 2025年11月14日 | 2026年5月12日(停止済み) | 当時の案内はgpt-image-2/gpt-image-1/gpt-image-1-mini |
gpt-image-2 | — | 非推奨化の予定なし | — |
リファレンスのmodelの列挙にはdall-e-2やdall-e-3、gpt-image-1が今も載っていますが、一覧にあることと呼べることは別です。停止日を過ぎたIDはリクエストが通りません。
chatgpt-image-latestは「以前ChatGPTで使われていた画像モデルのスナップショット」を指すIDで、モデルページはAPI利用にはGPT Image 2.5 Sunburstを推奨しています。モデルページには1枚あたりの価格も載っていて、1024×1024で低品質$0.009、中品質$0.034、高品質$0.133、1024×1536または1536×1024でそれぞれ$0.013、$0.05、$0.20です。費用感の基準にはなりますが、12月1日に停止するので新規採用はしません。
移行時にコードで変わるのは、modelの文字列、qualityにxhigh/maxが追加されること、そして編集でinput_fidelityをgpt-image-2に付けないことです。endpointのパスとレスポンスの形(data[].b64_json)は変わりません。
endpointが正しいのに失敗するときの5つの確認
パスを疑う前に、失敗の原因になりやすい順で確認します。
modelが停止済みか省略されていないか。generationsには既定モデルが無いので省略はエラーになり、gpt-image-1は2026年10月23日以降は通らなくなります。response_format: "url"を送っていないか。GPT Imageモデルでは未対応で、base64しか返りません。urlを期待して書かれた旧dall-e時代のコードはここで止まります。- Responsesで
gpt-image-2.5-*を上位のmodelに入れていないか。上位はテキストモデル、GPT Imageはツール側のmodelです。 - エラーコードが
moderation_blockedなら、入力または出力がコンテンツ方針で止められています。レスポンスのmoderation_detailsにcategoriesとmoderation_stage(input/output)が入るので、どちらの段階で止まったかを見てプロンプトや入力画像を見直します。 - editsで
input_fidelityをgpt-image-2に付けていないか、gpt-image-2の任意サイズが16の倍数・長短比3:1以内・総ピクセル655,360〜8,294,400に収まっているか。
ここまで通っていてなお失敗するなら、問題はendpointではなくアカウントや組織側の設定にあります。endpointを別のものに替えても直りません。
endpointとgen_idについてよくある疑問
ChatGPT APIで画像生成はできますか?
「ChatGPT API」という名前の製品は無く、ChatGPTと同じ系統の画像モデルをプログラムから使う手段がOpenAIのImages APIとResponses APIです。ChatGPTの画像生成をコードから呼びたいという意味なら、POST /v1/images/generationsにgpt-image-2.5-flareかgpt-image-2.5-sunburstを指定するのが答えです。経緯と最初の一歩はChatGPT APIで画像生成するなら、まずOpenAI Images APIにまとまっています。
普通の画像編集でもResponses APIが必要ですか?
いいえ。入力画像を渡して直す、合成する、背景を変えるといった編集はPOST /v1/images/editsの正式な仕事で、入力は最大16枚、maskも使えます。Responsesが必要になるのは、編集が会話や複数ツールの流れの一部になったときだけです。
レスポンスで画像のURLを受け取れますか?
GPT Imageモデルでは受け取れません。response_formatは廃止済みモデル向けのレガシーなパラメータで、urlは未対応です。画像はdata[].b64_json(Responsesならimage_generation_call.result)のbase64をデコードして保存します。保存しなかった画像を後からIDで取り直す手段はありません。
referenced_image_idsはOpenAI APIのドキュメントにありますか?
ありません。referenced_image_idsはChatGPT内部の画像生成ツールのフィールドで、Images APIにもResponses APIにもそのパラメータはありません。参照画像を使って一貫性を保ちたいなら、/v1/images/editsに画像(ファイルIDかbase64、最大16枚)を渡すか、Responsesでprevious_response_idを使って同じ会話の中で編集を重ねます。
gpt-image-1を指定している既存コードはいつまで動きますか?
2026年10月23日の停止日までです。gpt-image-1.5、gpt-image-1-mini、chatgpt-image-latestは2026年12月1日まで。移行先はいずれもgpt-image-2.5-sunburstまたはgpt-image-2.5-flareで、endpointのパスとbase64のレスポンス形式は変わらないため、modelの文字列を差し替えてqualityやinput_fidelityの指定を見直せば移行できます。