OpenAIのDecisions APIは、文章や画像を渡すと「条件に当てはまる確率」「決めておいた選択肢のどれか」「段階評価のスコア」を返す判定専用のAPIです。中身はGPT-6 Lunaで、2026年10月6日(米国時間)から公開ベータになりました。OpenAIの変更履歴に同日付で「Decisions APIをgpt-6-lunaでベータ公開」と載り、公式ガイドには「数週間以内にGA(一般提供)の予定」と書かれています。DevDay(2026年9月29日)から10月6日までは一部の顧客向けの限定プレビューでしたが、いまは通常のAPIキーで呼べます。
料金は入力トークンだけで、100万トークンあたり$0.10です。出力、キャッシュの読み取り、キャッシュの書き込みには課金されません。入力400トークンの判定なら1回$0.00004、100万回で$40です。ただし、このエンドポイントにはキャッシュ割引がないので、1,000トークンを超える同じ指示文を毎回送るような判定は、Responses APIでLunaを呼んでプロンプトキャッシュを効かせたほうが安くなります。速度と確率の値が必要な判定はDecisions APIへ、長い固定指示や独自のJSONが必要な判定はResponses APIのLunaに残す、というのが2026年10月10日時点の分け方です。
公式ドキュメントは次の3つです。
- Decisionsガイド:質問タイプ、コード例、料金、データ管理
- APIリファレンス「Create a decision」:全パラメータ、制限、レスポンスの型
- Decisions Playground:コードを書く前に質問と入力を試せる画面
Decisions APIでできること:有限の選択肢から1つ選ぶ判定
Decisions APIが答えるのは、文章を書く必要がなく、決まった形の答えで足りる問いです。OpenAIはDevDay 2026で発表した際、OpenAI Developer Communityの告知で、入力の分類、リクエストの振り分け、事前に決めた回答からの行動選択に使うものと説明していました。公開ベータでは、問いの形が3種類に整理されています。
| 質問タイプ | 向いている判定 | 主な戻り値 |
|---|---|---|
predicate(条件判定) | 写真に傷があるか、文書が質問に関係するか | probability:条件が真である確率(0〜1) |
choice(選択) | 担当部署、コンテンツの分類 | choice:指定した値の1つ。加えて選択肢ごとのprobabilitiesとconfidence |
score(段階評価) | 不具合の深刻度、品質のランク | score:段階の番号(0始まり)を確率で重み付けした平均。加えてprobabilitiesとconfidence |
入力にはテキストと画像を使えます。たとえば問い合わせ本文と添付のスクリーンショットを渡し、「どのチームが担当するか」(choice)と「返金を求めているか」(predicate)を1回のリクエストでまとめて聞けます。具体的な用途は次のようなものです。
- 問い合わせの振り分け:請求、配送、技術サポートなど、どのキューに入れるか
- コンテンツ分類・モデレーション:投稿や画像を「公開可・要確認・削除」などに分ける
- 商品写真の検品:目に見える破損があるかどうかを確率で受け取り、しきい値を超えたら人が確認する
- エージェントの次の行動:注文を調べる、確認の質問をする、返信する、人に引き継ぐ、のどれを選ぶか
音声アプリで「戻る・再読み込み・何もしない」のような操作を選ばせる使い方も、Live APIと組み合わせるガイドで紹介されています。
公開ベータで決まったこと・まだ決まっていないこと(2026年10月10日時点)
限定プレビューの間は形式も料金も公開されていませんでしたが、公開ベータでほとんどの項目がドキュメントに載りました。未定のまま残っているのは、GAの日付、GA後の料金、Decisions専用のレート制限などです。
| 項目 | 2026年10月10日時点 |
|---|---|
| 提供状況 | 公開ベータ(2026年10月6日〜)。GAは「数週間以内」の予定で、日付は未発表 |
| モデル | gpt-6-lunaのみ |
| エンドポイント | POST https://api.openai.com/v1/decisions |
| SDK | client.decisions.create(...)。Python 3.26.0、JavaScript 7.30.0、Go 3.73.0、Ruby 0.101.0、Java 4.78.0以降 |
| 料金 | 入力100万トークンあたり$0.10。出力・キャッシュ読み取り・キャッシュ書き込みは課金なし |
| データ管理 | 対象顧客はZDR(データを保持しない設定)とHIPAAに対応。データ所在地・リージョン処理は米国と欧州(EEA+スイス) |
| Decisions専用のレート制限 | 未公開 |
| 1リクエストあたりの質問数の上限 | 未公開 |
| GAの日付とGA後の料金 | 未発表 |
料金はDecisionsガイドの「Pricing and availability」の節にあり、料金ページにはDecisions APIの行がありません。また、GPT-6 Lunaのモデルページの対応エンドポイント表にも、2026年10月10日時点でv1/decisionsは載っていません。料金や対応状況を確かめるときはDecisionsガイドを見るのが確実です。
速度について、OpenAIは「Responses APIより約10倍速い」としていますが、測定条件やベンチマークは公開していません。「約150ms」という数字は報道や基調講演の紹介記事に由来し、ドキュメントには書かれていません。第三者の計測では、DevelopersIO(クラスメソッド)がcurlで5回ずつ呼び、公式のchoiceの例で中央値273ms(入力145トークン)、scoreの例で256msでした。OpenAI Developer Communityの公開ベータのスレッドでは、画像入力で約0.8秒(回線は約3Mbps)という報告もあります。どちらも小さなサンプルで、計測地点も違います。
APIキーで使える?403「Decision API is not enabled」の意味
2026年10月6日以降は、通常のAPIキーで使えます。コミュニティの告知は「すべての開発者向け」の公開ベータとしており、10月7日に計測したクラスメソッドやスレッドの参加者からも、アクセス拒否の報告は出ていません。日本はOpenAI APIの対応国なので、日本のアカウントから直接呼べます。
403「Decision API is not enabled for this user」は、限定プレビュー期間のエラーです。eeselの報告によると、2026年10月1日と2日に通常のキーでPOST https://api.openai.com/v1/decisionsを呼ぶと、どちらの 日もHTTP 403と次の本文が返りました。
{
  "error": {
    "message": "Decision API is not enabled for this user.",
    "type": "invalid_request_error",
    "param": null,
    "code": null
  }
}同じ報告では/v1/decisions/createのような近くのパスは404で、「存在しないパスは404、存在するが開放されていない機能は403」という区別でした。公開ベータ後にこの403が出たという公開の報告は見当たらず、OpenAIのドキュメントにもこのエラーの説明はありません。いま同じエラーが出た場合に確かめる点は、エラーの性質からの推測として次のとおりです。
- SDKが古く、
client.decisionsがない、または別のパスに送っていないか(Pythonなら3.26.0以降) - パスが
/v1/decisionsで、modelがgpt-6-lunaになっているか - 組織やプロジェクトの設定で、使えるモデルやエンドポイントが制限されていないか
無料枠(Free)のまま使えるかどうかは、ドキュメントに書かれていません。使えない場合は、まずSettings > Organization > Limitsで組織の状態を確認してください。
最初のリクエスト:predicate・choice・scoreの書き方
リクエストはmodel、input、questionsの3つでできています。inputはすべての質問に共通の材料で、文字列か、input_textとinput_imageを並べたuserメッセージを渡します。questionsには質問を配列で並べ、それぞれにtype、instructions、識別用のnameを付けます。
以下のコードは公式ガイドとAPIリファレンスのリクエスト形式に沿って組んだ例で、実行結果の値は含めていません。本番に入れる前に、自分のキーとデータで動作を確かめてください。
choiceとpredicateを1回で聞く(Python)
互いに依存しない質問は、同じリクエストにまとめられます。下の例は、問い合わせの担当キュー(choice)と、返金を求めているか(predicate)を同時に聞きます。
from openai import OpenAI  # openai 3.26.0 以降

client = OpenAI()  # 環境変数 OPENAI_API_KEY を使う

decision = client.decisions.create(
    model="gpt-6-luna",
    input="注文 #4471 の代金が二重に引き落とされています。返金してください。",
    questions=[
        {
            "type": "choice",
            "name": "queue",
            "instructions": "この問い合わせを担当するキューはどれか。",
            "choices": [
                {"value": "billing", "description": "支払い、請求書、返金"},
                {"value": "shipping", "description": "配送と追跡"},
                {"value": "technical", "description": "製品の使い方や不具合"},
                {"value": "needs_review", "description": "どれにも当てはまらない、または判断材料が足りない"},
            ],
        },
        {
            "type": "predicate",
            "name": "wants_refund",
            "instructions": "顧客は返金を求めているか。",
        },
    ],
)

for answer in decision.answers:  # 質問と同じ順番で返る
    if answer.type == "refusal":
        print(f"回答拒否: {answer.name}")  # 人の確認に回す
    elif answer.type == "choice":
        print(answer.name, answer.choice, answer.confidence)
        for p in answer.probabilities:
            print("  ", p.value, p.probability)
    elif answer.type == "predicate":
        print(answer.name, answer.probability)

print(decision.usage.input_tokens) # 課金対象になるのはこの入力トークン選択肢には、どれにも当てはまらない入力の受け皿(ここではneeds_review)を必ず入れておきます。公式ガイドも、分類が入力をすべて覆わないときは"other"のような選択肢を用意し、一般の確認キューに回すよう勧めています。
前の答えによって次の質問が変わる場合(傷があるときだけ修理の種類を聞く、など)は、リクエストを分けます。
画像を判定する(predicate)
画像はuserメッセージの中にinput_imageとして入れます。公式ガイドの例と同じく、base64のdata URLで送るのが確実です(理由は後述の制限の節)。
import base64
from pathlib import Path

image_b64 = base64.b64encode(Path("product.png").read_bytes()).decode("ascii")

decision = client.decisions.create(
    model="gpt-6-luna",
    input=[
        {
            "role": "user",
            "content": [
                {"type": "input_text", "text": "この写真の商品を検品してください。"},
                {"type": "input_image", "image_url": f"data:image/png;base64,{image_b64}"},
            ],
        }
    ],
    questions=[
        {
            "type": "predicate",
            "name": "visible_damage",
            "instructions": "商品に割れ、破れ、へこみなど目に見える破損があるか。影や外箱の傷は無視する。",
        }
    ],
)
画像は大きさに応じて入力トークンが増えるので、後述のコスト計算は画像の分だけ高くなります。
深刻度を段階で評価する(score)
scoreでは、levelsを低いものから順に並べ、各段階の基準をdescriptionに書きます。
decision = client.decisions.create(
    model="gpt-6-luna",
    input="Safari ではエクスポートに失敗するが、Chrome では成功する。",
    questions=[
        {
            "type": "score",
            "name": "severity",
            "instructions": "この不具合はどの程度深刻か。",
            "levels": [
                {"label": "表示のみ", "description": "見た目だけで、機能は失われていない"},
                {"label": "回避策あり", "description": "作業は失敗するが、別の方法で完了できる"},
                {"label": "完全に停止", "description": "作業が失敗し、回避策がない"},
            ],
        }
    ],
)
Decisions APIのレスポンス:probability・choice・confidenceの読み方
レスポンスはmodel、answers、usageからなり、answersには質問と同じ順番で答えが入ります。公式ガイドのchoiceの例(値はガイドが「例示」としているもの)は次の形です。
{
  "answers": [
    {
      "type": "choice",
      "name": "department",
      "choice": "billing",
      "probabilities": [
        { "value": "billing", "probability": 0.95 },
        { "value": "technical", "probability": 0.02 },
        { "value": "shipping", "probability": 0.01 },
        { "value": "other", "probability": 0.02 }
      ],
      "confidence": 0.93
    }
  ]
}| 項目 | 返るタイプ | 意味と使い方 |
|---|---|---|
probability | predicate | 条件が真である確率の推定値(0〜1)。自分で決めたしきい値と比べて分岐する |
choice | choice | 指定したvalueのどれか1つ。値は型付きで、文字列の"true"と真偽値のtrueは別物として扱われる |
probabilities | choice、score | 選択肢・段階ごとの確率。scoreではvalue(段階番号)とlabelも入る |
confidence | choice、score | 確率分布とは別に返る信頼度の値。predicateには付かない |
score | score | 段階番号(0始まり)を確率で重み付けした平均。ガイドの例では確率0.1・0.7・0.2で1.1となり、段階の間の値もとる |
type: "refusal" | 全タイプ | モデルがその質問への回答を拒否した。nameは返り、同じリクエストの他の質問には答えが返る |
usage | — | input_tokensのほか、cached_tokens、cache_write_tokens、output_tokensなどの欄がある。課金されるのは入力のみ |
「信頼度スコア」は全タイプ共通ではない点に注意してください。predicateで読むのはprobability、choiceとscoreではprobabilitiesと別欄のconfidenceです。
確率としきい値:probabilityとconfidenceをそのまま信じない
返ってくる確率は、そのまま「当たる割合」として使える保証がありません。公開されているテストからは、次のような傾向が報告されています。
- クラスメソッドの計測では、ガイドの例で0.95・0.93とされているchoiceの例を5回呼ぶと、5回ともbillingの確率1.0、confidence 1.0でした。scoreの例(ガイドでは1.1・0.55)は5回とも0.97・0.96で、値は小数2桁、毎回同じでした。
- コミュニティのスレッドでは、表が70%の確率で出る偏ったコインを使ったテストで、predicateは約70%と実際の比率に近い値を返した一方、同じ問いをchoiceにすると約98%になり、選択肢の並び順でも確率が変わったという報告があります。
どちらも小規模なテストで、OpenAIの説明ではありません。それでも、確率を判断に使うなら次の手順を踏むのが安全です。
- 正解ラベル付きのサンプル(数十〜数百件)を用意し、実際の分布で
probabilityやconfidenceを記録する - 誤って通したときの損失と、誤って止めたときの損失を比べて、しきい値を決める(公式ガイドもこの決め方を勧めています)
- 「確率に意味を持たせたい」二択はchoiceではなくpredicateで聞く
- しきい値に届かない答えと
refusalは、needs_reviewと同じ確認キューに回す
メッセージの送信、課金、データ変更につながる判定では、しきい値に関係なく「動かない」選択肢を残しておくのがいちばん確実な歯止めです。
Decisions APIの制限:選択肢2〜255個・画像128枚・userロールのみ
APIリファレンスと公式ガイドに書かれている制限をまとめると次のとおりです。
| 制限 | 内容 |
|---|---|
| モデル | gpt-6-lunaのみ |
| choiceの選択肢数 | 2〜255個。値は重複不可、文字列か真偽値 |
| 画像 | 1リクエストのメッセージ全体で最大128枚。detailはlow・high・auto・original(既定はauto) |
| メッセージのロール | userのみ。system・developerロールは使えない |
| 使えない入力 | ファイル、音声、ツール(関数呼び出し)、アイテム参照、file ID |
| 画像の渡し方 | ガイドは「base64のdata URLのみ、HTTP(S)の画像URLは不可」、APIリファレンスは「base64か公開HTTP(S) URL」と食い違っている。両方で通るbase64を使う |
safety_identifier | 任意。エンドユーザー識別用の文字列で最大128文字 |
| 質問数・段階数の上限 | 公開されていない |
| レート制限 | Decisions専用の値は公開されていない |
レート制限については注意が必要です。OpenAIは2026年10月6日に利用ティアを改定し、現在は無料のFreeと、有料のBuild・Launch・Growの3段階です。以前の「Tier 1で毎分500リクエスト」という目安はもう当てはまりません。LunaのStandard処理の制限はBuildで毎分5,000リクエスト・200万トークン、Launchで10,000リクエスト・1,000万トークン、Growで30,000リクエスト・1億8,000万トークンですが、これが/v1/decisionsにも適用されるとはどこにも書かれていません。自分の上限はSettings > Organization > Limitsで確かめてください。
1,000回・100万回あたりのコスト:入力400トークンなら100万回$40
Decisions APIの費用は入力トークン数だけで決まります。
1回の費用 = 入力トークン数 × $0.10 ÷ 1,000,000
比較対象として、Responses APIでLunaを呼ぶ場合(GPT-6 LunaのStandard料金:100万トークンあたり入力$0.10、キャッシュ済み入力$0.01、キャッシュ書き込み$0.125、出力$0.50)は次の式です。
1回の費用 =(キャッシュされた入力 × $0.01 + キャッシュされない入力 × $0.10 + 出力 × $0.50)÷ 1,000,000
トークン数を仮定して計算すると次のようになります。出力は{"answer":"billing"}程度のJSONを想定し、reasoning.effortはnoneです。
| 条件(トークン数は仮定) | Decisions 1回 | Decisions 1,000回 | Decisions 100万回 | Responses(Luna)100万回 |
|---|---|---|---|---|
| 短い指示:入力400、出力15 | $0.00004 | $0.04 | $40 | $47.50 |
| 入力800、出力15 | $0.00008 | $0.08 | $80 | $87.50 |
| 長い固定指示:固定1,500+可変100、出力10 | $0.00016 | $0.16 | $160 | $30(キャッシュヒット時)/$165(キャッシュなし) |
1行目の内訳は、Decisionsが400×$0.10÷100万=$0.00004、Responsesが$0.00004+15×$0.50÷100万=$0.0000475です。短い指示ならDecisionsのほうが約16%(100万回で$7.50)安くなります。
3行目は逆転します。Responses APIのプロンプトキャッシュが効くと、固定の1,500トークンは$0.01で計算されるので、1,500×$0.01+100×$0.10+10×$0.50=100万回あたり$30です。Decisions APIは同じ1,600トークンすべてに$0.10がかかり$160で、約5.3倍の差になります。コミュニティのスレッドでも、このエンドポイントにキャッシュ割引がないことが指摘されています。
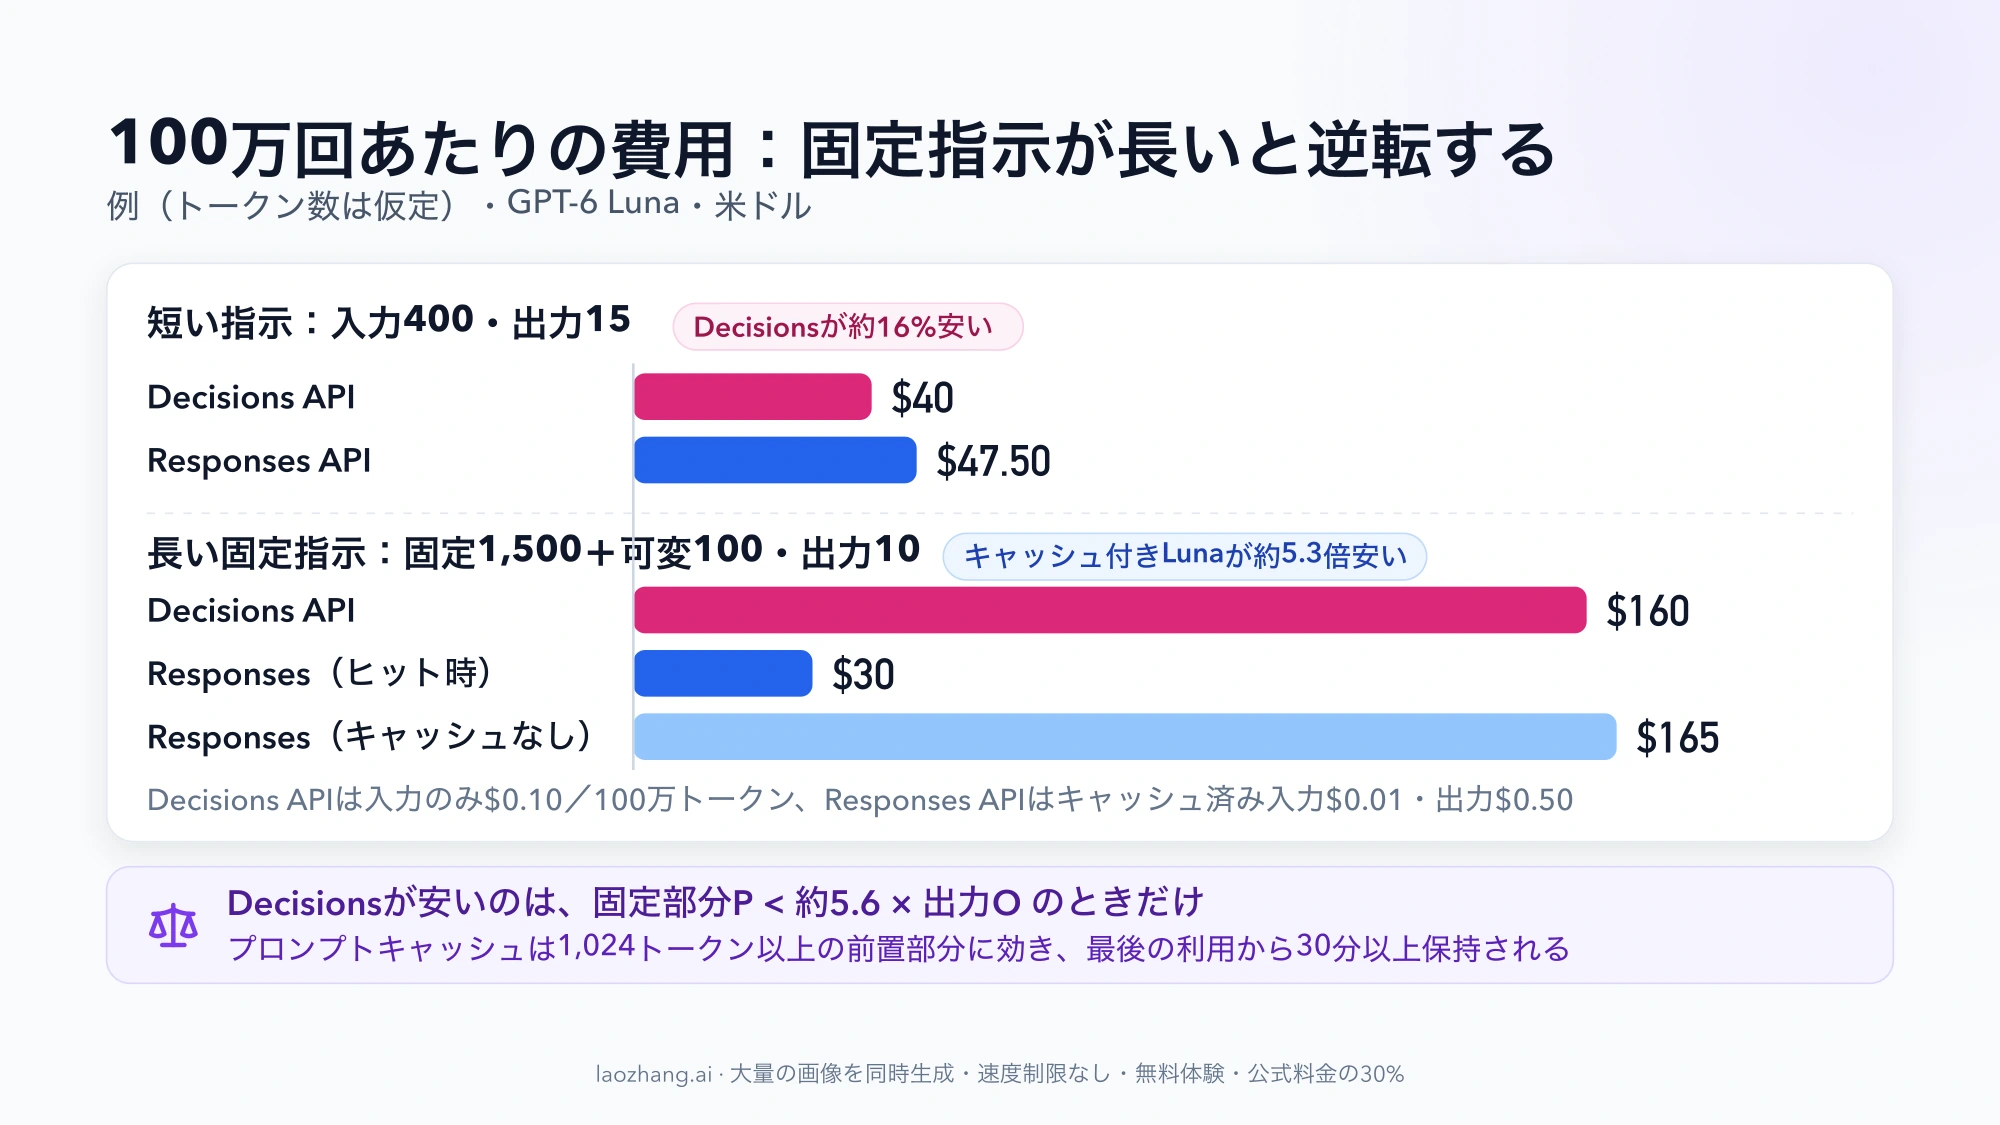
損益分岐を式にすると、固定部分をP、毎回変わる部分をV、出力をOトークンとして、Decisionsが安いのは0.10×(P+V) < 0.01×P+0.10×V+0.50×O のとき、つまり P < 約5.6×O のときだけです。出力15トークンならPが約83トークン未満です。プロンプトキャッシュは1,024トークン以上の前置部分にしか効かないため、キャッシュされるほど長い指示なら、キャッシュがヒットしている限りResponses APIのほうが安くなります。Decisions APIが費用面で有利なのは、指示が短い判定か、トラフィックがまばらでキャッシュ(最後の利用から30分以上は保持)がヒットしない判定です。
計算に影響する条件は次のとおりです。
- 画像を渡すと、どちらの経路でも入力トークンが増える
- Decisions APIにもリージョン処理の上乗せ(Lunaのモデルページでは10%)と、長いコンテキストの料金倍率(Lunaでは入力27万2,000トークン超で入力2倍)が適用される
- Responses APIで
reasoning.effortを上げると推論トークンの分だけ高くなる。eeselのテストでは、推論なしで1,000件あたり約$0.047、mediumで約$0.089だった - LunaのBatchは50%の料金で、1行目の条件なら100万回$23.75になる。Decisions APIにBatchがあるかどうかはドキュメントに記載がない
- 料金はベータ期間のもので、GA後の料金は発表されていない
トークン数は仮定なので、自分の指示文と典型的な入力で数え、上の式に入れ直してください。Decisions APIならusage.input_tokensがそのまま課金対象です。GPT-6 Solで判定する場合との料金差は、GPT-6 SolとLunaの料金比較:APIとCodexでどう違う?で同じトークン量の計算をしています。
Decisions APIとResponses APIのLuna、どちらを使うか
どちらも同じGPT-6 Lunaですが、得意な判定が違います。分かれ目は、速度、確率の値、指示の長さ、出力の形の4つです。
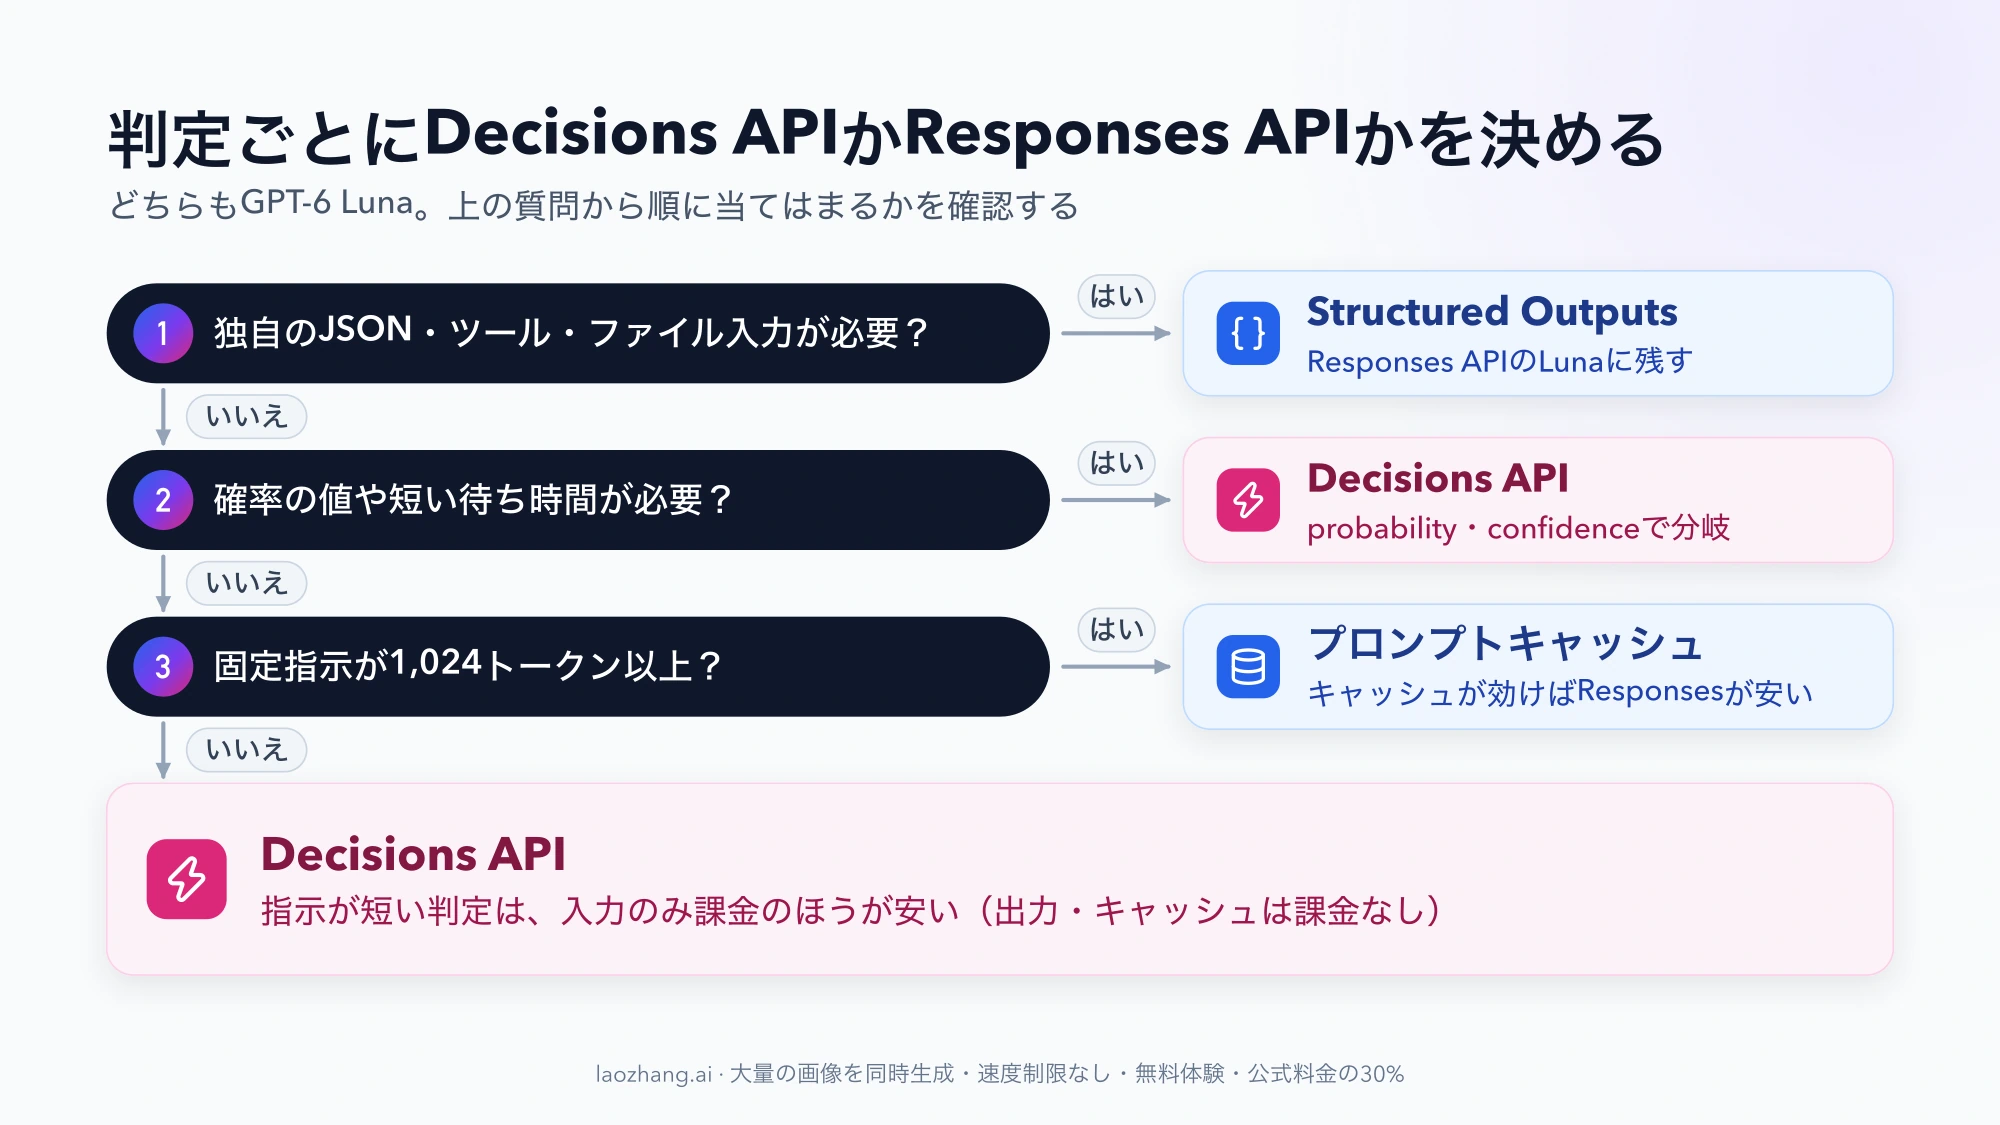
| 状況 | 向いている経路 |
|---|---|
| ライブチャットやエージェントの細かい判断で、待ち時間が体験を左右する | Decisions API |
| 「確率が0.8を超えたら自動処理」のように、確率やconfidenceで分岐したい | Decisions API(しきい値は自分のデータで決める) |
| 指示が短く(数百トークン)、件数が多い | Decisions API(入力のみ課金で安い) |
| 1,024トークン以上の固定指示を毎回送り、トラフィックが途切れない | Responses API+プロンプトキャッシュ |
| 抽出したフィールドや理由の説明など、独自のJSONを返したい | Responses API+Structured Outputs |
| モデルにツール呼び出しをさせたい、ファイルや音声を入力したい | Responses API(function calling) |
| 急がない一括ラベル付け | Responses APIのBatch(50%) |
公式ガイドも、独自のJSONスキーマに沿った出力が必要ならStructured Outputs、ツール呼び出しならfunction callingを使い、確率・選択・スコアの答えが必要なときにDecisions APIを使う、と分けています。
TypeSafe社のJevのような判定専用モデルとの比較もありますが、結論は報告によって分かれています(FAQで後述)。OpenAIの中で完結させたい、画像を判定したい、ZDRやデータ所在地の条件がある、という場合はDecisions APIが有力な選択肢です。
GPT-6 LunaとStructured Outputsで同じ判定を実装する
限定プレビューの間は、Decisions APIの代わりにLunaとStructured Outputsで同じ「選択肢から1つ選ぶ」処理を作るのが現実的な方法でした。公開ベータになった今でも、長い固定指示をキャッシュしたい場合、判定理由を一緒に返したい場合、Decisions APIを扱わないゲートウェイ経由で使う場合は、この実装がそのまま有効です。
GPT-6 Lunaは、テキストと画像の入力、Structured Outputs、Responses API・Chat Completions・Batchに対応しています。reasoning.effortはnoneからmaxまで選べます(既定はmedium)。判定だけならnoneから始め、精度が足りない質問だけ上げるのが順当です。
スキーマ:選択肢を列挙型(enum)に入れ「判断できない」を必ず含める
Structured Outputsのガイドに従い、strict: trueのJSON Schemaで答えのフィールドを列挙型にします。こうすると、モデルはリストにない値を返せなくなります。判定で関係する制約は次の点です。
- オブジェクトには必ず
additionalProperties: falseを付け、フィールドはrequiredにすべて入れる - スキーマ全体の列挙値は合計1,000個まで(250個を超える場合は文字数の制限も加わる)
厳格なスキーマが保証するのは「答えがリストの中の値であること」までで、答えが正しいことではありません。eeselのテスト(問い合わせ20件、計160回の呼び出し)では、振り分け先のキューは推論なしで40回中40回正しかった一方、「この問い合わせに自動返信してよいか」という判断は40回中33回でした。キューを間違えても数分の遅れで済みますが、誤った自動返信はそのまま顧客に届きます。
そのため、メッセージ送信、課金、データ変更につながる判定には、選択肢に「判断できない(unsure)」を加え、それが選ばれたら人の確認に回す経路を最初から作っておきます。Responses APIの経路には確率の値がないので、この選択肢が唯一の歯止めになります。
Pythonの実装例(Responses API)
下のコードは、公式ガイドに記載されたパラメータに沿って組んだ例です。本番に入れる前に、自分のデータで動作と精度を確かめてください。OPENAI_API_KEYは環境変数に設定されている前提です。
import json
from dataclasses import dataclass, field

from openai import OpenAI

client = OpenAI()  # 環境変数 OPENAI_API_KEY を使う
UNSURE = "unsure"


@dataclass
class Decision:
    answer: str                      # options のいずれか、または UNSURE
    detail: dict = field(default_factory=dict)


def decide(context, question: str, options: list[str],
           model: str = "gpt-6-luna", effort: str = "none") -> Decision:
    """context は文字列、または Responses API の content 配列(画像入り)"""
    schema = {
        "type": "object",
        "properties": {
            "answer": {"type": "string", "enum": options + [UNSURE]},
        },
        "required": ["answer"],
        "additionalProperties": False,
    }
    response = client.responses.create(
        model=model,
        reasoning={"effort": effort},
        input=[
            {
                "role": "system",
                "content": f"{question}\n選択肢から1つだけ選ぶ。"
                           f"判断材料が足りなければ {UNSURE} を選ぶ。",
            },
            {"role": "user", "content": context},
        ],
        text={
            "format": {
                "type": "json_schema",
                "name": "decision",
                "strict": True,
                "schema": schema,
            }
        },
        max_output_tokens=50,
    )

    if response.status == "incomplete":
        return Decision(UNSURE, {"reason": "incomplete"})

    message = next((o for o in response.output if o.type == "message"), None)
    part = message.content[0] if message and message.content else None
    if part is None or part.type == "refusal":
        return Decision(UNSURE, {"reason": "refusal"})

    data = json.loads(part.text)
    return Decision(data["answer"], {"usage": response.usage})


result = decide(
    "注文 #4471 の代金が二重に引き落とされています。",
    "この問い合わせを担当するキューはどれか。",
    ["billing", "shipping", "technical", "other"],
)
print(result.answer)  # options のいずれか、または unsure
if result.answer == UNSURE:
pass # 人の確認キューへ回す応答が途中で切れた場合(incomplete)と安全上の拒否(refusal)は、Structured Outputsのガイドが例外処理として挙げているケースです。どちらもunsureに寄せておくと、呼び出し側は「選択肢のどれか」か「人に回す」かの2通りだけを扱えば済みます。
Chat Completionsを使う場合は、text.formatの代わりにresponse_format: {"type": "json_schema", ...}で同じスキーマを渡します。
画像を含む入力
問い合わせにスクリーンショットが付いている場合は、contextに文字列ではなく、テキストと画像を並べた配列を渡します。
context = [
    {"type": "input_text", "text": "アプリが起動しません。画面を添付します。"},
    {"type": "input_image", "image_url": "https://example.com/screenshot.png"},
]
result = decide(context, "担当キューはどれか。",
                ["billing", "shipping", "technical", "other"])
Responses APIでは公開URLの画像を渡せますが、同じ入力をDecisions APIへ移すときはbase64のdata URLに変えておくと安全です。
ゲートウェイ経由で使う場合
Decisions APIを掲載しているゲートウェイもあります。Vercel AI Gatewayはモデルopenai/gpt-6-luna-decisions(入力100万トークンあたり$0.10)を載せており、OpenRouterにも「GPT-6 Luna Decisions」の掲載があります。ただし、ゲートウェイのリクエスト形式はOpenAIの/v1/decisionsと同じとは限らず(VercelはAI SDK経由)、上流の機能や制限がすべて使えるとも限りません。
OpenAI互換のゲートウェイでLunaを使う場合、たとえばlaozhang.aiのモデル一覧(2026年10月10日時点)にはgpt-6-luna(100万トークンあたり入力$0.1・出力$0.5)がありますが、Decisions用のモデルはありません。この場合は上のdecide()のようにResponses APIの形で判定を組みます。
Luna+enumからDecisions APIへの切り替え:移す判定と手順
既存のLuna+enumの判定をすべて移す必要はありません。上の選び方の表で「Decisions API」に当たる判定から、次の手順で移します。
- SDKを更新する。Python 3.26.0、JavaScript 7.30.0、Go 3.73.0、Ruby 0.101.0、Java 4.78.0以降で
client.decisions.createが使えます。 - enumをchoicesに書き換える。enumの各値を
valueにし、いつその選択肢を選ぶかをdescriptionに書きます。unsureはneeds_reviewのような受け皿の選択肢として残します。選択肢は255個までです。 - systemの指示を移す。Decisions APIはuserロールしか受け付けないので、systemメッセージに書いていた判定基準は各質問の
instructionsか、選択肢のdescriptionに移します。 - 質問をまとめる・分ける。同じ入力に対する独立した判定は1つの
questions配列にまとめ、前の答えに依存する判定は別のリクエストにします。 - 例外処理を置き換える。
incompleteやJSONの解析は不要になり、代わりにtype: "refusal"の答えを確認キューに回します。 - 同じサンプルで比べる。正解ラベル付きのサンプルを両方に流し、正解率、所要時間の中央値と遅い側の値、
usageから出した100万回あたりの費用を比べます。 - しきい値を決めてから切り替える。
probabilityやconfidenceの分布を見て、確認に回す境界を決めます。
decide(context, question, options)のように判定を1か所の関数に閉じ込めておけば、書き換えるのはその中身だけで済みます。速度は上がっても自分のデータで正解率が下がるなら、速度が必要な判定だけを移し、残りはResponses APIに置いておく選択もあります。
Decisions APIの料金・公開時期・Jevとの違い
OpenAI Decisions APIの料金はいくら?
gpt-6-lunaでの入力が100万トークンあたり$0.10で、課金されるのは入力トークンだけです。出力、キャッシュ読み取り、キャッシュ書き込みには料金がかかりません。入力400トークンなら1,000回$0.04、100万回$40です。キャッシュ割引はないため、長い固定指示を毎回送る判定ではResponses APIのLuna(キャッシュ済み入力$0.01)のほうが安くなることがあります。これはベータ期間の料金で、GA後の料金は発表されていません。
Decisions APIの一般公開はいつ?
2026年10月6日(米国時間)から公開ベータとして、通常のAPIキーで使えるようになりました。正式なGA(一般提供)は公式ガイドで「数週間以内」とされていますが、日付は発表されていません。ベータの間は、パラメータ名や料金が変わる可能性があります。
OpenAI Decisions APIのドキュメント(docs)はどこにある?
developers.openai.comのDecisionsガイドに、質問タイプ、各言語のコード例、料金、データ管理がまとまっています。パラメータの型と制限はAPIリファレンス、試し打ちはPlaygroundです。料金ページとLunaのモデルページにはDecisions APIの記載がまだありません。
GPT-6 Luna以外のモデルでも使える?
2026年10月10日時点で使えるのはgpt-6-lunaだけです。Responses APIでLunaを呼ぶのとは料金体系が別で、/v1/decisionsへの呼び出しにだけ入力のみ課金が適用されます。
Decisions APIとJevの違いは?
TypeSafe社のJevは、選択肢ごとの確率を返すテキスト専用の判定モデルです。Decisions APIは画像も扱え、OpenAIのZDRやデータ所在地の設定の中で使える点が違います。精度・速度・費用の比較は報告によって分かれています。クラスメソッドの計測では速度はほぼ同等(中央値255msと238ms)で、1回あたりの費用はDecisionsが$0.0000406、Jevが$0.0000169でした。コミュニティでは判断が難しい問いでJevのほうが正確だったという報告がある一方、文書の判定ではどのモデルもほぼ同じだったという報告もあります。自分のデータで比べてから選ぶのが確実です。
Decisions APIはChatGPTで使える?
使えません。Decisions APIはOpenAI APIの機能で、ChatGPTの画面から使うものではありません。使うにはOpenAI APIのアカウントとAPIキーが必要で、ChatGPTのPlusやProの契約とは別に、API側で料金がかかります。