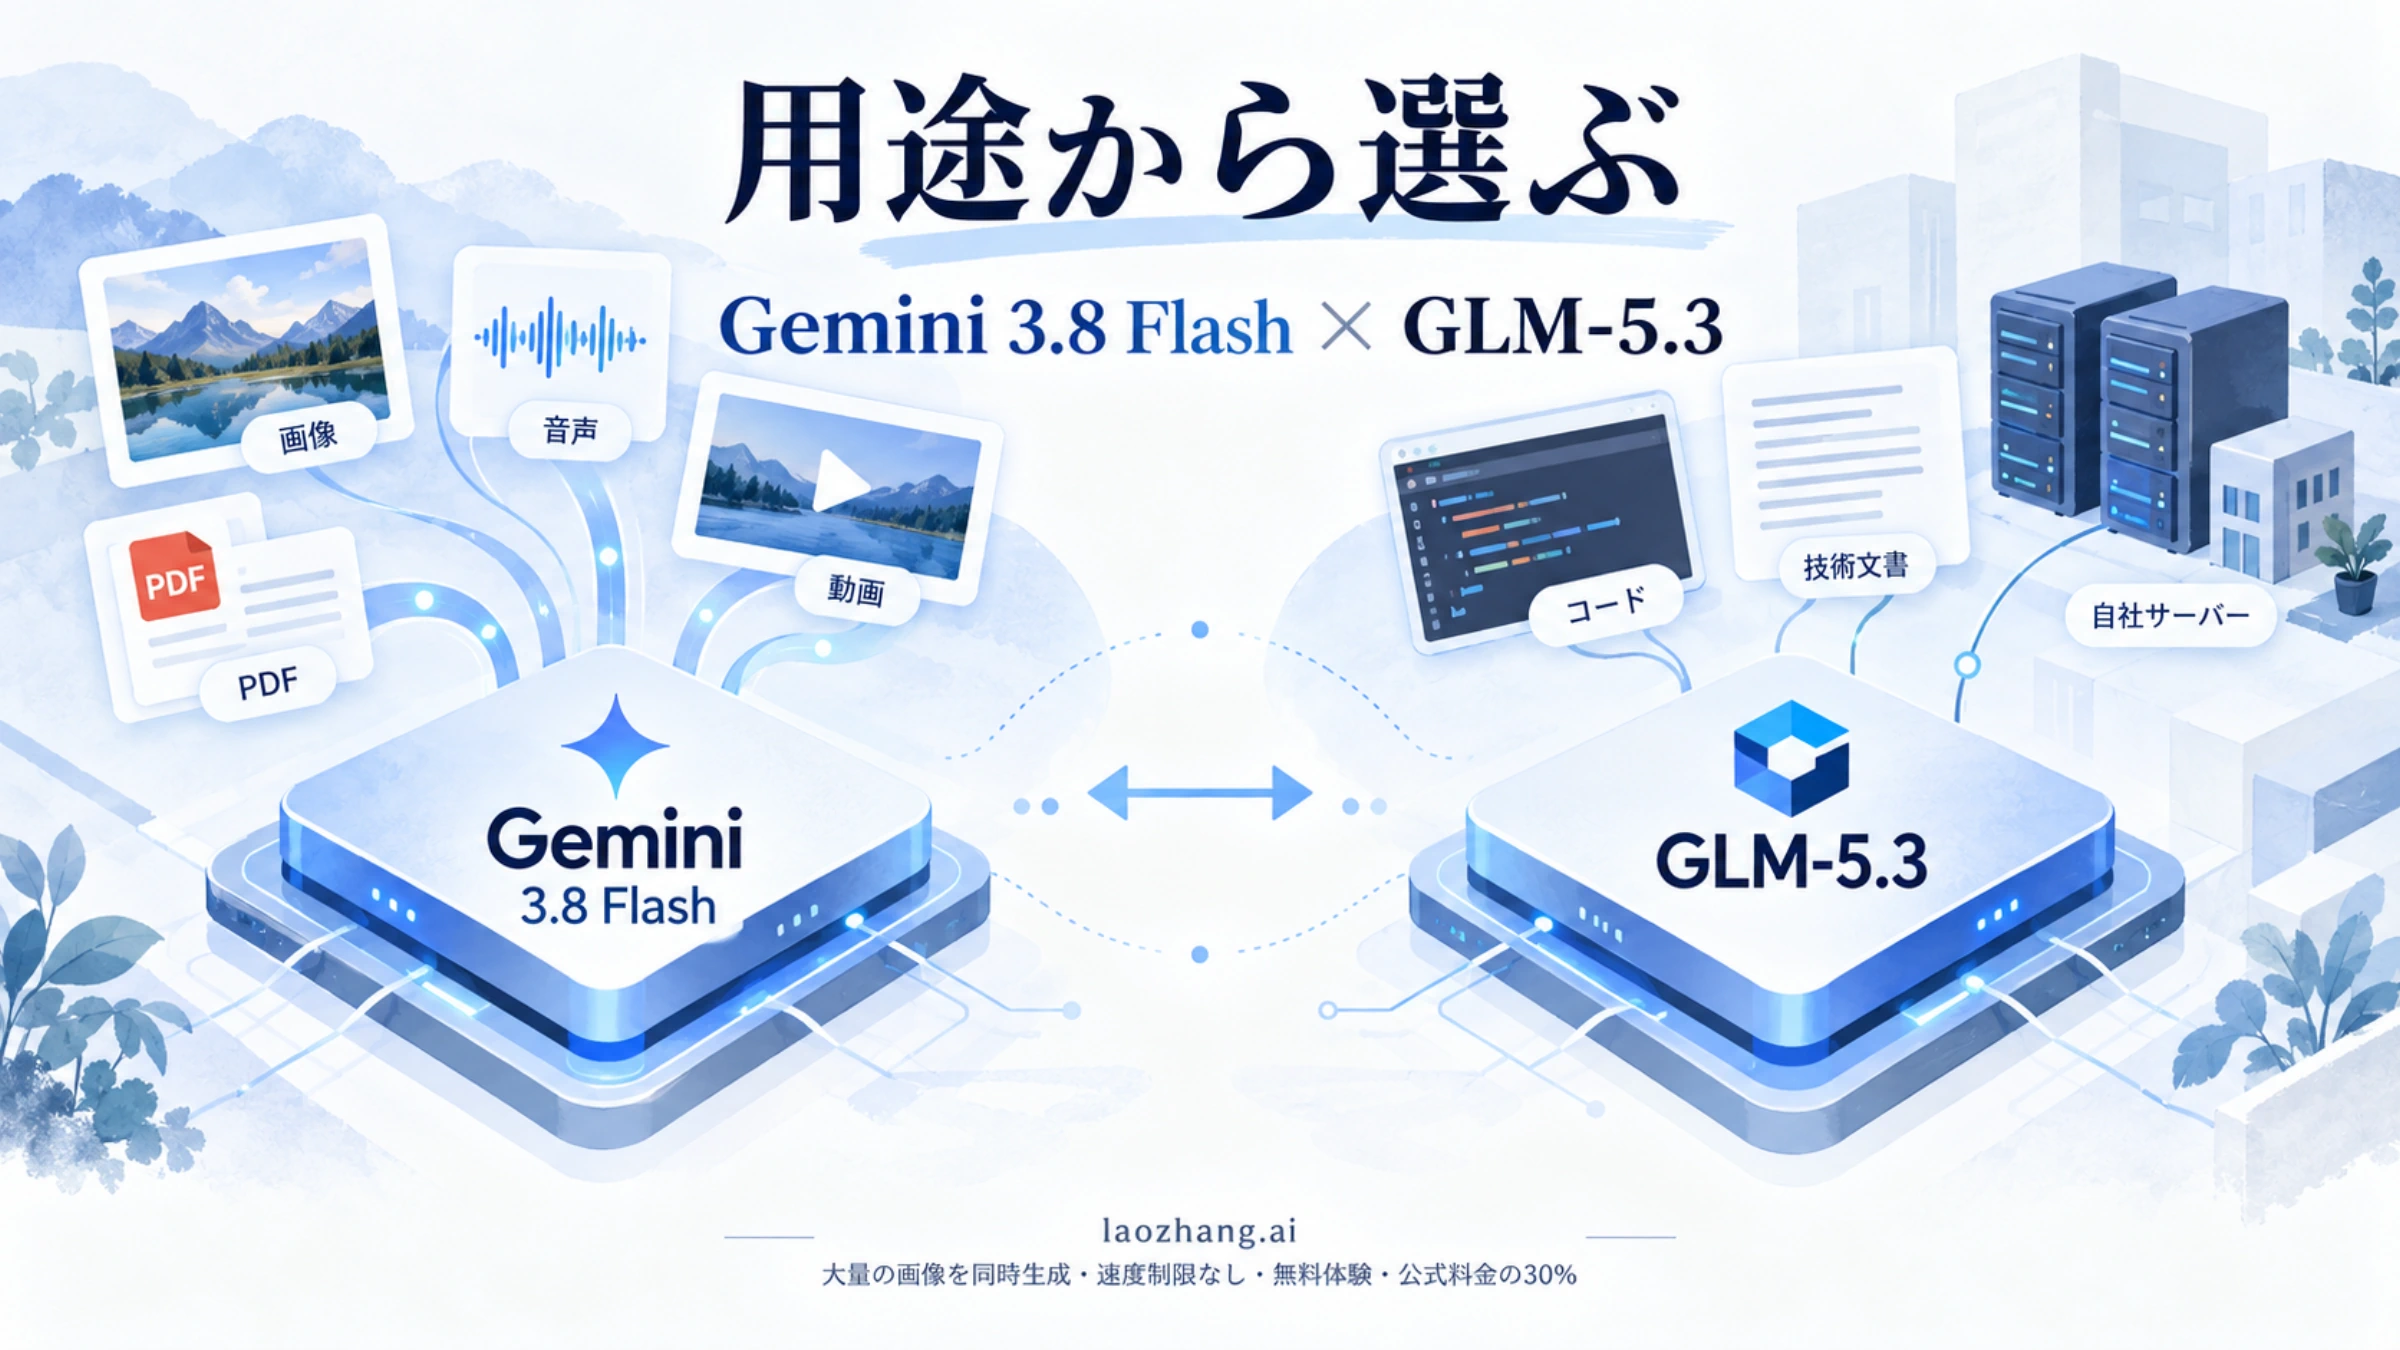
Gemini 3.8 FlashとGLM-5.3は、どちらも長い文脈を扱える推論モデルですが、選ぶ理由は異なります。画像・音声・動画・PDFをそのまま入力したいならGemini 3.8 Flashが候補になります。テキスト中心の開発作業に使い、将来的な自社環境での運用も検討するならGLM-5.3を評価する価値があります。 これはGoogleの入出力仕様とGLM-5.3の公式モデルカードから判断できる違いです。
従量課金の単価では、2026年10月28日時点のGoogle直契約のStandard APIは、Z.AI直契約のGLM-5.3より入力・出力とも安く設定されています。ただし、Geminiの現行料金は2026年12月31日までで、2027年1月1日からの値上げが公表されています。今の単価だけで長期予算を決めないことが大切です。Googleの料金表、Z.AIの料金表
比較するモデルIDは gemini-3.8-flash と glm-5.3 です。GLM-5.3-FlashやGemini 3.8 Flash Cyberは対象に含めません。本記事は公式仕様と外部測定の比較であり、当サイトが両APIを実行した実測記事ではありません。
入力形式と出力上限から、使えるモデルを絞る
最初に確認したいのは、処理したい資料をそのまま渡せるかどうかです。スキャン資料、会議音声、動画を扱う場合、Gemini 3.8 Flashはモデル自体がそれらの入力に対応します。GLM-5.3はテキスト入力なので、同じ仕事を任せるには文字起こしや画像からの情報抽出など、前段の処理を別に用意する必要があります。
| 比較項目 | Gemini 3.8 Flash | GLM-5.3 |
|---|---|---|
| 入力 | テキスト、画像、動画、音声、PDF | テキスト |
| 出力 | テキスト | テキスト |
| 長文の仕様 | 入力上限1,048,576トークン | コンテキスト長1Mトークン |
| 最大出力 | 65,536トークン | 128Kトークン |
| 関数呼び出し・構造化出力・キャッシュ | 対応 | 対応 |
| 推論の初期設定 | medium | max、推論の有効化が必須 |
出典:Gemini 3.8 Flashの仕様、Geminiの推論設定、GLM-5.3の仕様。いずれも2026年10月28日確認。GLMの1M・128Kは公式表記のまま記載しています。
この表の「入力上限」と「コンテキスト長」は、名称も意味も完全には一致しません。どちらも約100万トークンを扱えるという理由だけで、同じ長さの入力と出力を収められるとは判断できません。また、上限まで資料を投入できることと、その全内容を正確に参照できることは別です。長い仕様書を使うなら、必要な箇所を見つけられるか、回答の根拠が元資料と一致するかを確認してください。
GLM-5.3の最大出力は長いため、大きな成果物を一度に生成する用途では評価候補になります。ただし、長さの上限は完成度の保証ではありません。コードならテスト、文書なら必要項目の充足を基準に、分割生成した場合とも比べると判断しやすくなります。
API料金は、2026年末と2027年以降を分けて計算する
以下は公式直契約のドル建て料金です。GeminiはStandard、GLMはZ.AIのModel APIを対象とし、単位を100万トークンあたりの米ドルにそろえています。第三者サービスの円建て料金、Googleのサブスクリプション、GLM Coding Planの月額料金にはそのまま当てはまりません。
| 課金対象 | Gemini:2026年12月31日まで | Gemini:2027年1月1日からの公表料金 | GLM-5.3:2026年10月28日確認 |
|---|---|---|---|
| 通常の入力 | $0.75 | $1.50 | $1.40 |
| キャッシュにヒットした入力 | $0.075 | $0.15 | $0.26 |
| 出力 | $3.75 | $7.50 | $4.40 |
出典:GoogleのGemini API料金表、Z.AIのAPI料金表。Geminiの出力料金には思考トークンも含まれます。2027年のGLM価格は確定していないため、現在の料金と公表済みのGemini料金を分けて掲載しています。
同じ課金対象トークン数なら、1,000回でいくらになるか
1回あたり通常入力10,000トークン、課金対象の出力2,000トークンと仮定します。出力2,000には課金対象の思考分も含め、両モデルで請求される量が同じという条件です。計算は次のようになります。
1回の料金 = 入力トークン数 × 入力単価 ÷ 1,000,000
          + 課金対象の出力トークン数 × 出力単価 ÷ 1,000,000

Gemini(2026年末まで)= 10,000 × 0.75 ÷ 1,000,000
                       + 2,000 × 3.75 ÷ 1,000,000 = $0.015
GLM-5.3(現在)       = 10,000 × 1.40 ÷ 1,000,000
+ 2,000 × 4.40 ÷ 1,000,000 = $0.0228| 同条件での試算 | Gemini 3.8 Flash | GLM-5.3 |
|---|---|---|
| 現行単価で1,000回 | $15.00 | $22.80 |
| 2027年のGemini公表単価で1,000回 | $30.00 | $22.80と仮定した場合 |
後段はGLMの現行単価が続くと仮定したシナリオであり、2027年のGLM料金を予告するものではありません。いずれも上記公式単価からの計算で、キャッシュ、ツール、保存料、税、再試行、失敗した処理の費用は含めていません。
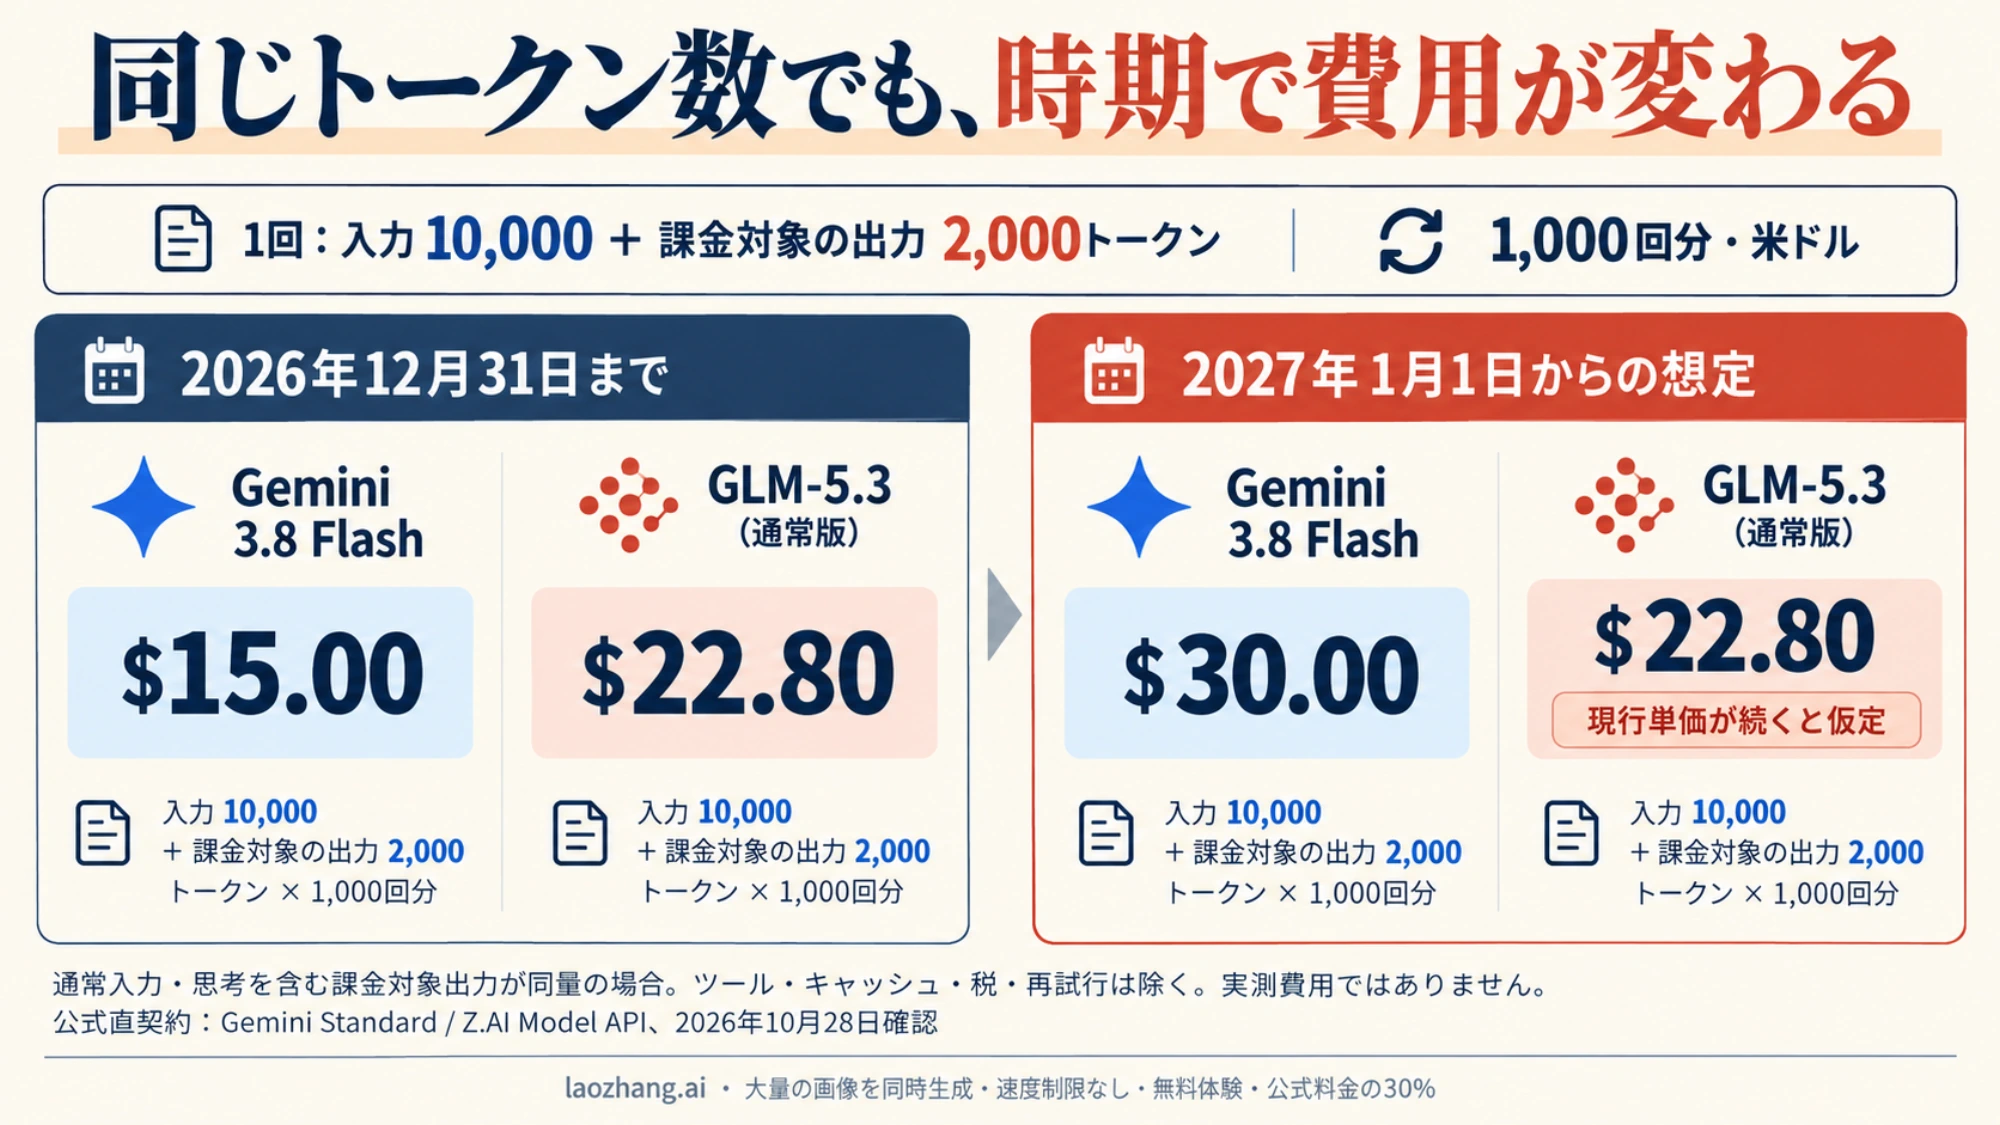
ここで比較できるのは「同じ量を請求された場合の単価差」です。同じ依頼をしても、推論の長さ、回答の長さ、やり直しの回数はそろいません。運用予算には、請求額を実際に完了したタスク数で割った金額を使いましょう。安い単価で何度もやり直す場合と、高い単価で一度で終わる場合を区別できます。
キャッシュと検索を使う場合は、追加費用を分ける
長い共通資料を繰り返し使うなら、キャッシュのヒット率も費用に影響します。GeminiのStandardではキャッシュ保存料が現在100万トークン・1時間あたり$0.50、2027年1月1日から$1.00と公表されています。Z.AIはキャッシュ保存を期間限定で無料としていますが、確認した料金表には終了日がありません。Googleの料金表、Z.AIの料金表
検索などのツールにも別料金があります。本文生成のトークン単価だけで検索付きの総費用を見積もらず、実際のツール呼び出し回数と各社の課金単位を加えてください。
外部ベンチマークではGLMが高得点でも、回答の速さは別に見る
Artificial Analysisの比較ページで2026年10月28日に確認した記録では、GLM-5.3は総合指標とTerminal-Benchで高い値を示し、Gemini 3.8 Flashは出力速度で高い値を示していました。ただし、対象はGeminiのHigh設定とGLMのMax設定です。同じ推論量での比較でも、両モデルの標準設定どうしの比較でもありません。
| 外部測定の項目 | Gemini 3.8 Flash(High) | GLM-5.3(Max) |
|---|---|---|
| Intelligence Index v4.3.2 | 41 | 45 |
| Terminal-Bench 4.0 | 20% | 42% |
| 出力速度 | 131トークン/秒 | 81トークン/秒 |
| 最初のトークンまでの時間(TTFT) | 25.27秒 | 2.74秒 |
| 最初の回答トークンまでの時間 | 25.27秒 | 27.47秒 |
出典:Artificial Analysisの対象モデル比較。同日のページ取得時点の値です。速度は継続的に更新されます。Indexは表に記されたv4.3.2の記録であり、現在の方法ページが説明するv5.0の最新順位ではありません。Indexの測定方法
GLMのTTFTは短いものの、最初に返るトークンが思考内容なら、利用者が欲しい回答をすぐに読めるとは限りません。この記録では、最初の回答までの時間は両モデルとも約25〜27秒でした。「出力が始まってから速い」「何かが返り始めるのが早い」「回答を読み始められるのが早い」を分けて考える必要があります。速度指標の定義
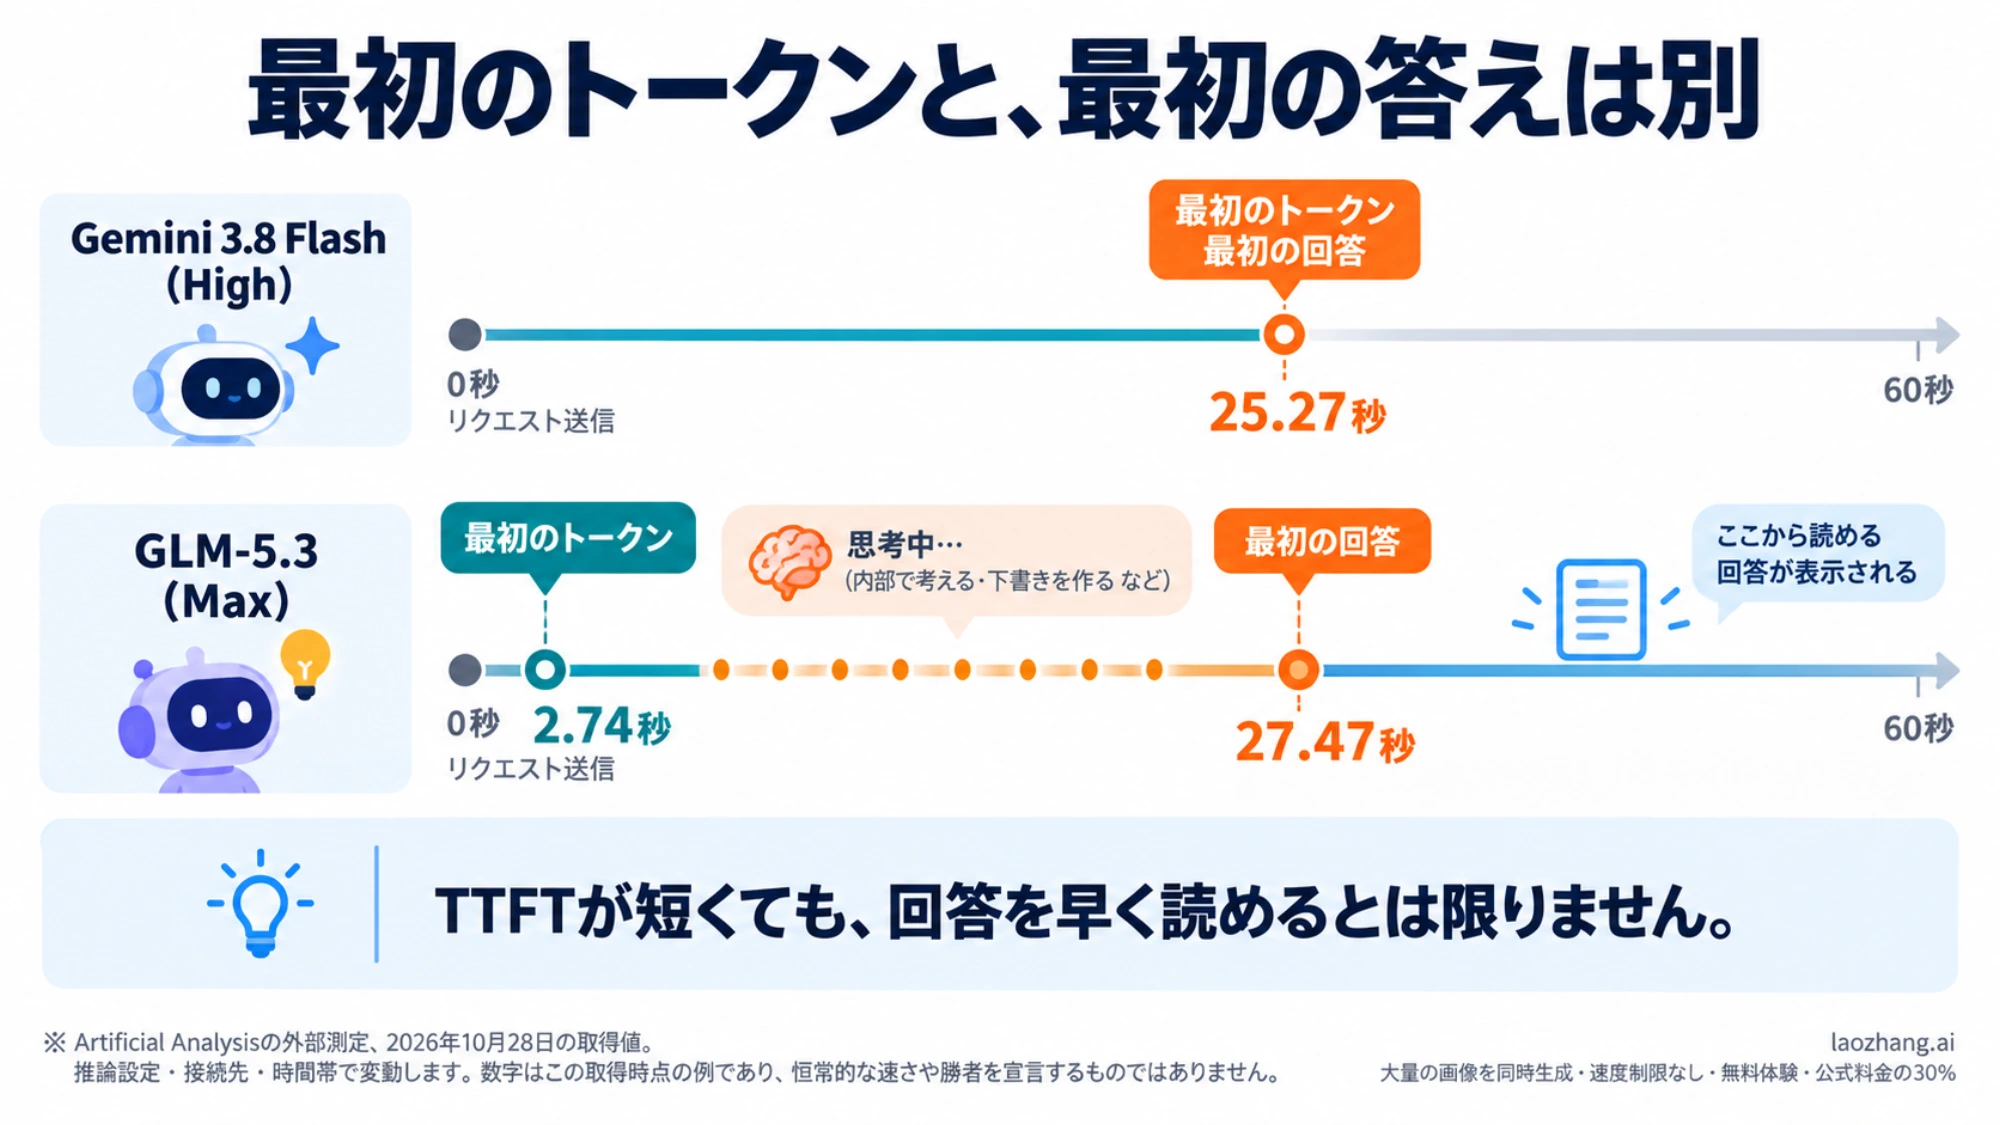
こうした測定はGLMをコーディング用途の評価候補に入れる根拠になります。一方、英語・テキスト中心の総合指標から、日本語の仕様書、社内用語、文章の自然さまで順位付けすることはできません。実際に使う課題で、受け入れ条件を満たすか確かめるのが次の手順です。
導入時は、推論設定と運用先を先に決める
両モデルを同じ指示で試す場合でも、初期設定の差は残ります。Gemini 3.8 Flashは low・medium・high に対応し、初期値は medium です。minimal は利用できません。GLM-5.3は thinking.type=enabled が必須で、reasoning_effort は low・high・max、初期値は max です。推論を無効にした従来設定を流用すると失敗します。Geminiの変更点、GLM-5.3のAPI仕様
まずは実運用で使う推論設定を決め、その設定を記録して費用と品質を比べてください。HighとMaxという名前が似ていても、同じ計算量を意味するわけではありません。
GeminiをAPIで導入する場合は、Gemini 3.8 Flash APIガイドでモデルID、初回の呼び出し、移行時の変更点を確認できます。GLMは利用中の契約と対応プロトコルを先に確認してください。公式文書ではCoding Planの利用歴があるアカウントにプロトコル上の条件があり、接続先の一覧とコード例にも異なるパスが記載されています。全アカウントに共通する接続先をここで断定せず、現在のGLM-5.3公式文書と契約条件に合わせて選ぶ必要があります。
GLM-5.3を自社環境で動かす場合
GLM-5.3は公式ウェイトが公開されており、API以外の運用方法を選べます。ただし、一般的な開発用PCで手軽に動かす規模ではありません。公式モデルカードが案内するvLLMの導入例には、FP8で8基のH200またはH20を使う構成が掲載されています。これは構成例であり、当サイトが検証した最低要件ではありません。長いコンテキストと同時実行数を増やす際は、重みの格納分に加えてKVキャッシュなどのメモリも見込む必要があります。
ライセンスはMITやApache 2.0ではなく、独自のGLM-5.3 Licenseです。商用利用も条項の対象となるため、再配布やサービス提供を予定する場合は原文を確認してください。「ウェイトが公開されている」だけで、あらゆる商用利用が無条件に認められるわけではありません。
自分の用途で選ぶための短い評価手順
選定では、一つの平均点よりも、実際の仕事を終えられるかを基準にします。画像や音声を直接扱う条件ならGeminiから、テキストの開発作業や自社運用が主目的ならGLMも含めて、次の順で確認すると無駄を減らせます。
- 実際の入力を用意する。 日本語の仕様書、問い合わせ、コードなど、運用で扱う資料から評価用の課題を選びます。外部APIに送れる情報だけを使ってください。
- 完了条件を先に決める。 コードはテストの通過、要約は必須項目と根拠の一致、構造化出力は形式と内容の両方で判定します。
- 条件と結果を一緒に記録する。 モデルID、推論設定、請求対象トークン、ツール回数、回答を読み始めるまでの時間、再試行を残します。
- 合格した処理の費用で選ぶ。 失敗ややり直しを含む総費用を完了件数で割り、必要な品質と待ち時間を満たす方を採用します。Geminiを継続利用する予算には、2027年の公表単価も当てはめます。
この手順は評価の提案であり、本記事で実施したテスト結果ではありません。アカウントごとの利用可否、並列処理の上限、稼働の安定性も、契約前後の確認項目として残ります。
よくある質問
Gemini 3.8 Flashは画像を生成できますか?
この比較で扱う gemini-3.8-flash の出力はテキストです。画像を読み込めることと、画像を生成できることは異なります。画像生成・音声生成・Live APIは対象モデルの対応機能に含まれていません。公式の対応機能一覧
GLM Coding Planの月額料金から、APIで使える量を計算できますか?
本記事のトークン単価で月額料金を割っても、Coding Planの利用可能量は求められません。ここで比較したのはZ.AI Model APIの従量料金です。Coding Planは別の契約条件で確認してください。Z.AIの料金区分
日本語ではどちらの回答が優れていますか?
本記事の根拠だけでは順位を付けられません。掲載した外部Indexは主にテキスト・英語での能力を測るもので、日本語品質の直接比較ではありません。敬語、専門用語、資料への忠実さなど、用途で必要な条件をそろえて評価してください。Artificial Analysisの測定範囲