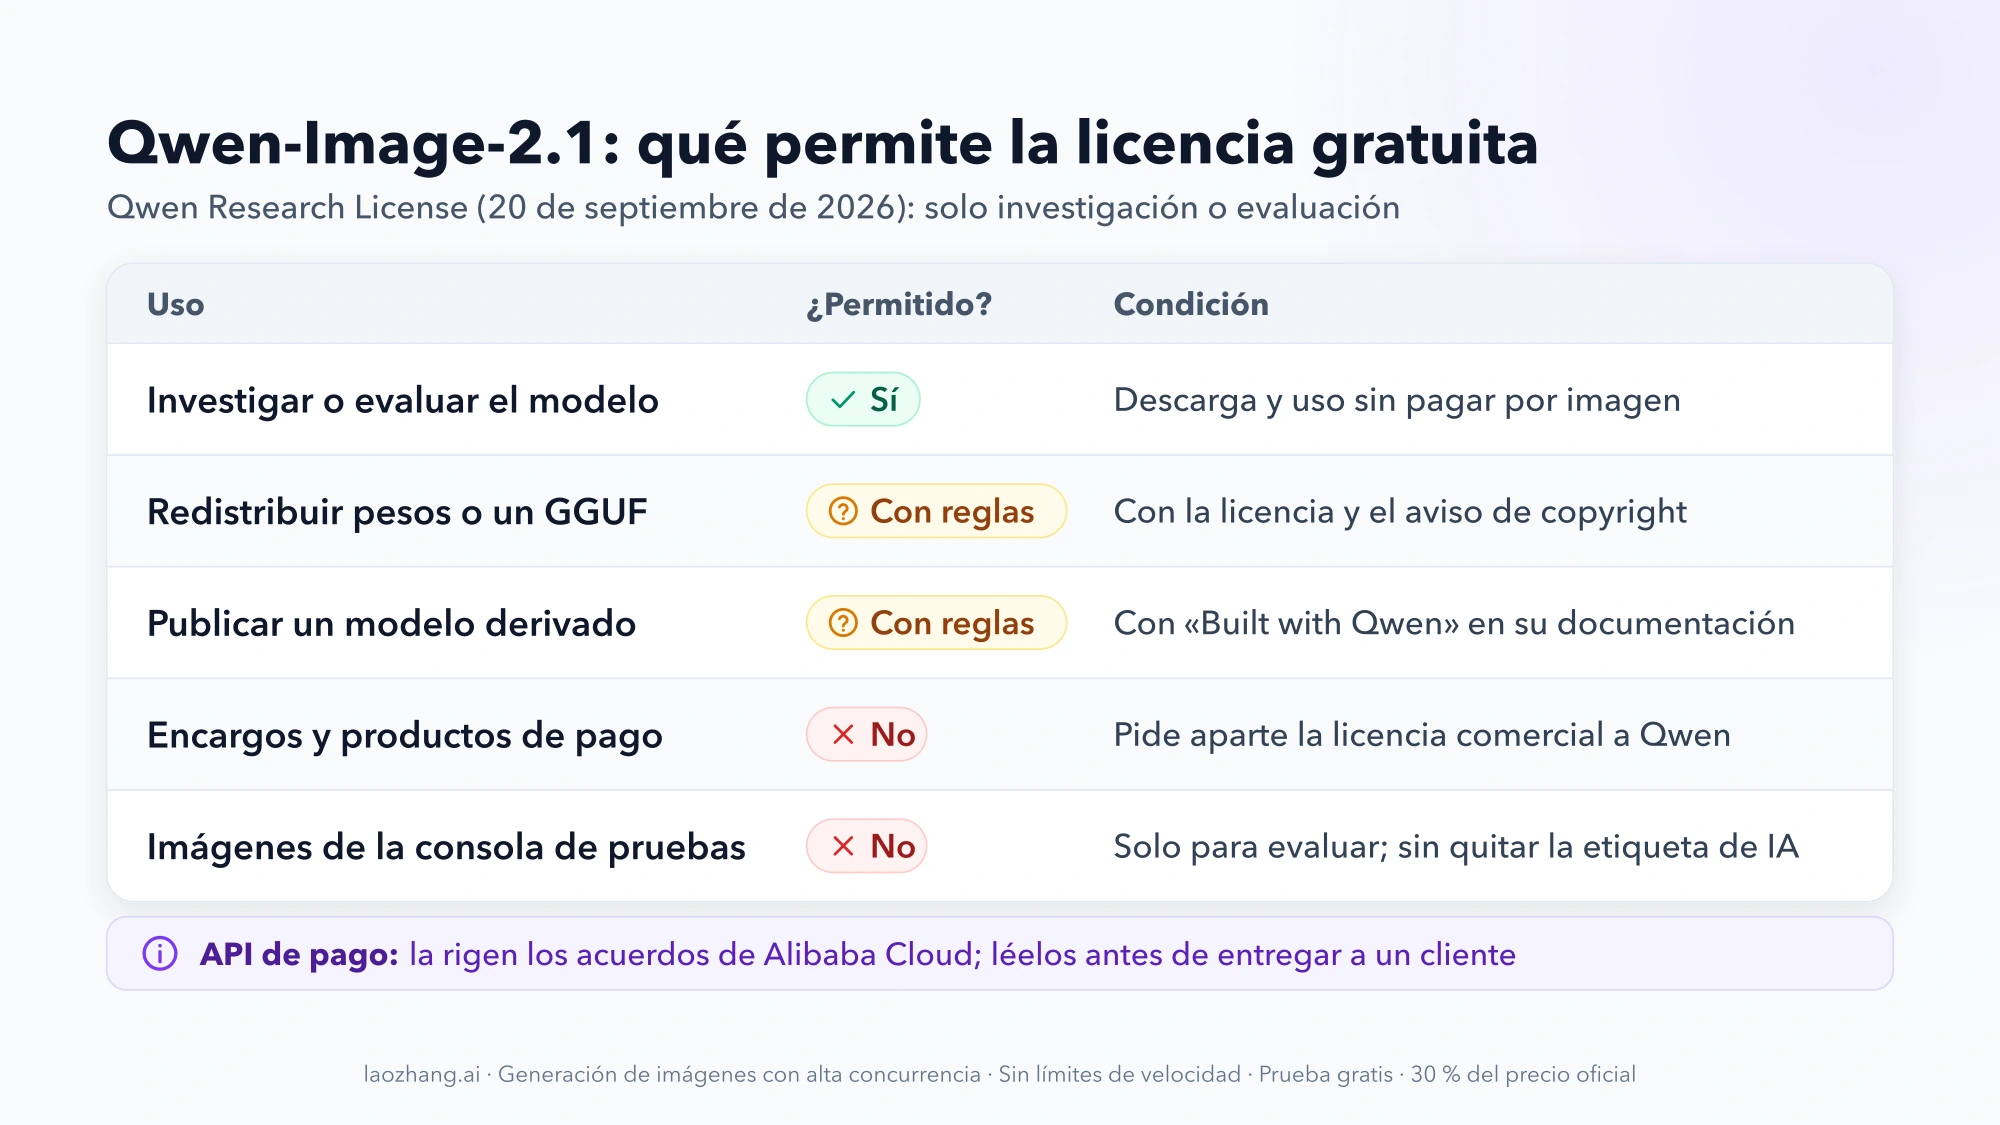
Sí y no. Qwen-Image-2.1 se descarga gratis: Qwen (Alibaba) publicó los pesos el 20 de septiembre de 2026 en GitHub y Hugging Face, y puedes ejecutarlo en tu equipo sin pagar por imagen. Pero no es código abierto en el sentido de «haz lo que quieras»: la licencia Qwen Research concede el uso solo con fines no comerciales, que define como «investigación o evaluación». Para trabajo comercial hay que pedir una licencia aparte.
Con eso claro, la elección depende de tres cosas: tu memoria de vídeo, cuántas imágenes vas a generar y si el resultado va a un cliente.
| Tu caso | Vía con la que empezar | Qué cambia la elección |
|---|---|---|
| Quieres ver qué hace, sin instalar nada | El Space oficial en Hugging Face (ZeroGPU) | La cuota gratuita no está publicada; si hay cola o se agota, pasa a local o a la API |
| Tienes una GPU NVIDIA de 12–16 GB o más, o un Mac con 12–16 GB o más de memoria unificada, y es para uso personal o pruebas | En local con ComfyUI (o Unsloth, Diffusers) | Con 6 GB arranca en FP8 descargando parte del modelo a la RAM, más despacio |
| No tienes GPU o necesitas integrarlo en una app | API de pago qwen-image-2.1-pro en Alibaba Cloud: 0,04 $ por imagen | 1.000 imágenes = 40 $; las fallidas no se cobran |
| Las imágenes son para un cliente o un producto | Licencia comercial de Qwen, o la API de pago tras leer las condiciones de Alibaba Cloud | La licencia gratuita de los pesos no cubre ese uso |
Los precios son de la página de tarifas de Model Studio a 7 de octubre de 2026; las cifras de memoria son estimaciones de Unsloth, no mínimos probados. Más abajo tienes el detalle de cada vía, los ajustes de la primera imagen, el PNG transparente y la edición con varias referencias.
Qué es Qwen-Image-2.1: un modelo de 7B que genera y edita
Qwen-Image-2.1 es un solo modelo para crear imágenes desde texto y para editarlas, así que en ComfyUI no tienes que cambiar de checkpoint entre una tarea y otra. Según el README oficial, el generador visual tiene 7.000 millones de parámetros (7B) repartidos en 32 capas DiT de flujo único, usa Qwen3-VL de 8B como codificador de texto e imágenes, y un VAE RGBA de 64 canales que trabaja con transparencia de forma nativa.
Lo que Qwen anuncia en la ficha de Hugging Face:
- Imágenes normales o transparentes (RGBA) desde texto, edición de capas transparentes y extracción de sujetos de una foto.
- Edición con hasta 10 imágenes de referencia, con zonas marcadas por círculos, trazos pintados o máscaras aparte.
- Conservación de la identidad de personas y productos, y mejoras en tipografía e iluminación de retratos.
- Resolución nativa de 2K: el tamaño por defecto en Diffusers es 2048 × 2048 con 40 pasos.
Son afirmaciones del fabricante. Como contraste independiente, Artificial Analysis lo situó a principios de octubre de 2026 en el puesto 18 de sus clasificaciones de generación (AA-Image-T2I v2.0) y de edición (AA-Image-Editing v2.0), y en el primero entre los modelos de pesos abiertos en ambas. Qwen Image 2.0 ocupaba los puestos 72 y 58. Esas tablas se mueven, así que tómalo como foto de ese momento.
¿Qwen-Image-2.1 es gratis? Descarga gratuita, licencia no comercial
La descarga y la ejecución en tu equipo no cuestan nada. Lo que limita es la licencia, y ahí hay un cambio respecto a la primera versión: el Qwen-Image original de agosto de 2025 salió con Apache 2.0, que sí permite uso comercial. La 2.1 no.
Lo que dice el texto de la Qwen Research License Agreement (fechada el 20 de septiembre de 2026):
- Puedes usar, copiar, modificar y redistribuir el modelo solo con fines no comerciales, definidos como «investigación o evaluación».
- Para cualquier uso comercial necesitas una licencia separada, que se solicita en
model-business@notice.qwencloud.com. - Si redistribuyes el modelo o un derivado, debes incluir la licencia y un aviso de copyright. Las cuantizaciones GGUF, FP8 o INT8 que circulan por Hugging Face son derivados de esos mismos materiales.
- Si entrenas o mejoras otro modelo con Qwen-Image-2.1 o con sus resultados y lo publicas, tienes que mostrar «Built with Qwen» o «Improved using Qwen».
- Se rige por la ley china y los tribunales de Hangzhou.
¿De quién son las imágenes que generas?
El 21 de septiembre, la cuenta oficial de Qwen en X respondió a esa pregunta: los resultados «no forman parte de los Materiales licenciados» y los usuarios conservan los derechos sobre las imágenes que generan (recogido por GIGAZINE). Es una respuesta en redes, no una cláusula de la licencia.
Y no resuelve la duda práctica. Que la imagen sea tuya no convierte en «investigación o evaluación» el hecho de ejecutar el modelo para un encargo pagado. Si haces carteles para un cliente, fotos de producto para una tienda o un servicio que cobra, la vía segura es pedir la licencia comercial o usar la API de pago después de leer sus condiciones. Esto es una lectura del texto, no asesoramiento legal.
La consola de pruebas de Alibaba tampoco sirve para trabajo comercial
Las condiciones de Model Studio dicen que lo que generes en las pruebas del modelo dentro de la consola solo puede usarse para evaluar su rendimiento, no para otros fines, «incluido cualquier fin comercial», y que no puedes quitar las etiquetas de «generado por IA» que añada ese servicio. Las llamadas de pago a la API no se rigen por esa página, sino por los acuerdos generales de Alibaba Cloud: léelos antes de entregar nada a un cliente, porque la página de precios no dice nada sobre derechos de uso.
Qwen-Image 2.0, 2.1 y 3.0: de las tres, solo 2.1 tiene pesos descargables
La numeración confunde, porque 2.1 salió después de 3.0. Según GIGAZINE y Unite.AI:
| Versión | Fecha | ¿Pesos descargables? | Licencia o acceso |
|---|---|---|---|
| Qwen-Image (original) | agosto de 2025 | Sí | Apache 2.0 |
| Qwen-Image-2.0 | febrero de 2026 | No | Solo API |
| Qwen-Image-3.0 | 21 de julio de 2026 | No | Solo API |
| Qwen-Image-2.1 | 20 de septiembre de 2026 | Sí | Licencia de investigación (no comercial) |
Qwen Image 2.0 nunca tuvo pesos públicos, así que no existe una versión 2.0 gratuita para descargar: la que puedes ejecutar en tu equipo es 2.1. Frente a 3.0, no hay comparación oficial que diga cuál es mejor: Alibaba lanzó 3.0 sin benchmarks publicados. Lo que sí puedes comparar es el precio por API, que está más abajo.
Las tres vías para usar Qwen-Image-2.1 y cuál te conviene
Probarlo gratis online, sin instalar nada
- Space oficial en Hugging Face: Qwen/Qwen-Image-2.1 funcionaba sobre ZeroGPU a 7 de octubre de 2026. Hugging Face no publica cuántas imágenes permite, y la cola varía.
- ModelScope: según el README, permite descargar el modelo, generar online y entrenar LoRA.
- wuli.art: el README lo ofrece gratis con todas las funciones, pero para usuarios de China continental.
- Kie.ai: da créditos gratuitos a cuentas nuevas en su playground. Es un proveedor externo; su página muestra una etiqueta «Commercial use», pero no dice si Kie tiene una licencia comercial de Alibaba para unos pesos con licencia de investigación.
Si solo buscas un generador gratuito en el navegador y no te importa el modelo, tienes otras opciones en ¿Cuál es el mejor generador de imágenes con IA gratis en 2026?.
Ejecutarlo en local
Es la vía que mejor aprovecha que los pesos sean abiertos: sin cuota, sin cola y con control total de semillas, pasos y resolución. Hay soporte desde el primer día en ComfyUI, Diffusers, vLLM-Omni, SGLang y LightX2V, y el README menciona también GPU AMD con ROCm. Los requisitos de memoria están en la sección siguiente.
Pagar por imagen con la API
Alibaba vende el modelo alojado como qwen-image-2.1-pro. Tiene sentido si no tienes GPU, si lo integras en una app o si necesitas varias imágenes en paralelo. «Pro» es el nombre del producto alojado: Alibaba no dice si es idéntico a los pesos abiertos, y la API añade un parámetro prompt_extend que reescribe tu prompt. Precios y límites, en la sección de la API.
Cuánta VRAM necesita Qwen-Image-2.1: de 6 GB con descarga a RAM a 24 GB
Unsloth, que publica versiones cuantizadas GGUF y FP8, da estas configuraciones de partida en su guía para ejecutarlo en local. Ellos mismos las llaman estimaciones, no mínimos probados: la memoria real cambia con la resolución y con la descarga a RAM (offloading).
| Tu equipo | Configuración de partida |
|---|---|
| 6 GB de VRAM | FP8 descargando parte del modelo a la RAM; menos de dos veces más lento |
| 12–16 GB de VRAM | GGUF Q4_K_M a 1024 × 1024, lote de 1 |
| 24 GB de VRAM | INT8/FP8 a 512 × 512, o GGUF Q4_K_M a 1024 × 1024 |
| Solo CPU con 12–16 GB de RAM | GGUF Q4_K_M con el codificador de texto Q4_K_XL |
| Mac con Apple Silicon y 12–16 GB o más de memoria unificada | GGUF con un backend nativo compatible |
En la introducción de la misma página, Unsloth habla de unos 11 GB de VRAM con GGUF y 24 GB con INT8/FP8. Su consejo es generar una imagen a la resolución de la tabla y subir solo si sobra memoria. Recomienda FP8 a partir de 24 GB, y GGUF si dependes de la RAM del sistema o usas un Mac.
Dos detalles que ayudan a elegir archivo:
- INT8 frente a FP8: el archivo INT8 pesa 7,26 GB y el FP8, 7,12 GB, pero el INT8 se desvía menos del modelo completo (LPIPS medio de 0,064 frente a 0,112, menos es mejor). Por eso Unsloth usa INT8 por defecto.
- El codificador también ocupa: además del generador de 7B, necesitas Qwen3-VL de 8B. Si activas el reescritor de prompts opcional, se suma otro modelo de 9B.
Como referencia fuera de NVIDIA, GIGAZINE lo probó con una Intel Arc Pro B70 de 32 GB y un Ryzen 5 7600X en ComfyUI: a 1024 × 1024 y 25 pasos tardó unos 45 segundos la primera imagen y unos 30 las siguientes. Es una sola máquina y una sola prueba.
Si ya calculaste memoria con Unsloth para un modelo de texto, el razonamiento es el mismo que en Cómo ejecutar Qwen3.8-Flash-Next en local con Unsloth sin quedarse corto de memoria: cuantización, resolución o contexto, y cuánto puedes descargar a la RAM.
Primera imagen en ComfyUI: archivos, plantilla y ajustes
La documentación de ComfyUI trae tres plantillas oficiales: texto a imagen, edición de imagen y quitar fondo. Para la primera imagen:
- Actualiza ComfyUI. Si la biblioteca de plantillas no muestra ninguna plantilla «Qwen-Image-2.1», o faltan nodos al cargar el flujo, tu versión es anterior al soporte. Los nodos nuevos pueden llegar antes a la versión Nightly que a la estable.
- Abre la plantilla de texto a imagen. Al cargarla, ComfyUI avisa de que faltan modelos; en la prueba de GIGAZINE bastó con abrir los detalles, pulsar «Download All» y reiniciar o refrescar.
- Comprueba que los archivos quedan en su carpeta:
Carpeta de ComfyUI/models/ | Archivo que carga la plantilla | Alternativa a precisión completa (más memoria) |
|---|---|---|
diffusion_models/ | qwen_image_2.1_int8_convrot.safetensors | qwen_image_2.1_bf16.safetensors |
text_encoders/ | qwen3vl_8b_int8_convrot.safetensors | qwen3vl_8b_bf16.safetensors |
vae/ | qwen_image_2.1_vae_bf16.safetensors | — |
- Escribe el prompt y deja los ajustes de la plantilla: 25 pasos, cfg 1, sampler
euler, schedulersimple. Para un cuadrado de 2048 × 2048, pon el objetivo del nodo Resolution Selector en unos 4,0 MP (1,0 MP equivale a 1024 × 1024). - Ejecuta. Has acertado si sale una imagen coherente con el prompt al tamaño pedido. Si se queda sin memoria, baja a 1,0 MP antes de tocar nada más.
Antes de cambiar ajustes, conviene saber cómo responden:
- Con cfg 1, el prompt negativo no hace nada: ComfyUI se salta ese paso. Es el valor para el que está publicado el modelo.
- cfg 2 sigue mejor los prompts densos, con texto pequeño y números, a cambio de bordes demasiado afilados. cfg 5 degrada mucho la calidad y cfg 0,5 rompe la imagen. Cambia un valor cada vez y compara con la misma semilla.
- Pasos: el pipeline publicado usa unos 40–50. Manos y dedos se asientan hacia los 30, y pasar de 25 a 40 reduce el ruido en zonas con detalle.
- Mejora de prompt (
refine_prompt): viene desactivada. Al activarla, un modelo de 9B reescribe tu petición antes de generar; un nodo de vista previa te muestra el texto final para que decidas si te sirve.
Qwen-Image-2.1 con Diffusers en Python
Si prefieres código, el README usa la clase QwenImage21Pipeline, que cubre generación y edición. Instalación:
pip install "torch>=2.4.0" "transformers>=5.17" accelerate pillow
pip install git+https://github.com/huggingface/diffusers
Este ejemplo combina dos fragmentos del README: la descarga de partes del modelo a la RAM para GPU con poca memoria y el formato de prompt para transparencia. Necesita una GPU NVIDIA con CUDA; la primera ejecución descarga los pesos de Hugging Face.
import torch
from diffusers import QwenImage21Pipeline

pipe = QwenImage21Pipeline.from_pretrained(
    "Qwen/Qwen-Image-2.1", torch_dtype=torch.bfloat16
)
pipe.enable_model_cpu_offload()  # en lugar de .to("cuda") si te falta VRAM

image = pipe(
    prompt=(
        "This is an RGBA image with transparency. "
        "A ceramic coffee mug with a hand-painted lemon. "
        "The image has alpha channel and the background is transparent."
    ),
    width=1024,
    height=1024,
    num_inference_steps=40,
    generator=torch.Generator("cuda").manual_seed(42),
).images[0]

image.save("taza.png")
Sin width y height, el pipeline genera a 2048 × 2048. Para servirlo como API propia, el README documenta vllm serve Qwen/Qwen-Image-2.1 --omni, que expone un endpoint /v1/images/generations al estilo de OpenAI.
PNG transparente: el prompt RGBA que recomienda Qwen
Qwen-Image-2.1 genera la transparencia directamente, sin recortar después. El README recomienda este formato, con tu descripción en el centro:
This is an RGBA image with transparency. <tu descripción>. The image has alpha channel and the background is transparent.GIGAZINE obtuvo un fondo totalmente transparente en ComfyUI escribiendo simplemente «PNG transparente» en el prompt, pero fue una sola prueba; el formato oficial es el camino fiable.
Para comprobar que funcionó, abre el archivo en un editor que muestre el canal alfa (GIMP, Photoshop, Krita). Las vistas previas web, la galería del móvil o una app de mensajería pueden aplanar el fondo y hacer creer que la transparencia falló.
Si lo que quieres es recortar una foto existente, la plantilla «Remove Background» de ComfyUI usa el flujo de edición con la instrucción Remove the background, and output a PNG image.
Editar con varias imágenes: 10 referencias, aunque el nodo muestre 16
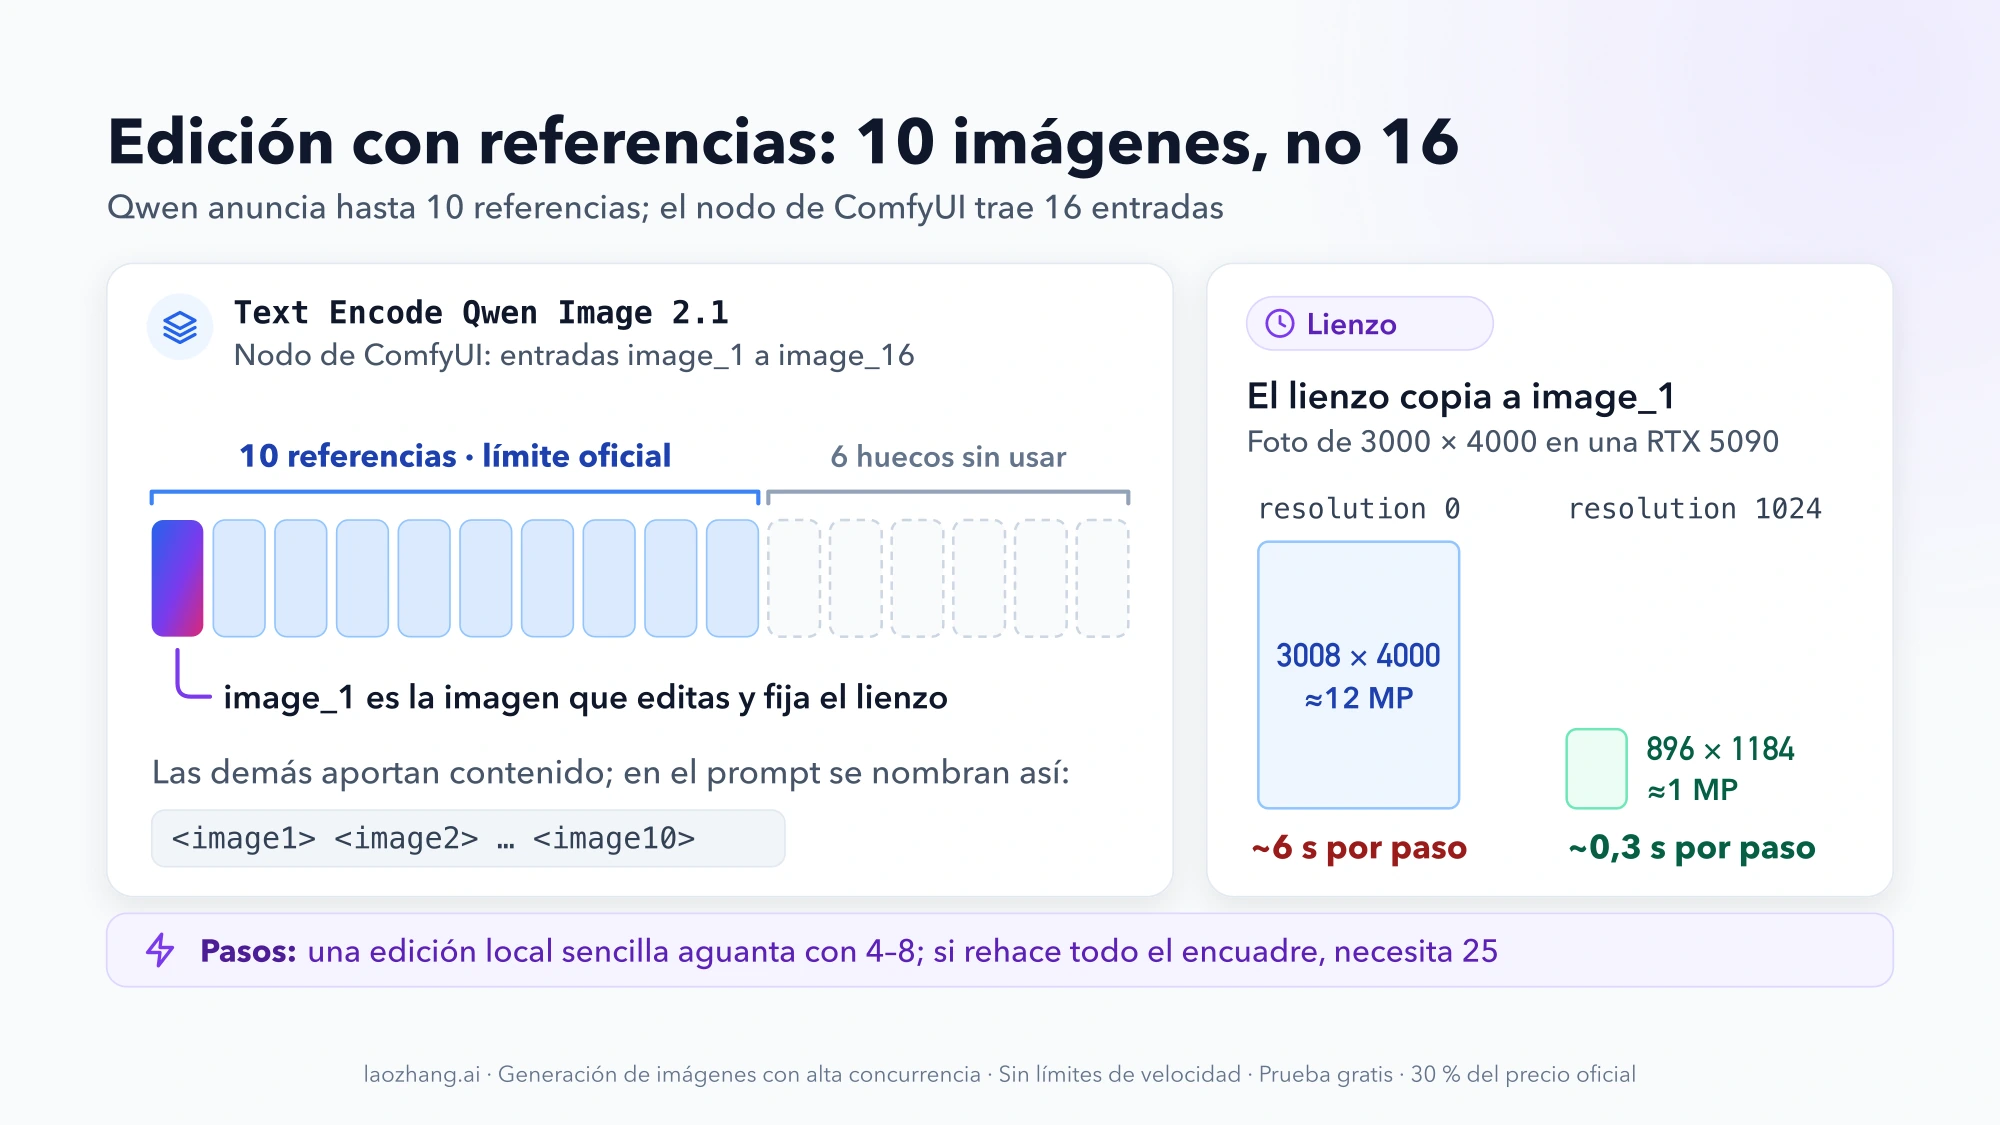
El límite oficial es 10 imágenes de referencia. El nodo Text Encode Qwen Image 2.1 de ComfyUI tiene 16 huecos (image_1 a image_16), pero las plantillas de edición solo conectan 10, y Qwen no anuncia más de 10. Trata los 16 como huecos del nodo, no como una capacidad del modelo.
Cómo funciona la edición:
image_1es la imagen que se edita; las demás aportan contenido. En el prompt las nombras por su número:<image1>,<image2>…- Ejemplo de la documentación de ComfyUI: «Keep the character and pose in
<image1>unchanged, put this light blue denim shirt from<image2>on the character, preserve the original facial features, hair, body shape and pose». - Para tocar solo una zona, abre el Mask Editor del nodo LoadImage de
image_1, pinta encima con el Paint Pen y nombra el color en el prompt: «cambia la chaqueta de la zona roja». Mantén la marca dentro de la zona que quieres cambiar. - Ediciones sencillas y localizadas (cambiar el color de una prenda) aguantan con 4–8 pasos, varias veces más rápido; las que rehacen todo el encuadre necesitan los 25.
Lo que más frena una edición es el tamaño del lienzo. La plantilla viene con resolution a 0, así que el lienzo toma el tamaño de image_1. Una foto de 3000 × 4000 se convierte en un lienzo de 3008 × 4000 (unos 12 MP), y en una RTX 5090 eso va a unos 6 s por paso, frente a unos 0,3 s por paso a resolution 1024 (unos 896 × 1184). Si una edición es lenta, revisa primero ese valor y el tamaño de las referencias.
Con varias referencias, cuenta con repetir. En la prueba de GIGAZINE, una escena que combinaba dos imágenes salió como se pedía, pero con fallos (brazos de más, texto que no seguía la curva de una pantalla) y después de muchos intentos.
Precio de la API de Qwen-Image-2.1: 40 $ por 1.000 imágenes
Precios por imagen generada con éxito, de la página de tarifas de Alibaba Cloud Model Studio (actualizada el 6 de octubre de 2026) y de Kie.ai, a 7 de octubre de 2026:
| Modelo y región | Precio por imagen | 1.000 imágenes |
|---|---|---|
qwen-image-2.1-pro, Singapur (internacional) | 0,04 $ | 1.000 × 0,04 $ = 40 $ |
qwen-image-2.1-pro, Pekín, Hong Kong, Fráncfort, Virginia o Tokio | 0,035333 $ | ≈ 35,33 $ |
| Qwen-Image-2.1 en Kie.ai, 1K | ≈ 0,02 $ (4 créditos) | ≈ 20 $ |
| Qwen-Image-2.1 en Kie.ai, 2K | ≈ 0,04 $ (8 créditos) | ≈ 40 $ |
qwen-image-3.0 (cerrado), Singapur | 0,03 $ | 30 $ |
qwen-image-2.0 / qwen-image-2.0-pro, Singapur | 0,035 $ / 0,075 $ | 35 $ / 75 $ |
Lo que conviene saber antes de hacer cuentas:
- Las generaciones fallidas no se cobran ni consumen la cuota gratuita.
- 10 imágenes gratis con
qwen-image-2.1-pro, solo en Singapur, válidas 90 días desde la activación de Model Studio, la publicación del modelo o la aprobación de la solicitud (lo que ocurra más tarde). - Límites: 20 peticiones por minuto, 10 en paralelo y una cola asíncrona de 200 tareas, según la página del modelo en QwenCloud.
- El cálculo no incluye impuestos ni las repeticiones que hagas por calidad. Para
qwen-image-3.0, las imágenes de entrada en edición se cobran aparte (0,003 $ cada una); paraqwen-image-2.1-prono figura precio de entrada. - Kie es un intermediario: la etiqueta «Commercial use» de su página es suya, y no aclara si tiene licencia comercial de Alibaba para este modelo.
En local no pagas por imagen, pero el coste lo pone tu hardware. Si ya tienes una GPU con memoria suficiente y el uso es personal, la API solo te ahorra la instalación y te deja lanzar 10 peticiones en paralelo; si no tienes GPU, 100 imágenes cuestan 4 $ en Singapur.
Petición de ejemplo de la página del modelo en QwenCloud, con la clave en la variable DASHSCOPE_API_KEY:
curl --location 'https://maas.qwencloudapi.com/api/v1/services/aigc/multimodal-generation/generation' \
  --header 'Content-Type: application/json' \
  --header "Authorization: Bearer $DASHSCOPE_API_KEY" \
  --data '{
    "model": "qwen-image-2.1-pro",
    "input": {
      "messages": [
        {"role": "user", "content": [
          {"text": "A minimalist poster for a book fair with the headline \"FERIA DEL LIBRO 2026\" in bold serif type"}
        ]}
      ]
    },
    "parameters": {"prompt_extend": true}
  }'
Con prompt_extend en true, el servicio amplía tu prompt antes de generar; ponlo en false si quieres controlar el texto exacto.
Si comparas con otros modelos cerrados de imagen por API, el de Google tiene precio y condiciones distintas: Nano Banana 2.1 ya es oficial: novedades, precio y dónde usarlo.
Fallos habituales con Qwen-Image-2.1: memoria, 4K, cfg y texto
| Síntoma | Causa probable | Qué hacer |
|---|---|---|
| Error de memoria al cargar o al generar | Archivo o resolución demasiado grandes para tu VRAM | Cuantización más pequeña (GGUF Q4_K_M), 1024 × 1024, lote de 1, cerrar otras apps que usen la GPU; o descarga a RAM |
| Faltan nodos o la plantilla no aparece | ComfyUI anterior al soporte | Actualiza; si usas la estable, puede que los nodos solo estén en Nightly |
| Ignora el prompt a 4K | Muy por encima de los 2K con los que se entrenó | Genera a 2K y escala después |
| El prompt negativo no cambia nada | cfg está en 1 | Súbelo a 2 solo si de verdad lo necesitas |
| Colores quemados o imagen rota | cfg demasiado alto (5) o demasiado bajo (0,5) | Vuelve a cfg 1 |
| Texto de la imagen mal escrito | Variación entre semillas | Prueba otras semillas; GIGAZINE lo corrigió cambiando la semilla. cfg 2 ayuda con texto denso |
| Edición muy lenta | Lienzo al tamaño de una foto grande | Baja resolution a 1024 o reduce image_1 |
| El PNG llega sin transparencia | La vista previa aplanó el canal alfa | Ábrelo en un editor; usa el formato de prompt RGBA |
Para Unsloth, las dimensiones deben ser múltiplos de 32 y como máximo 2048 por lado.
Preguntas frecuentes sobre Qwen-Image-2.1
¿Puedo vender las imágenes que genero con Qwen-Image-2.1 en local?
La cuenta oficial de Qwen dijo en X que las imágenes son tuyas, pero la licencia de los pesos solo permite investigación o evaluación. Si el trabajo es comercial (encargos, productos, publicidad), pide la licencia comercial a model-business@notice.qwencloud.com o usa la API de pago tras revisar las condiciones de Alibaba Cloud.
¿Qwen-Image-2.1 entiende prompts en español?
La ficha oficial no publica una lista de idiomas. GIGAZINE usó prompts en japonés sin problema, y los ejemplos oficiales están en inglés. Si un texto dentro de la imagen debe salir exacto, escríbelo entre comillas y prueba varias semillas.
¿Funciona Qwen-Image-2.1 en un Mac?
Unsloth propone versiones GGUF con un backend nativo compatible a partir de 12–16 GB de memoria unificada, y su app de escritorio funciona en macOS. Son estimaciones: empieza a 1024 × 1024.
¿Qué diferencia hay entre Qwen-Image-2.1 y qwen-image-2.1-pro?
Qwen-Image-2.1 son los pesos abiertos que ejecutas tú, con licencia no comercial. qwen-image-2.1-pro es el modelo alojado que Alibaba cobra por imagen (0,04 $ en Singapur); Alibaba no aclara si es idéntico a los pesos abiertos.
¿Puedo usar Qwen-Image-2.1 desde Claude?
Claude puede generar imágenes a través de conectores como el de Hugging Face; las opciones por plan están en Conector de Claude para generar imágenes: cuál elegir en tu plan. La licencia del modelo no cambia por usarlo a través de un conector.