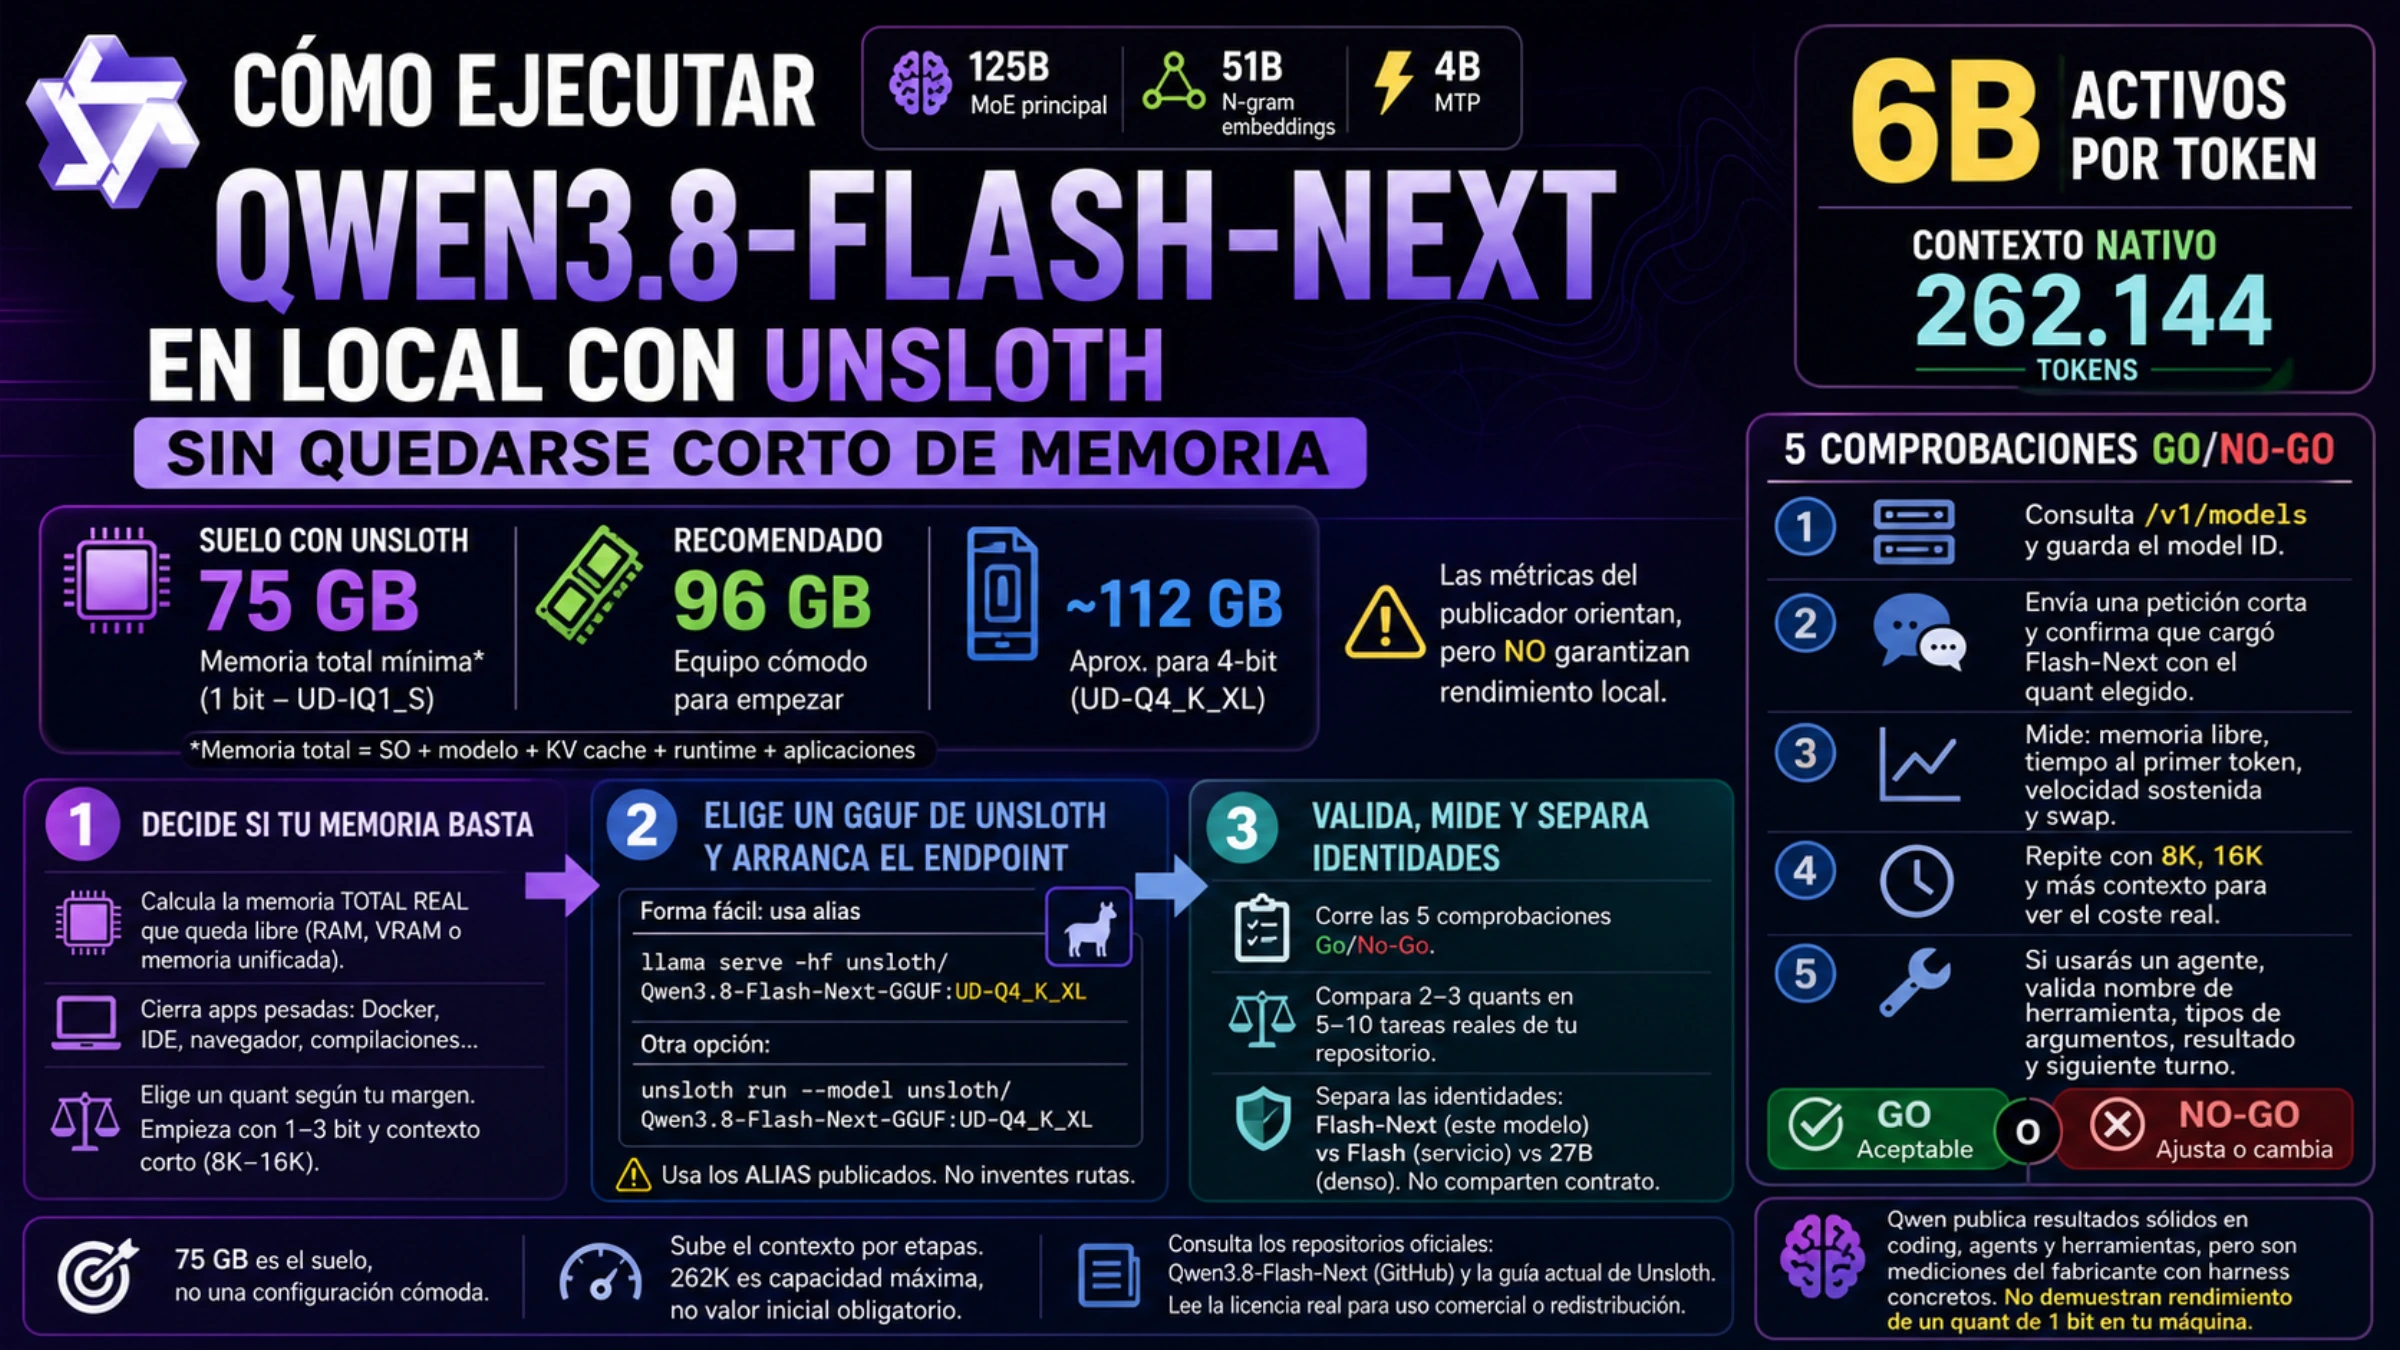
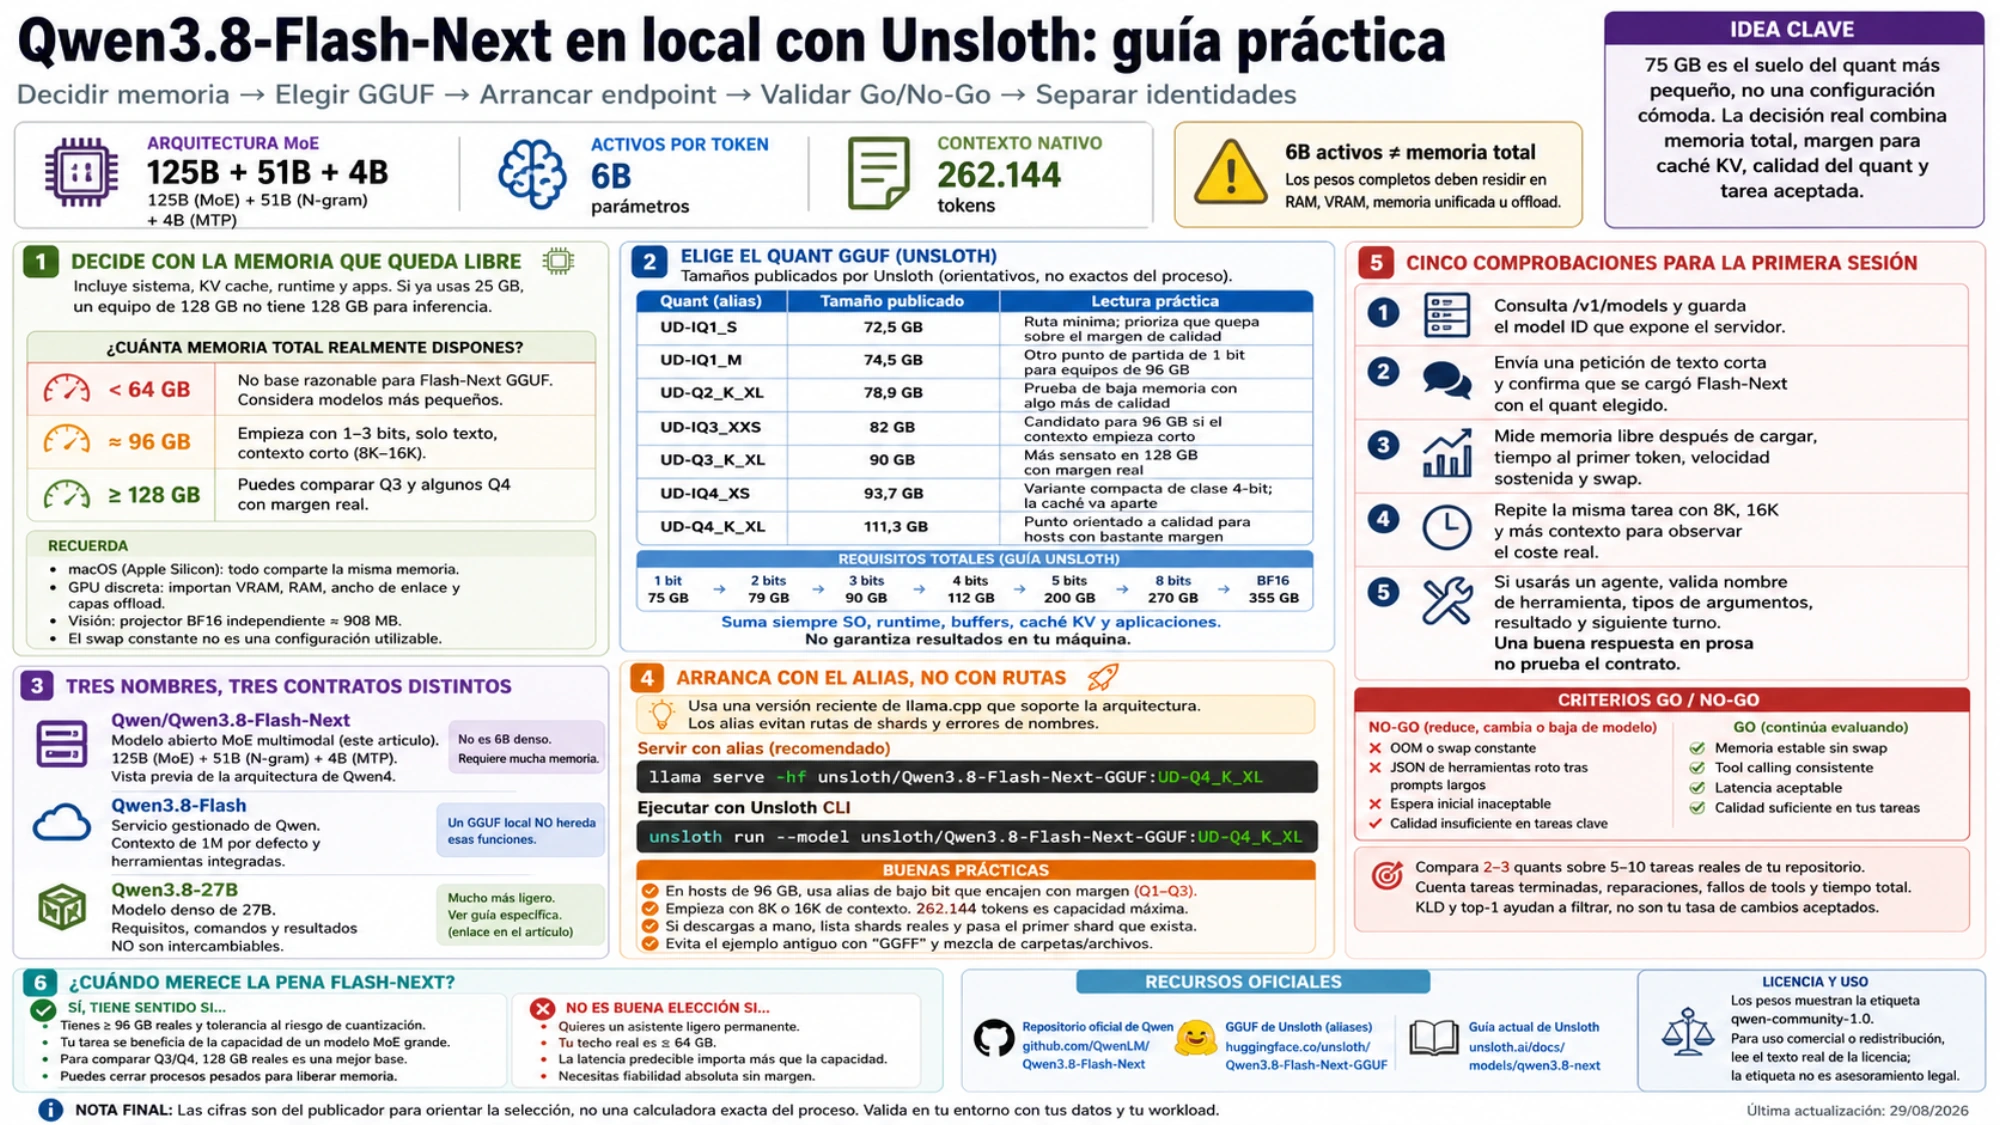
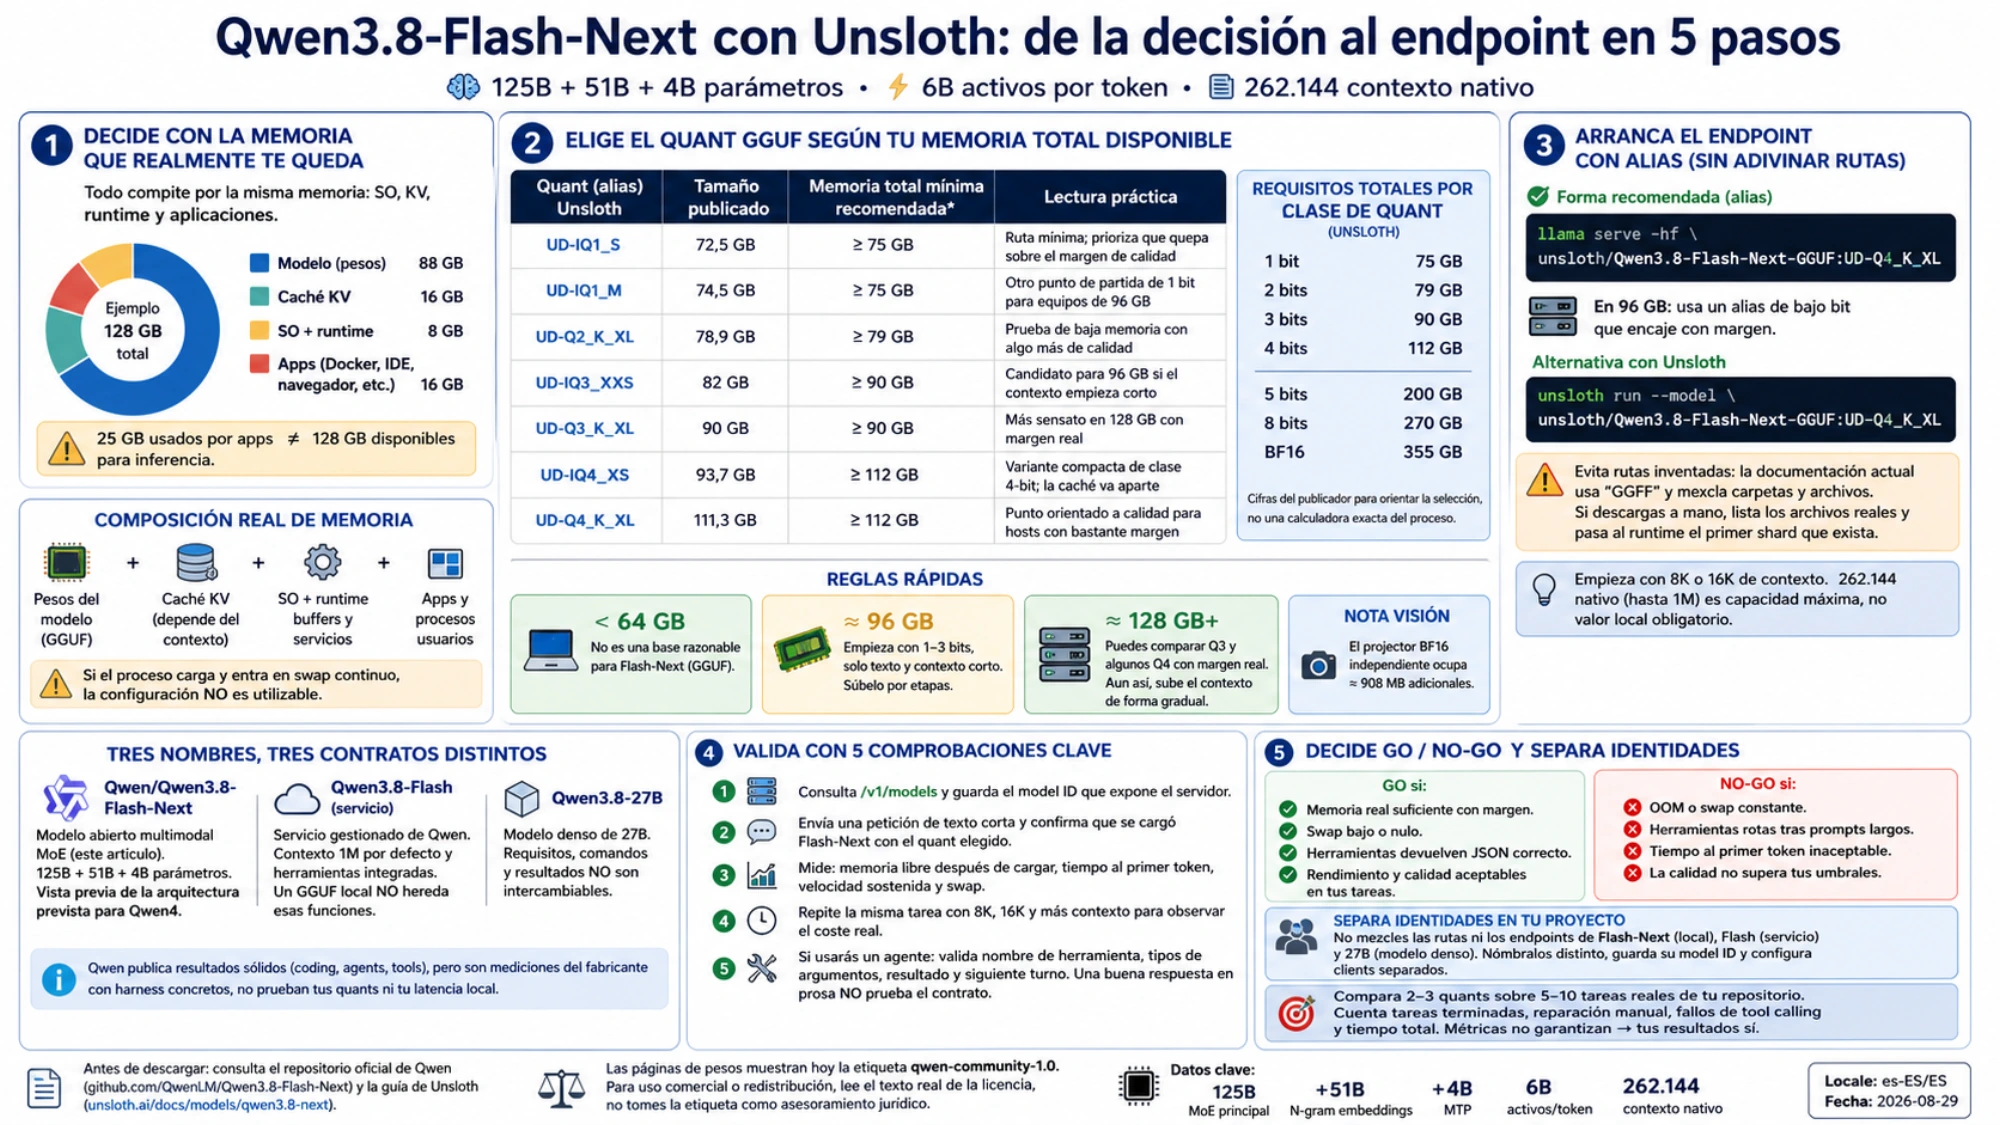
Qwen3.8-Flash-Next puede ejecutarse en local, pero no es un modelo de 6B que quepa sin más en una GPU doméstica. Unsloth fija 75 GB como memoria total mínima para su versión cuantizada de 1 bit más pequeño y recomienda un equipo con 96 GB de RAM o memoria unificada. Para 4 bits, la tabla consultada el 12 de septiembre de 2026 indica entre 96 y 114 GB. Un Mac o una estación de 128 GB es una plataforma razonable de prueba, no una garantía para usar 262K de contexto junto a todas las aplicaciones habituales.
La cifra de 6B describe los parámetros del modelo principal activados por token. La ficha oficial de Qwen enumera 125B parámetros en el MoE principal, 51B adicionales en N-gram embeddings y 4B MTP. Los pesos necesarios siguen teniendo que residir en RAM, VRAM, memoria unificada o una distribución de pesos entre dispositivos.
Decide con la memoria que queda libre
En Apple Silicon, macOS, el modelo, la caché KV y las aplicaciones comparten la misma memoria. En un sistema con GPU discreta importan tanto VRAM y RAM como la velocidad del enlace y la cantidad de capas alojadas en la memoria del sistema en lugar de la GPU. Si Docker, el IDE, el navegador y una compilación ya ocupan 25 GB, un equipo rotulado como 128 GB no dispone de 128 GB para inferencia.
La tabla actual de Unsloth permite planificar así:
| Cuantización | Tamaño publicado | Lectura práctica |
|---|---|---|
UD-IQ1_S | 72,5 GB | Ruta mínima; prioriza que quepa sobre el margen de calidad |
UD-IQ1_M | 74,5 GB | Otro punto de partida de 1 bit para equipos de 96 GB |
UD-Q2_K_XL | 78,9 GB | Prueba de baja memoria con algo más de calidad |
UD-IQ3_XXS | 82 GB | Candidato para 96 GB si el contexto empieza corto |
UD-Q3_K_XL | 90 GB | Más sensato en 128 GB con margen real |
UD-IQ4_XS | 93,7 GB | Variante compacta de clase 4-bit; la caché va aparte |
UD-Q4_K_XL | 111,3 GB | Punto orientado a calidad para equipos con bastante memoria libre |
La guía de Unsloth resume los requisitos totales de 1/2/3/4 bits en 75/79/90/96–114 GB; después sube a 163 GB para 5 bits, 200 GB para 8 bits y 355 GB para BF16. Son cifras del publicador para orientar la selección, no una calculadora exacta del proceso.
Reserva además margen para el sistema operativo, el entorno de ejecución, los búferes, la caché KV y el cliente; el tamaño de descarga no equivale a la memoria total necesaria. Si se usa visión, el repositorio actual incluye un proyector visual BF16 independiente de unos 908 MB. Que el proceso cargue y acto seguido recurra continuamente a memoria de intercambio en disco no convierte la configuración en utilizable.
Por debajo de 64 GB, el GGUF completo de Flash-Next no es una base razonable. En torno a 96 GB conviene empezar con 1–3 bits, solo texto y contexto corto. Con 128 GB se pueden comparar Q3 y algunos Q4. Incluso con 192/256 GB, el contexto nativo de 262.144 tokens no tiene por qué ser el valor inicial.
Si el límite real está entre 24 y 48 GB y la tarea es programación con agentes locales, la guía de Qwen3.8-27B trata un modelo denso distinto y mucho más ajustado a ese hardware.
Tres nombres que corresponden a modelos y servicios distintos
Qwen/Qwen3.8-Flash-Next es el modelo abierto multimodal MoE de este artículo y una vista previa de la arquitectura prevista para Qwen4. Combina Gated DeltaNet con Qwen Sparse Attention y amplía capacidad mediante N-gram embeddings.
Qwen3.8-Flash es el servicio gestionado de Qwen. Su descripción oficial añade características de producto como contexto de 1M por defecto y herramientas integradas. Un GGUF local no hereda esas funciones.
Qwen3.8-27B es un modelo denso de 27B, no una cuantización pequeña de Flash-Next. Sus requisitos, comandos y resultados no son intercambiables.
Qwen publica resultados de programación, agentes y uso de herramientas. Son mediciones del fabricante con entornos de evaluación concretos: justifican probar el modelo, pero no demuestran que una cuantización de 1 bit preserve las llamadas a herramientas en tu entorno ni predicen el tiempo de respuesta de tu equipo.
Arranca con el alias, no con una ruta inventada
Instala una versión reciente de llama.cpp que soporte la arquitectura. El repositorio GGUF de Unsloth publica alias para sus cuantizaciones y permite iniciar la descarga y el servidor sin reconstruir los nombres de los archivos fragmentados:
llama serve -hf unsloth/Qwen3.8-Flash-Next-GGUF:UD-Q4_K_XLEn un equipo de 96 GB hay que sustituir Q4 por una cuantización de menos bits que encaje con margen. Unsloth también documenta su propia entrada:
unsloth run --model unsloth/Qwen3.8-Flash-Next-GGUF:UD-Q4_K_XLLa ruta por alias evita un problema actual de la documentación manual. En la versión comprobada, el ejemplo usa GGFF como directorio local y después mezcla un directorio UD-IQ1_S con un archivo UD-Q4_K_XL. Puede corregirse pronto. Si descargas a mano, lista los archivos reales y indica al programa el primer fragmento del modelo elegido, manteniendo todos sus archivos en la misma carpeta; no adivines la ruta.
Empieza con 8K o 16K de contexto. Los 262.144 tokens nativos y la extensión hasta un millón son capacidad máxima, no valor local obligatorio. Sube por etapas con la misma instrucción y registra el consumo de caché, el tiempo de procesamiento y el uso de memoria de intercambio.
Cinco comprobaciones para la primera sesión
- Consulta
/v1/modelsy guarda el identificador del modelo que expone el servidor. - Envía una petición de texto corta y confirma que se cargó Flash-Next con la cuantización elegida.
- Mide memoria libre después de cargar, tiempo al primer token, velocidad sostenida y memoria de intercambio.
- Repite la misma tarea con 8K, 16K y más contexto para observar el coste real.
- Si usarás un agente, valida nombre de herramienta, tipos de argumentos, resultado y siguiente turno; una buena respuesta en prosa no demuestra que el ciclo de herramientas funcione correctamente.
Después compara dos o tres cuantizaciones sobre 5–10 tareas de repositorio que tu equipo pueda juzgar. Cuenta tareas terminadas, reparación manual, fallos en llamadas a herramientas y tiempo total. Las medidas KLD y top-1 de Unsloth ayudan a filtrar, pero no son la tasa de cambios aceptados en tu proyecto.
Si se agota la memoria (OOM), hay intercambio continuo con disco, falla el JSON de herramientas tras una entrada larga o la espera inicial es inaceptable, la configuración no sirve para esa carga. Reduce el contexto, cambia de cuantización o utiliza un modelo menor. Cargar pesos solo prueba compatibilidad básica.
Cuándo merece la pena Flash-Next
El experimento tiene sentido con al menos un sistema de clase 96 GB, tolerancia al riesgo de cuantización baja y una tarea que se beneficie de la capacidad de un modelo grande con activación dispersa. Para comparar Q3/Q4, 128 GB realmente disponibles ofrecen una base mejor, sobre todo si se pueden cerrar procesos pesados.
No es una buena elección para un asistente ligero permanente, un techo de 64 GB o una carga donde la latencia predecible importe más que la capacidad. La arquitectura reduce cálculo por token, pero no elimina el almacenamiento de pesos y N-gram embeddings.
Antes de descargar, consulta el repositorio oficial de Qwen y la guía actual de Unsloth. Las páginas de pesos muestran hoy la etiqueta qwen-community-1.0; para uso comercial o redistribución hay que leer el texto real de la licencia, no tomar la etiqueta como asesoramiento jurídico.