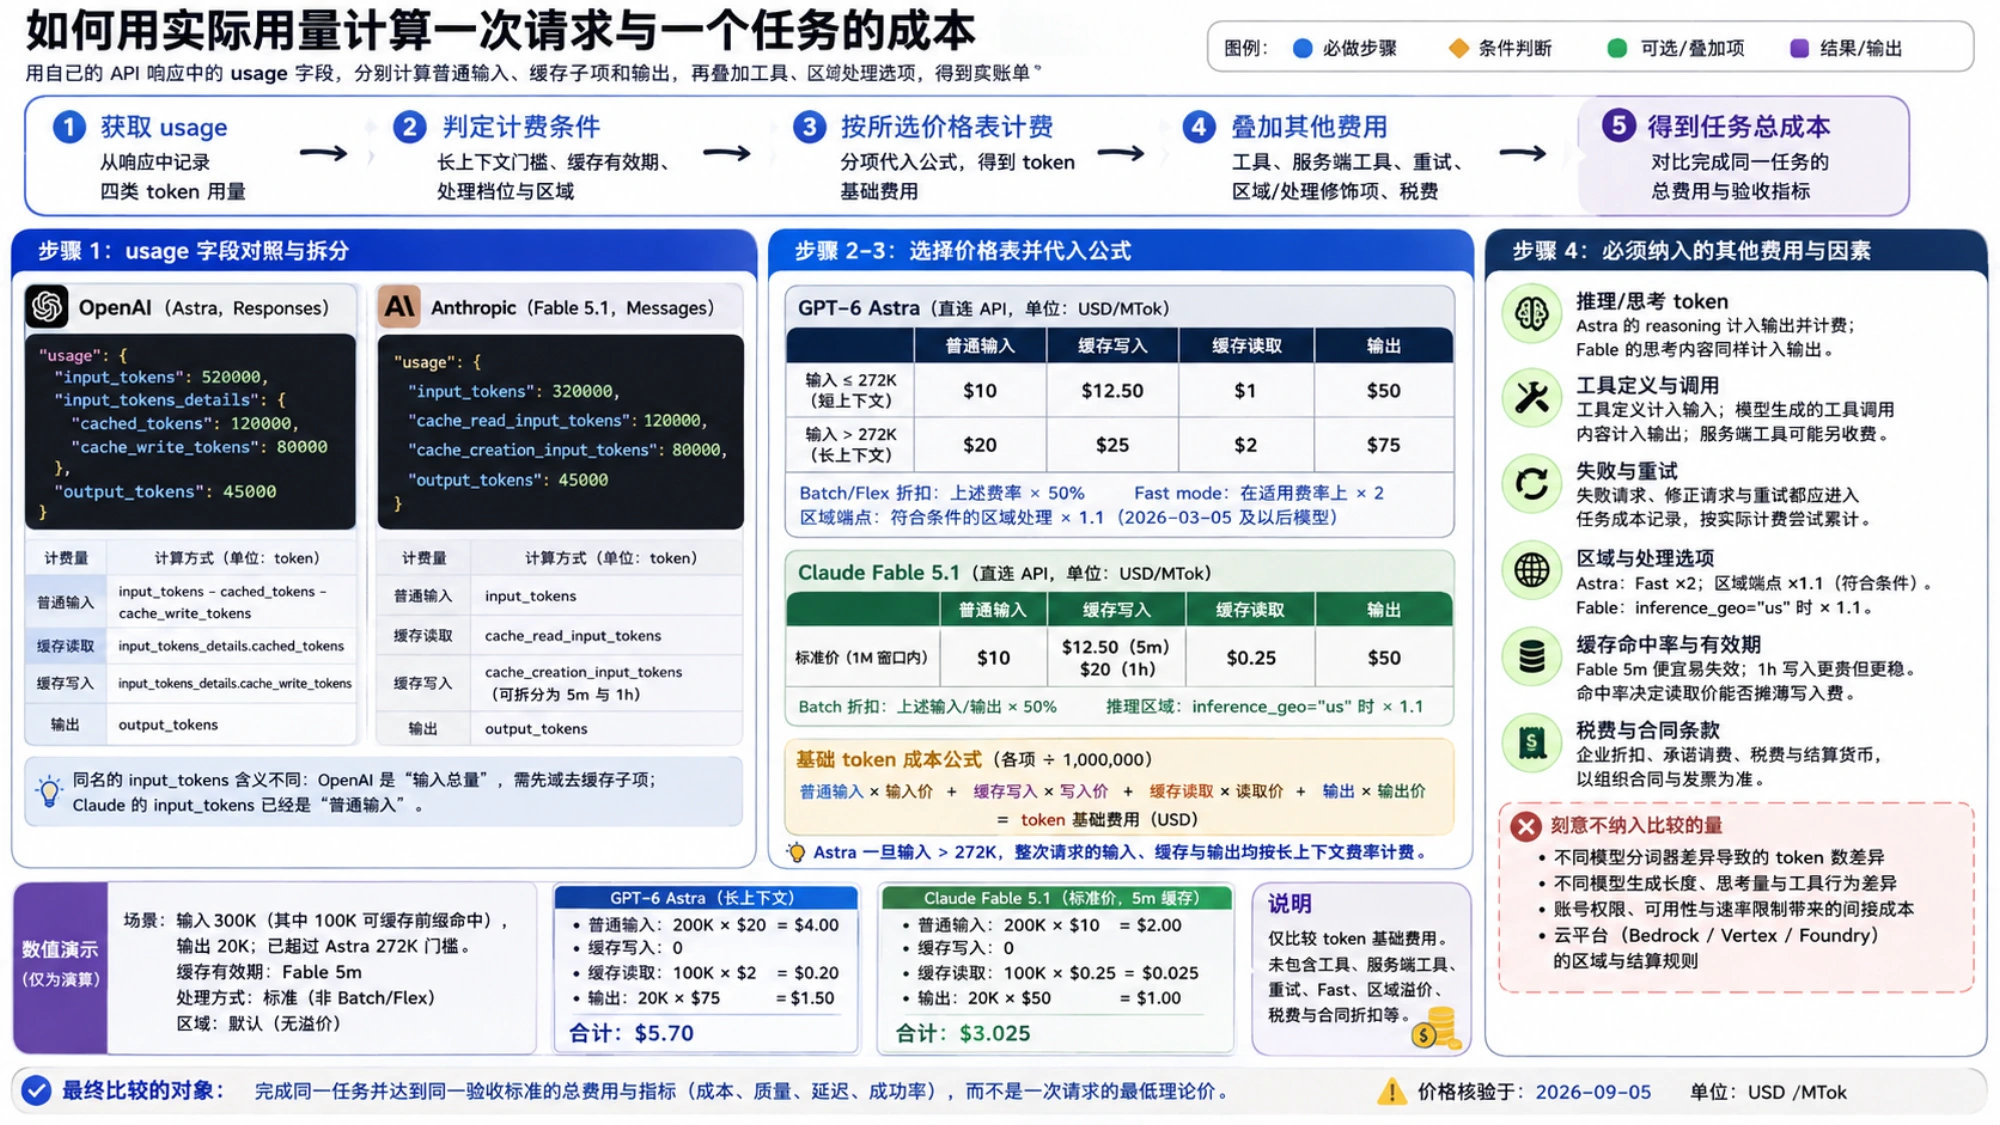
只看标准价的第一行,GPT-6 Astra 和 Claude Fable 5.1 像是“同价”:普通输入都是每百万 token 10 美元,输出都是 50 美元。但这个结论只适用于直连 API、标准处理、未触发 Astra 长上下文档位,而且还没有把缓存、工具和区域选项算进去。
真正会改变账单的是四件事:Fable 5.1 的缓存读取便宜得多;两家的缓存写入与有效期不是同一套规则;Astra 的输入一旦超过 272K token,整次请求都会进入更高档位;Fable 5.1 在 1M 上下文窗口内不另收长上下文溢价。因而,没有同一任务的实际 token 与调用记录,就不能得到“哪款模型永远更便宜”的答案。
本文价格核验于 2026 年 9 月 5 日,单位均为美元/每百万 token(USD/MTok)。比较的是 OpenAI 与 Anthropic 的直连 API 公开价,不是 ChatGPT、Claude 个人订阅,也不代表企业合同、云市场私有报价或税后账单。
先看同一口径下的标准单价
下面把普通输入、缓存写入、缓存读取和输出分开。缓存写入是首次建立可复用前缀的费用,缓存读取是后续命中该前缀的费用,两者不能合并成一个笼统的“缓存价”。
| 模型与适用条件 | 普通输入 | 缓存写入 | 缓存读取/命中 | 输出 |
|---|---|---|---|---|
| GPT-6 Astra,输入不超过 272K | $10 | $12.50 | $1 | $50 |
| GPT-6 Astra,输入超过 272K | $20 | $25 | $2 | $75 |
| Claude Fable 5.1,1M 上下文窗口内 | $10 | $12.50(5 分钟)或 $20(1 小时) | $0.25 | $50 |
GPT-6 Astra 的数字来自 OpenAI 的 API 价格页和 Astra 模型页。关键不是“超过 272K 的那一小段更贵”,而是只要输入 token 超过 272K,整次请求都按长上下文档位计费:输入及缓存项目变为短上下文的 2 倍,输出变为 1.5 倍。
Claude Fable 5.1 的 模型页与 Claude API 价格说明列出的标准输入、输出与短档 Astra 相同。区别在于,Fable 5.1 的完整 1M-token 上下文窗口保持标准每-token 费率;缓存读取/刷新为 $0.25,而缓存写入价格取决于选择 5 分钟还是 1 小时有效期。
这张表能确认单位费率,却不能确认一次任务会产生多少 token。两家 分词器、工具定义、思考过程、截断与重试方式都可能不同;同一份文本不能先假定会得到相同的计费 token 数。
缓存便宜多少,取决于能否稳定命中
缓存只对可复用的稳定前缀有意义。OpenAI 的 Prompt Caching 说明规定,GPT-5.6 及以后模型至少需要 1,024 个可缓存前缀 token;Astra 的缓存写入是普通输入价的 1.25 倍,读取是 0.1 倍。prompt_cache_options.ttl 当前只支持并默认使用 30m,命中会刷新有效期,而不会再次收取缓存写入费。是否命中仍取决于前缀稳定、路由一致且缓存尚未过期。
Fable 5.1 的缓存读取/刷新为 $0.25/MTok,只有 Astra 短上下文缓存读取价的四分之一;不过建立 1 小时缓存要付 $20/MTok,比 Astra 的 $12.50/MTok 更高。究竟谁省钱,要看同一前缀会在有效期内被复用多少次,而不是只比较读取价格。
假设一个任务连续调用 10 次,每次都有 100K token 的稳定前缀、20K token 的新增普通输入和 10K token 的输出;第一次写入缓存,后 9 次全部命中。以下只是按公开单价演示计算,并不假装是两款模型的实测 token 用量:
| 方案 | 首次调用 | 后 9 次 | 10 次合计 |
|---|---|---|---|
| Astra,30 分钟缓存 | $1.25 + $0.20 + $0.50 | 9 ×($0.10 + $0.20 + $0.50) | $9.15 |
| Fable,5 分钟缓存 | $1.25 + $0.20 + $0.50 | 9 ×($0.025 + $0.20 + $0.50) | $8.475 |
| Fable,1 小时缓存 | $2.00 + $0.20 + $0.50 | 9 ×($0.025 + $0.20 + $0.50) | $9.225 |
这个例子说明,Fable 的低读取价需要足够多的命中来摊薄写入费;1 小时缓存也不是天然更贵,它购买的是更长的复用时间。如果调用间隔让 5 分钟缓存反复失效,重新写入的次数可能比读取单价更重要。反过来,前缀经常变化时,两家都可能几乎吃不到缓存收益。
272K 是 Astra 成本曲线上的硬拐点
先看一个不会触发门槛的无缓存请求:120K 输入、20K 输出,两款模型按标准公开价计算都是:
0.12 × $10 + 0.02 × $50 = $2.20
如果输入增长到 300K、输出仍为 20K,且暂时忽略缓存和工具费,差异就会出现:
- GPT-6 Astra:
0.30 × $20 + 0.02 × $75 = $7.50 - Claude Fable 5.1:
0.30 × $10 + 0.02 × $50 = $4.00
Astra 不是只对超出的 28K 输入加价,300K 输入和对应输出都按长上下文档位计算。对于经常在 272K 附近波动的代码仓库、研究档案或长对话,减少一次请求中的无关上下文,可能比微调几千个输出 token 更能稳定预算。
Fable 5.1 的 1M 上下文没有这道溢价门槛,但“单价不跳档”不等于“长请求便宜”。900K 输入仍然会按 900K token 收费;模型实际生成的思考内容、输出、工具参数和重试也照常进入账单。超过模型允许范围的任务同样需要拆分或压缩。
Batch 能把基础 token 价减半
两家都为异步批处理提供输入与输出 50% 折扣,适合可以排队、无需实时返回的离线评测、分类、抽取或批量生成。
OpenAI 的 Astra Batch 与 Flex 短上下文费率为输入 $5、缓存读取 $0.50、缓存写入 $6.25、输出 $25;超过 272K 输入后则为 $10、$1、$12.50、$37.50。长上下文门槛并不会因为改用 Batch 或 Flex 而消失,且 Flex 与 Batch 的响应方式、排队和适用条件也不是同一个产品合同。
Anthropic 的 Message Batches API 对 Fable 5.1 的普通输入和输出分别收 $5 与 $25/MTok。官方说明 Batch 可以与 Prompt Caching 组合,缓存和数据区域修饰项会继续作用于账单。实际预算表应逐项采用对应官方费率,不能把“50%”不加区分地乘到所有未知费用上。
例如上面的 120K 输入、20K 输出若完全按无缓存 Batch 输入/输出费率计算,两款模型的基础 token 费用都是 $1.10。这能证明批处理折扣的量级,不能证明任务完成成本相同:排队时间、失败重试、实际 token 数与工具费用仍可能不同。
可见文字不是完整的计费量
只用字符数估算账单,常会漏掉成本最高的部分。
GPT-6 Astra 的不可见 推理 token 会占用上下文窗口,并按输出 token 计费;工具调用需要使用 Responses API。API 接口 本身不另收费,但 OpenAI 的内置或服务端工具可能另收调用、检索内容、容器或存储费用。具体金额应从 API 用量记录 与相应工具计费项目 取得,不能只数最终返回给用户的文字。
Claude 工具请求会把传给模型的 tools 定义计入输入 token,模型为调用工具生成的内容计入输出 token。客户端工具本身没有单独的工具调用费,服务端工具则可能有按使用量计价的项目。Fable 5.1 还不支持 tool_choice 的 any 与 tool 类型,误用会返回 400;失败、修正请求与重试都应进入任务成本记录。
Anthropic 还说明,Claude 4.7 及以后的新版 分词器 对同一文本相较 Sonnet 4.6 及更早模型约产生 30% 更多 token,但增幅取决于语言与工作负载。这不是 Fable 5.1 相对 Astra 的换算率,也不能用固定百分比替代两边的实际 usage。
区域和处理档位也会改写公开价
公开标准价还可能叠加处理选项。OpenAI Fast mode 按适用费率 2 倍计价;符合条件的区域处理端点,对 2026 年 3 月 5 日及以后发布的模型加价 10%。Astra 的 EU data residency 当前不支持 Fast mode。
Claude API 默认 inference_geo: "global" 使用标准价;Claude 4.6 及以后模型选择 inference_geo: "us" 时,输入、输出、缓存写入和缓存读取统一乘 1.1。数据位置应先作为业务要求确认,不能只为了较低单价选择不符合业务要求的配置。
Amazon Bedrock、Google Cloud、Microsoft Foundry 等合作平台有各自的区域、结算与合同规则。直连 API 的美元表不能直接当成这些平台的最终账单;企业折扣、承诺消费、税费和汇率也只能以组织合同与发票为准。
按实际用量计算任务成本
对每次可验收任务,先分别从两个供应商记录下列数据,而不是把一份输入字符数复制到两边:
- 普通输入 token、缓存写入 token、缓存读取 token 和输出 token;
- Astra 是否超过 272K 输入,Fable 选择了哪种缓存有效期;
- Standard、Batch、Flex、Fast 或区域选项;
- reasoning/thinking、工具定义、服务端工具次数及对应费用;
- 失败请求、重试次数,以及达到同一完成标准所需的总调用量;
- 实际账户权限、合同折扣、税费与结算货币。
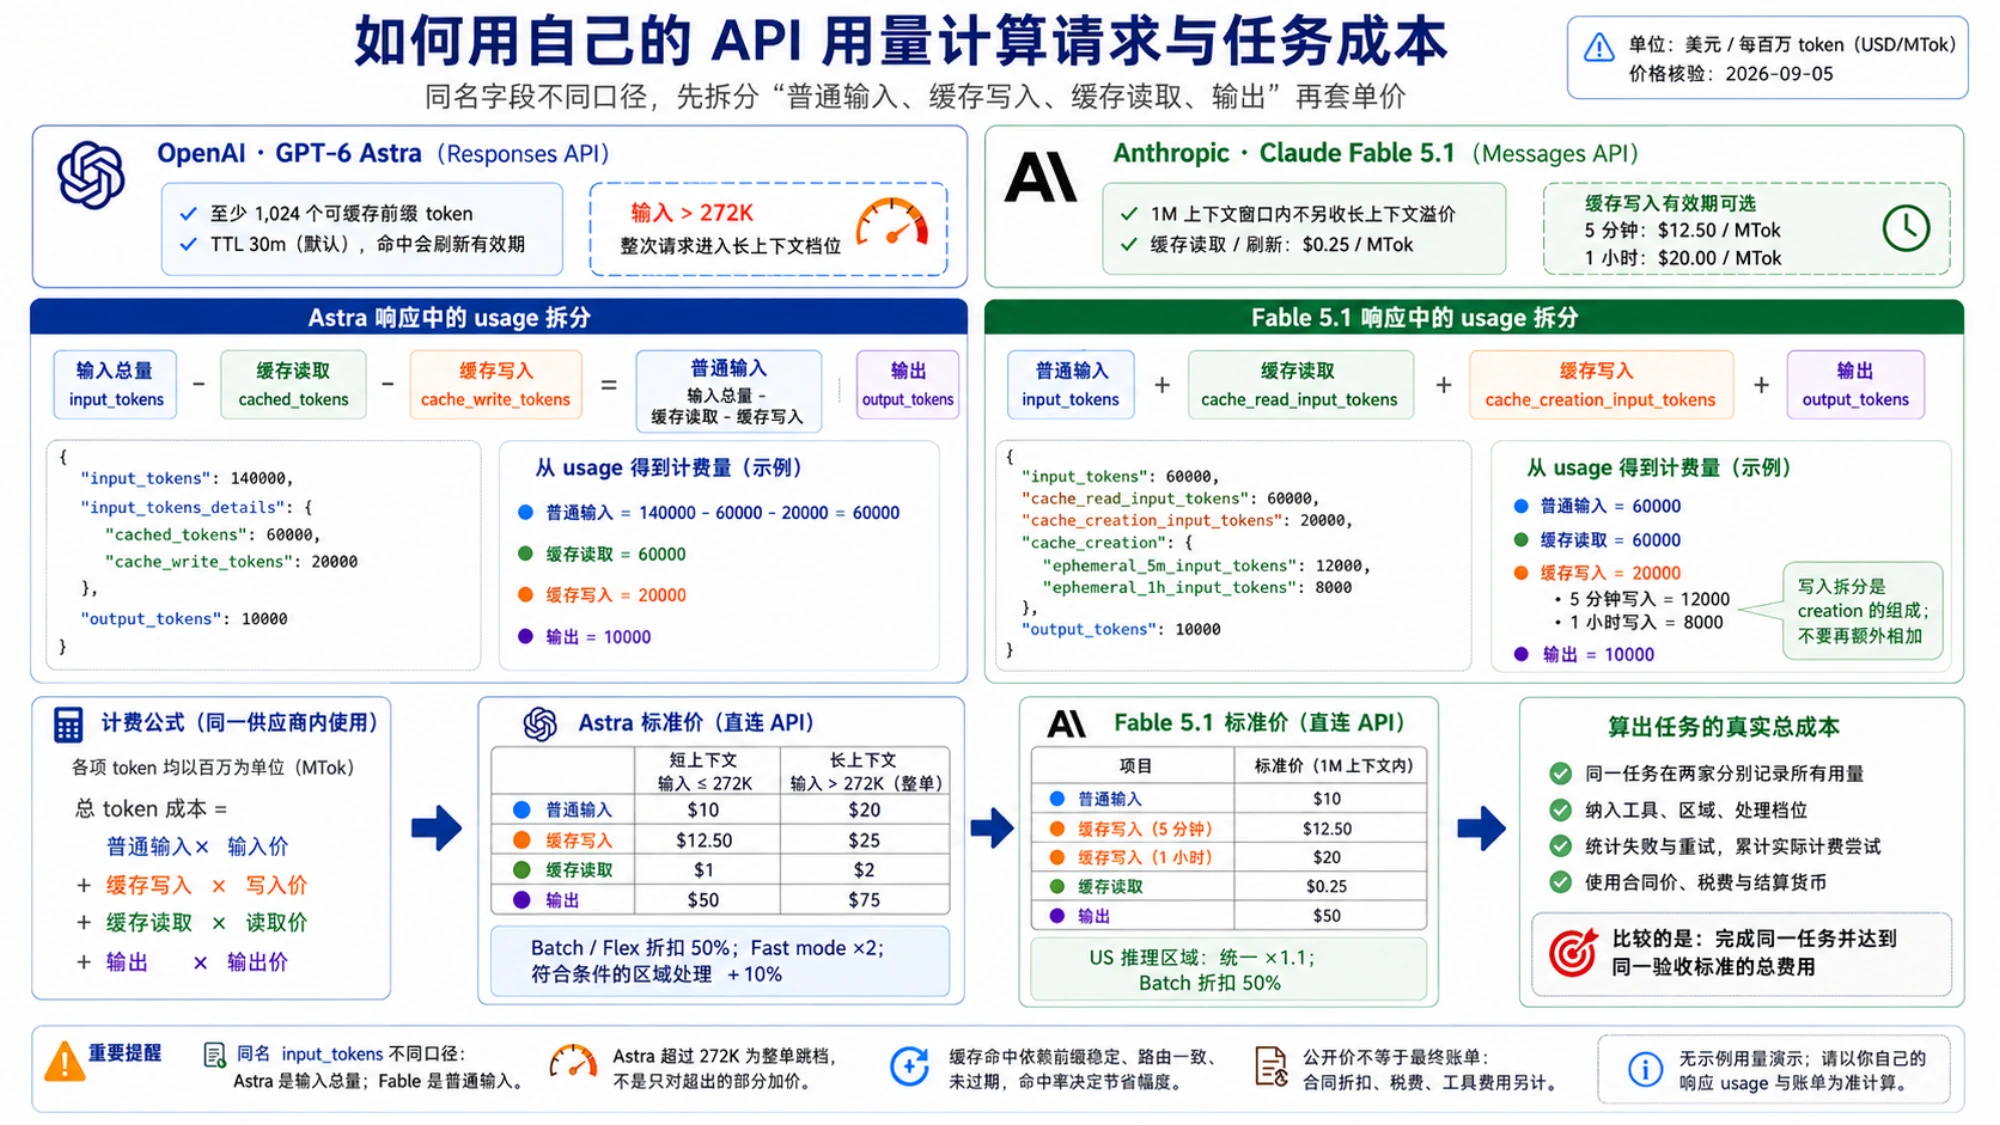
在同一供应商内部,可以先用下面的基本式复核 token 费用;各项 token 都先除以一百万:
token 成本 = 普通输入 × 输入价 + 缓存写入 × 写入价 + 缓存读取 × 读取价 + 输出 × 输出价
响应里同名的 input_tokens 不能直接互换。OpenAI 的计算说明中,普通输入是输入总量减去缓存读写;Claude 的用量说明中,input_tokens 本身就是普通输入。
| 计费量 | Astra 的 Responses usage | Claude Messages 的 usage |
|---|---|---|
| 普通输入 | input_tokens - input_tokens_details.cached_tokens - input_tokens_details.cache_write_tokens | input_tokens |
| 缓存读取 | input_tokens_details.cached_tokens | cache_read_input_tokens |
| 缓存写入 | input_tokens_details.cache_write_tokens | cache_creation_input_tokens |
| 输出 | output_tokens | output_tokens |
Claude 混用两种缓存有效期时,按 cache_creation.ephemeral_5m_input_tokens 和 ephemeral_1h_input_tokens 分别计价;它们是写入总量的拆分,不能再加一遍。缺失字段先核对所用接口与返回格式,不把未知量当零。
再按实际账单纳入工具、区域、处理档位、重试和税费。HTTP 失败本身不证明收费或免费,只累计实际计费的尝试。Astra 先判断是否整单进入长上下文档位;Fable 先确认缓存有效期与 inference_geo。Batch 则使用相应 Batch 价格行,不要在已折扣的单价上再次乘 0.5。
最后比较的应是“完成同一任务并达到同一验收标准的总费用”,而不是一次请求的理论最低价。对短上下文、无缓存、相近 token 用量的请求,两者基础价确实相同;高命中缓存通常更有利于 Fable 5.1;超过 272K 输入时,Fable 5.1 的标准 token 档位更低。可一旦两边生成长度、思考 token、工具调用、失败率或实际可用性不同,就必须让真实记录重新作答。
公开价格存在,不等于账号已经可用
OpenAI 在 2026 年 9 月 3 日的 API changelog宣布 GPT-6 Astra,正式模型 ID 为 gpt-6-astra,并列出 Responses、Chat Completions 与 Batch 支持;同期说明采用分阶段开放,先面向 Trusted Access Program 企业,API 与各 ChatGPT 方案在随后几天陆续开放。能看到模型页和价格页,不代表每个组织或项目已经获得调用权限。
Anthropic 在 2026 年 9 月 1 日发布 Claude Fable 5.1;截至本文核验日,其 官方模型参考将 claude-fable-5-1 标为 Active。合作云的地区和账户资格仍应单独确认。
因此,采购前最后一步不是再抄一遍价格表,而是在目标组织、项目和部署地区发起小规模测试请求,保存响应中的 usage 与供应商账单行。公开价告诉你每类 token 如何计费;只有自己的调用记录,才能告诉你一次真实任务究竟花多少钱。