如果 Codex 还没进入正常会话,就显示:
textError loading configuration: timed out waiting for cloud config bundle after 15s
这不是普通的“回答太慢”。计时发生在本地客户端加载配置的启动阶段。OpenAI 的托管配置说明明确写明:支持的客户端会先查找与当前身份匹配的有效缓存;没有有效缓存时,才通过远端请求和重试获取适用的云端配置包。请求失败或超时、同时又没有有效缓存时,客户端会返回错误,而不是忽略工作区策略直接启动。
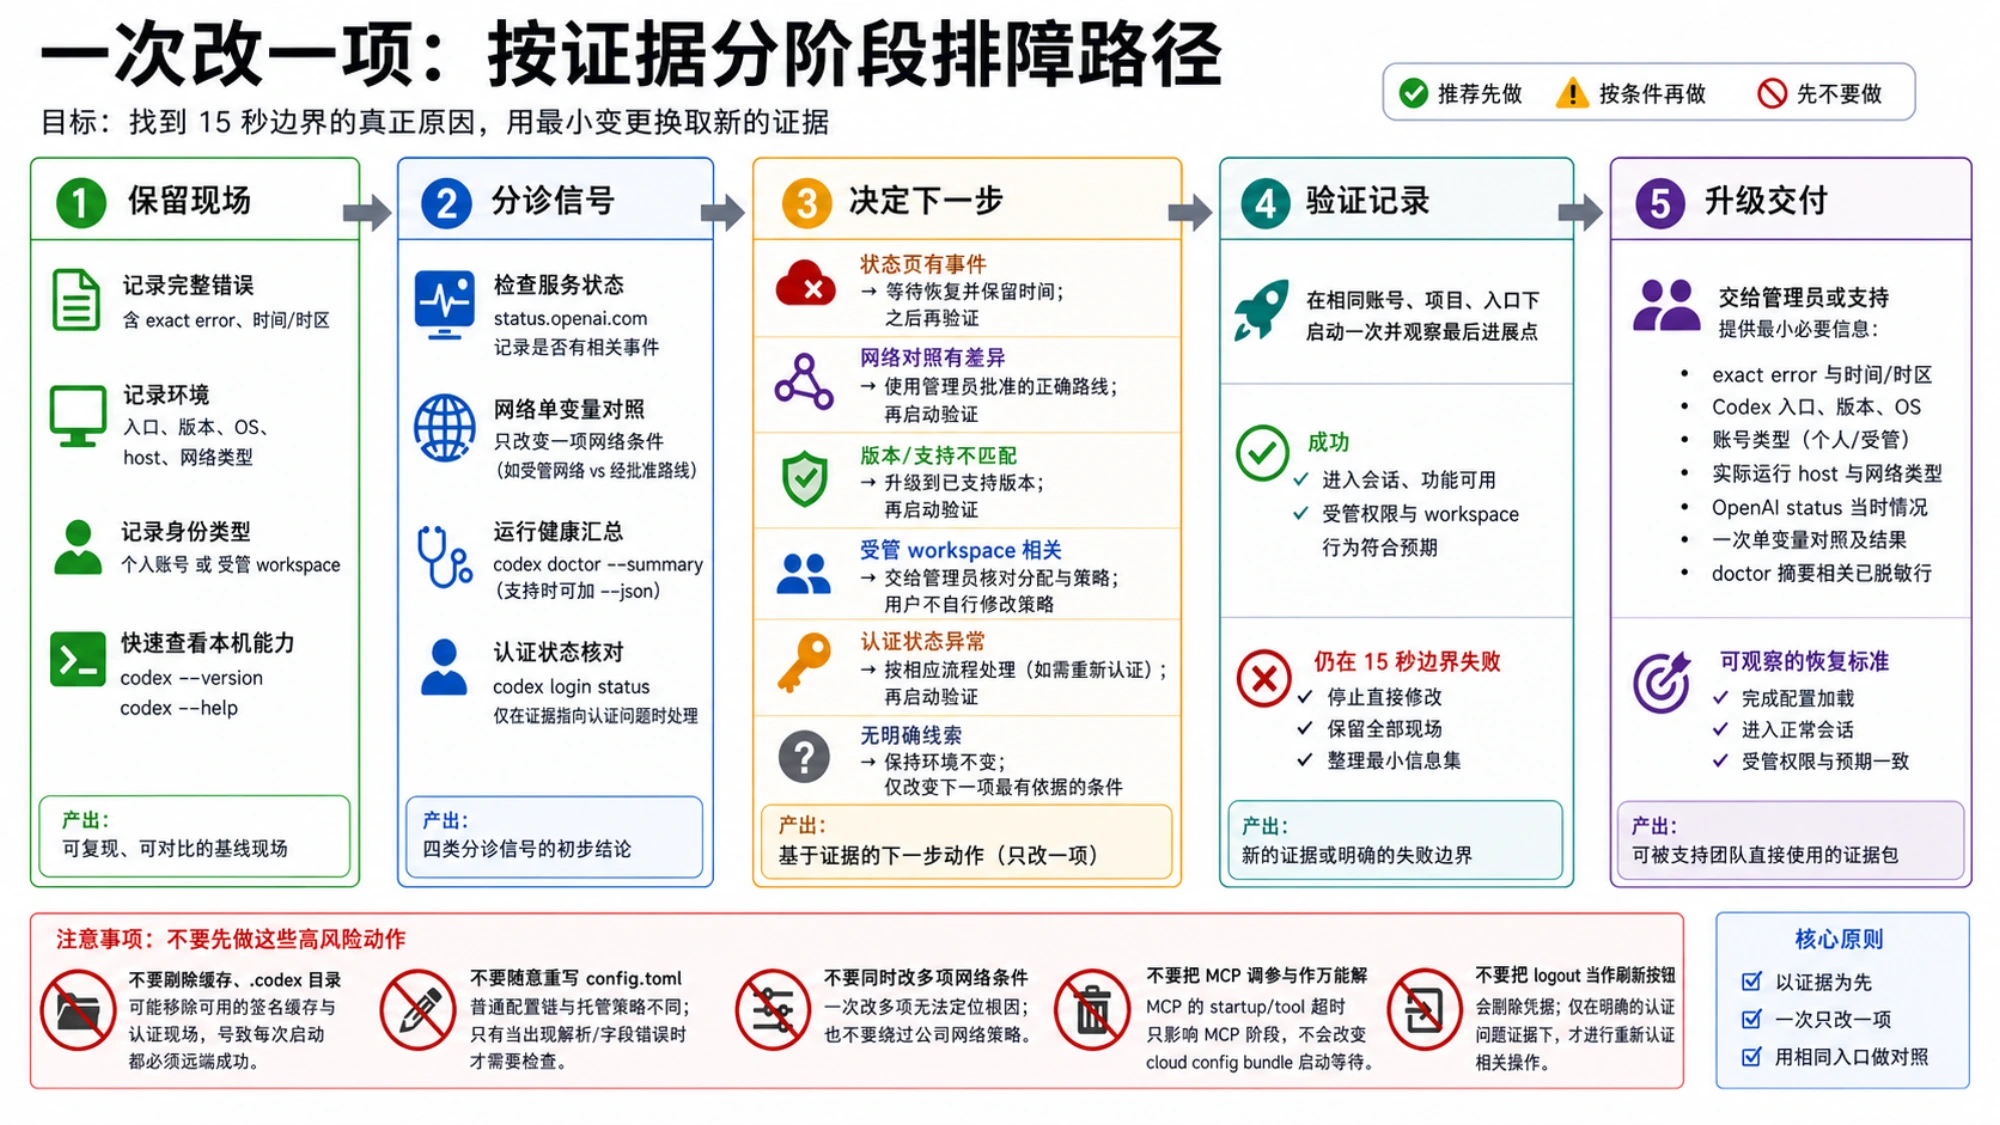
因此,先不要删除缓存、整个 .codex 目录或登录凭据。这些动作既不能证明根因,还可能删掉原本可用的策略副本或认证现场。真正要回答的是:这次启动为什么既没有可用缓存,也没能在等待期限内取得有效配置包?
先确认超时发生在哪一段
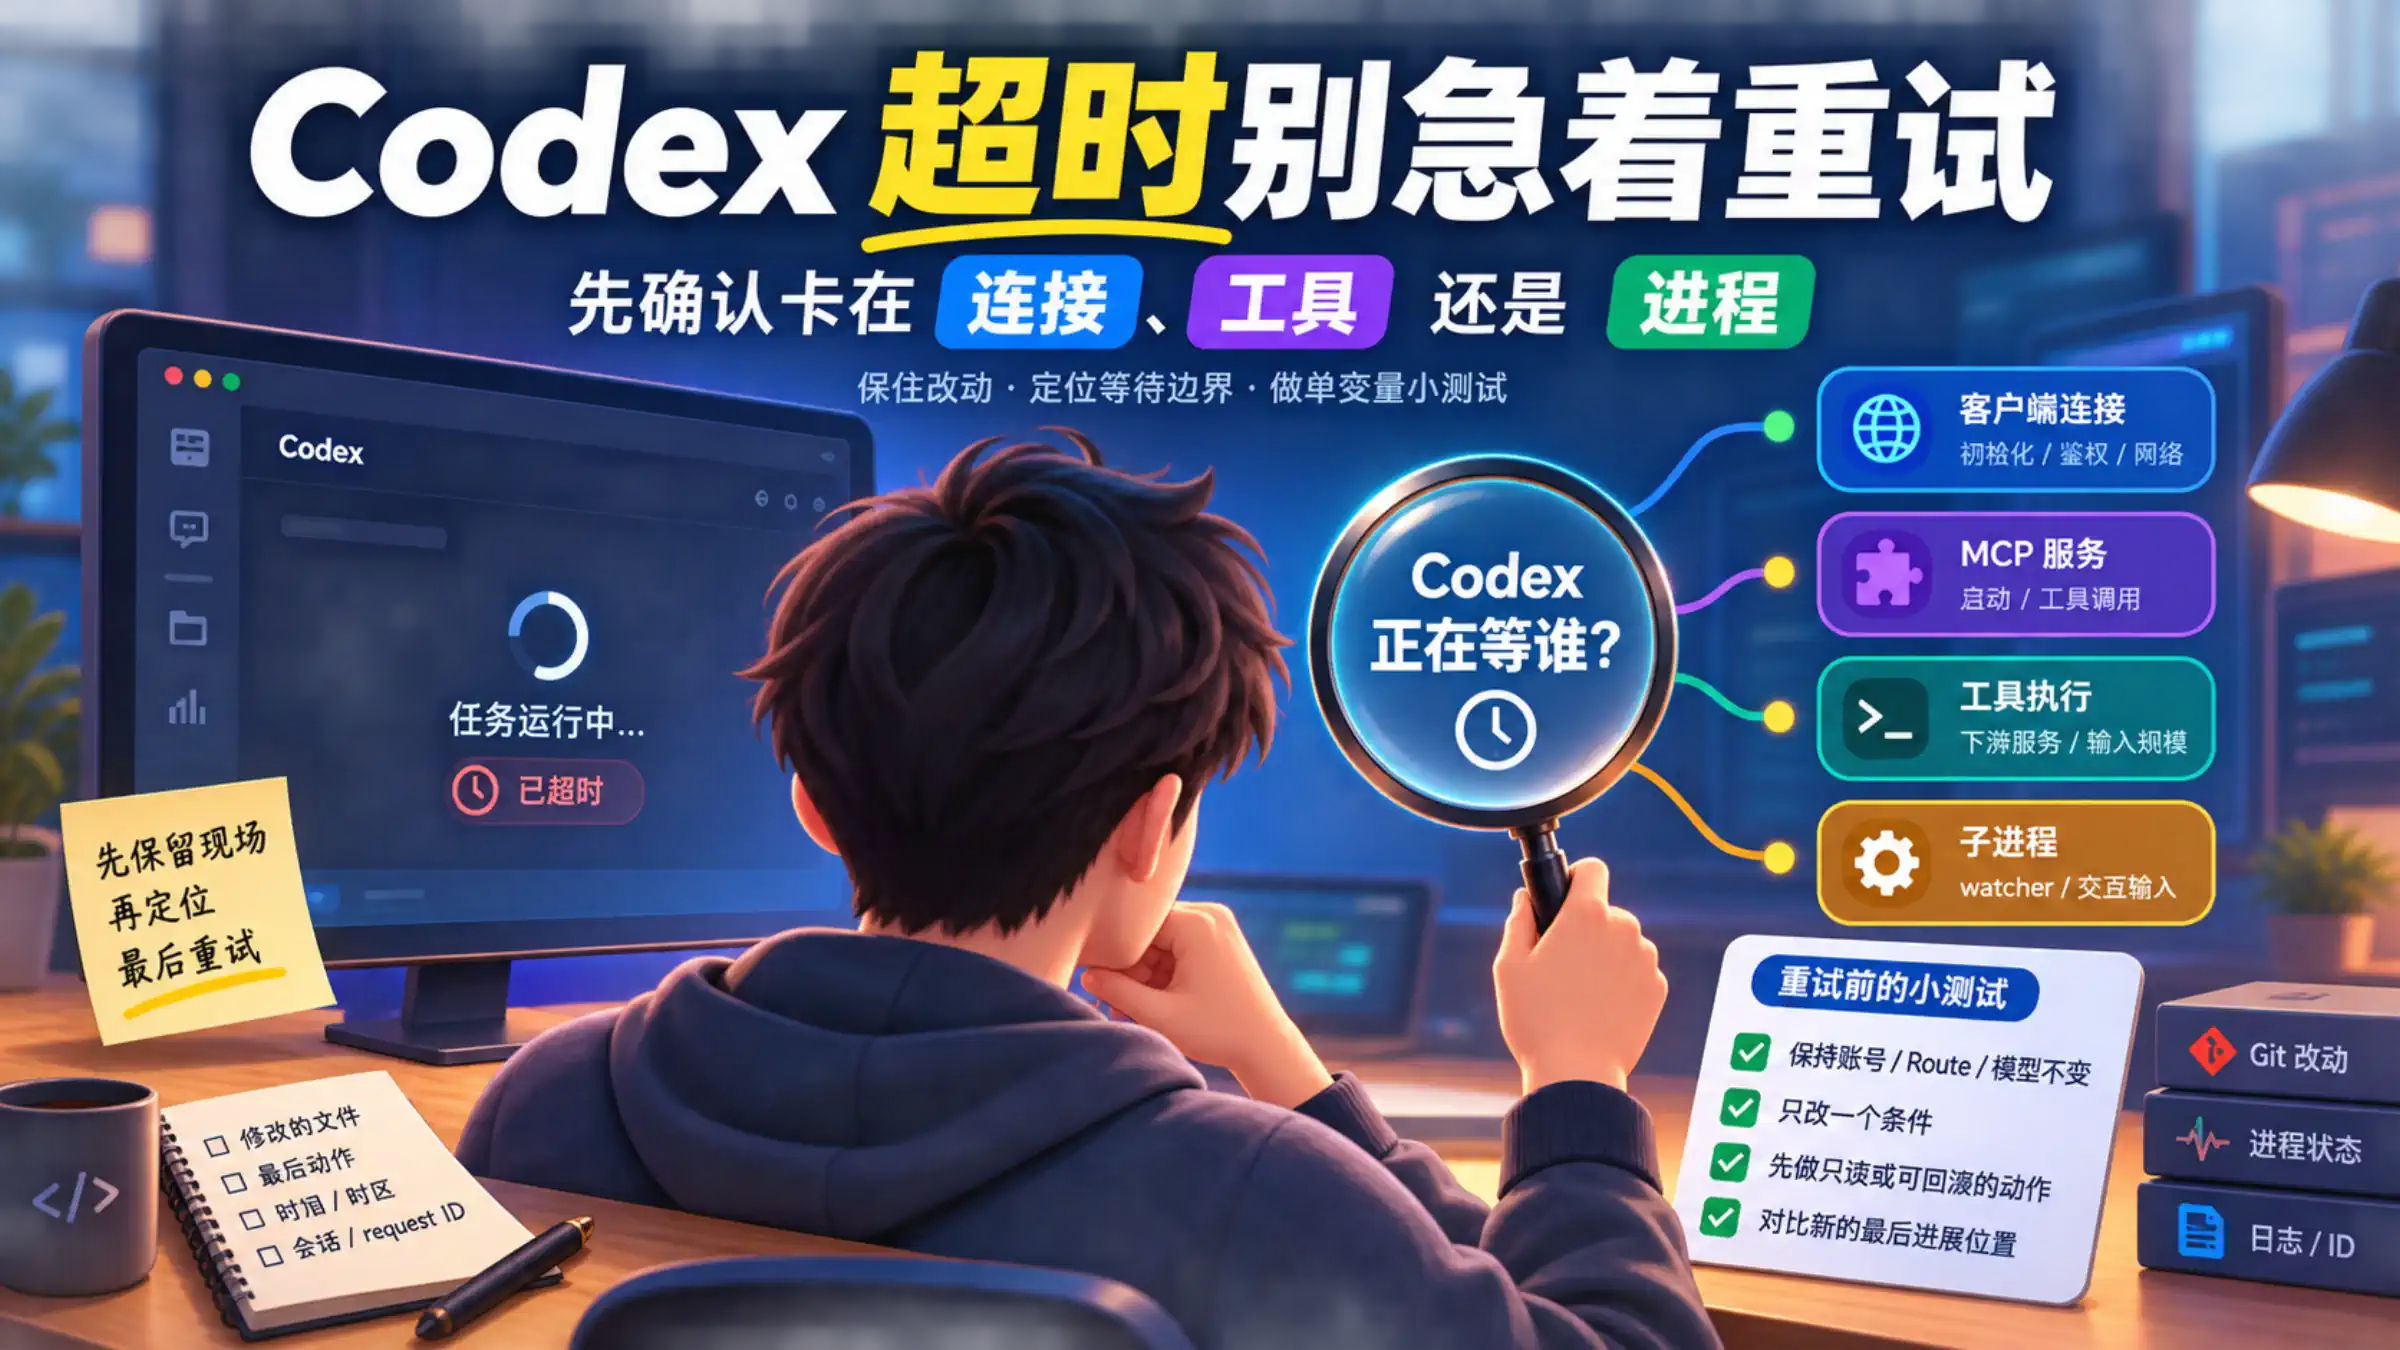
同样写着 timeout,责任边界可能完全不同:
| 可见时机 | 正在等待的对象 | 第一次检查 |
|---|---|---|
正常界面出现前,明确提到 cloud config bundle、cloud requirements 或 workspace-managed policies | 云端托管要求及其身份匹配缓存 | 保留原始错误,检查服务状态、客户端版本、账号/workspace 和 Codex host 的网络路线 |
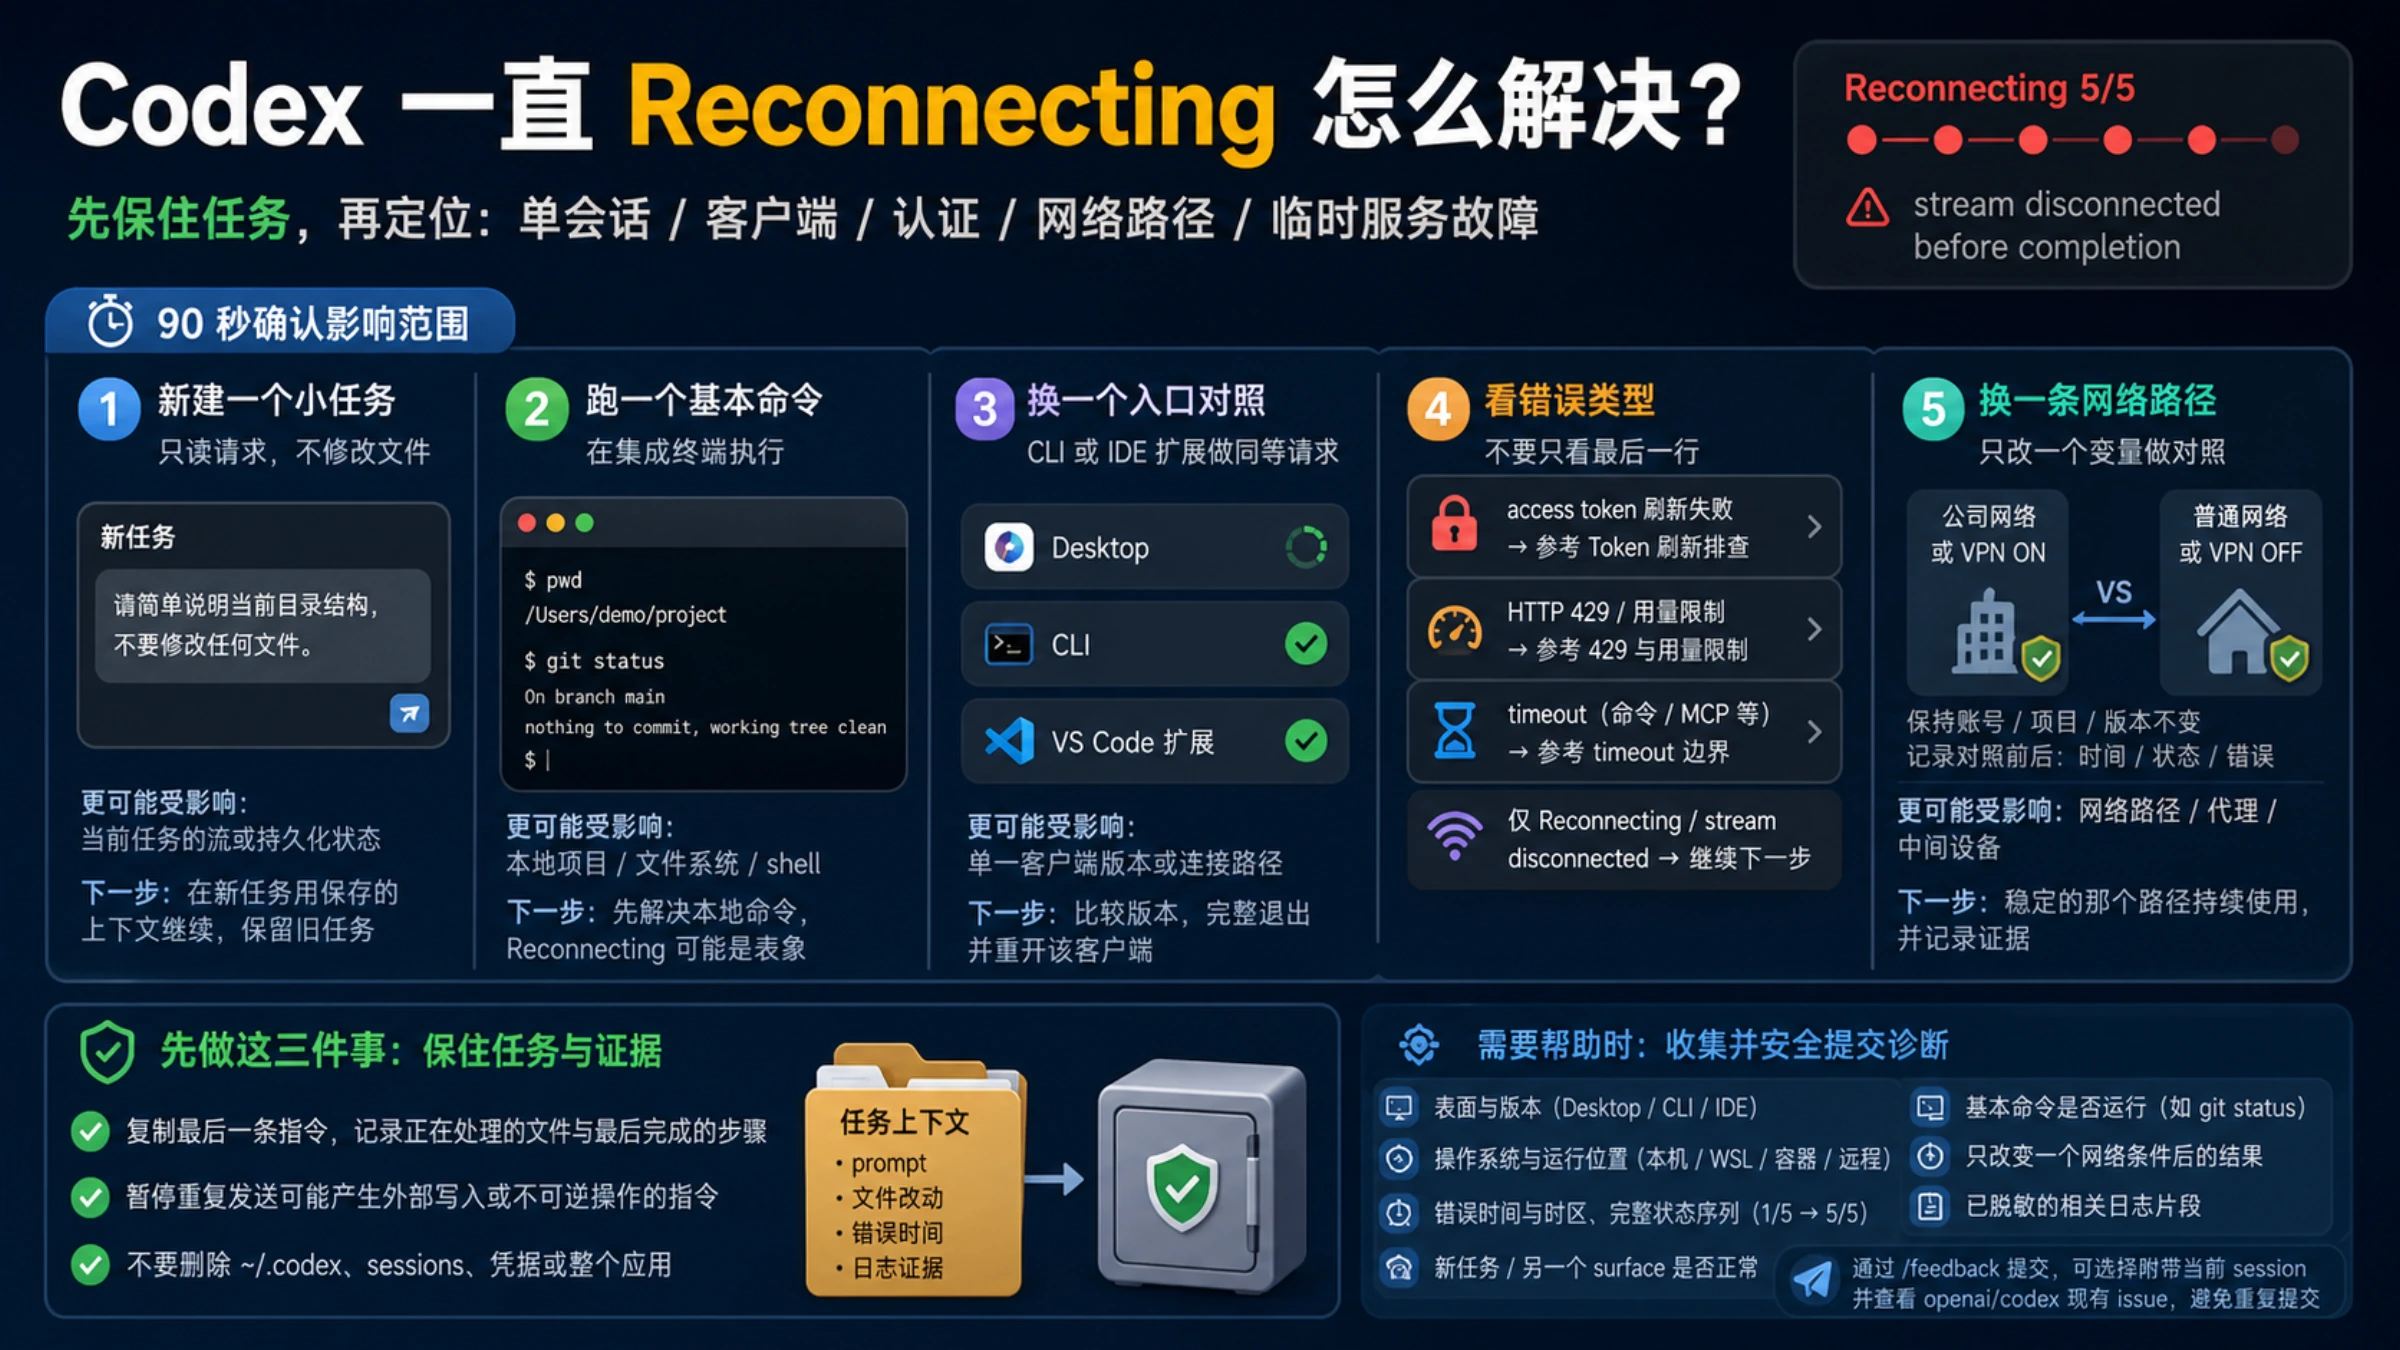
| 界面已经就绪,但一直 Connecting 或反复重连 | 客户端传输、代理/VPN、远程主机或服务路线 | 保持同一入口,只改变一条网络条件做对照 |
| MCP server 启动失败 | 本地进程、环境变量、远程 MCP URL 或认证 | codex mcp list 后检查该 server 实际运行的位置 |
| 只有一个 MCP tool 超时 | 工具执行、下游服务或输入规模 | 在同一 server 上调用最小只读操作 |
| shell 命令不退出 | watcher、stdin、打开的句柄或清理逻辑 | 在相同目录和环境单独观察命令 |
| 已经发出模型请求,随后 HTTP 429 | 用量窗口、项目、workspace 或 provider 限制 | 转到 Codex 429 排查 |
浏览器能打开 ChatGPT,只能证明浏览器自身的路线可用。Codex Desktop、终端、IDE extension host、Remote SSH、WSL 或容器可能使用不同代理、DNS、证书和防火墙规则。不要用“网页能开”代替对实际 Codex host 的判断。
五分钟内先做这些低风险检查
1. 留下可比较的启动现场
记录完整错误、发生时间和时区、使用的 Codex 入口、客户端版本、操作系统、登录类型,以及账号是否属于个人或受管 workspace。只记录身份类型,不复制 token、邮箱、组织内部名称、私有仓库内容或整份配置。
CLI 可以先运行:
bashcodex --version
codex --help
先看本机帮助,是因为命令和支持能力会随版本变化。不要从别人的截图推断自己的客户端一定有同一选项。
2. 看服务状态,但不要把它当唯一结论
检查 OpenAI Status 是否有正在进行的认证、ChatGPT 或 Codex 事件。若状态页明确显示相关故障,保留本地时间和错误后等待恢复,比反复重装更有价值。
状态页正常也不能排除账号、workspace、地区或网络路线问题。它是一个分诊信号,不是“你的这台机器一定没问题”的证明。
3. 只做一次网络对照
先确认失败发生在本地电脑、Remote SSH 主机、WSL 还是容器。然后保持账号、workspace、项目和客户端版本不变,只改变一个网络条件,例如暂时比较受管公司网络与经批准的普通路线,或确认代理是否同时提供 HTTPS 访问和必要的证书信任。
不要同时关闭 VPN、换 DNS、重装客户端和退出账号。一次改四项,即使成功也无法知道是哪项修复了问题;如果工作网络有明确策略,也不要为了绕过它擅自切换未经批准的路线,应把证据交给管理员。
4. 用 doctor 收集范围,不把它当最终裁决
当前官方开发者命令参考记录了:
bashcodex doctor --summary
它可以汇总安装、配置、认证、运行时、Git、终端和 app-server 等本地健康信息。支持该命令的版本还可用 --json 生成标为已脱敏的机器可读报告。分享前仍应自己检查输出,移除路径、账号、内部主机名和项目标识。
doctor 通过,不等于云端配置包一定可达;doctor 出现本地认证或运行时错误,则给出了比“再等 15 秒”更具体的下一条证据。
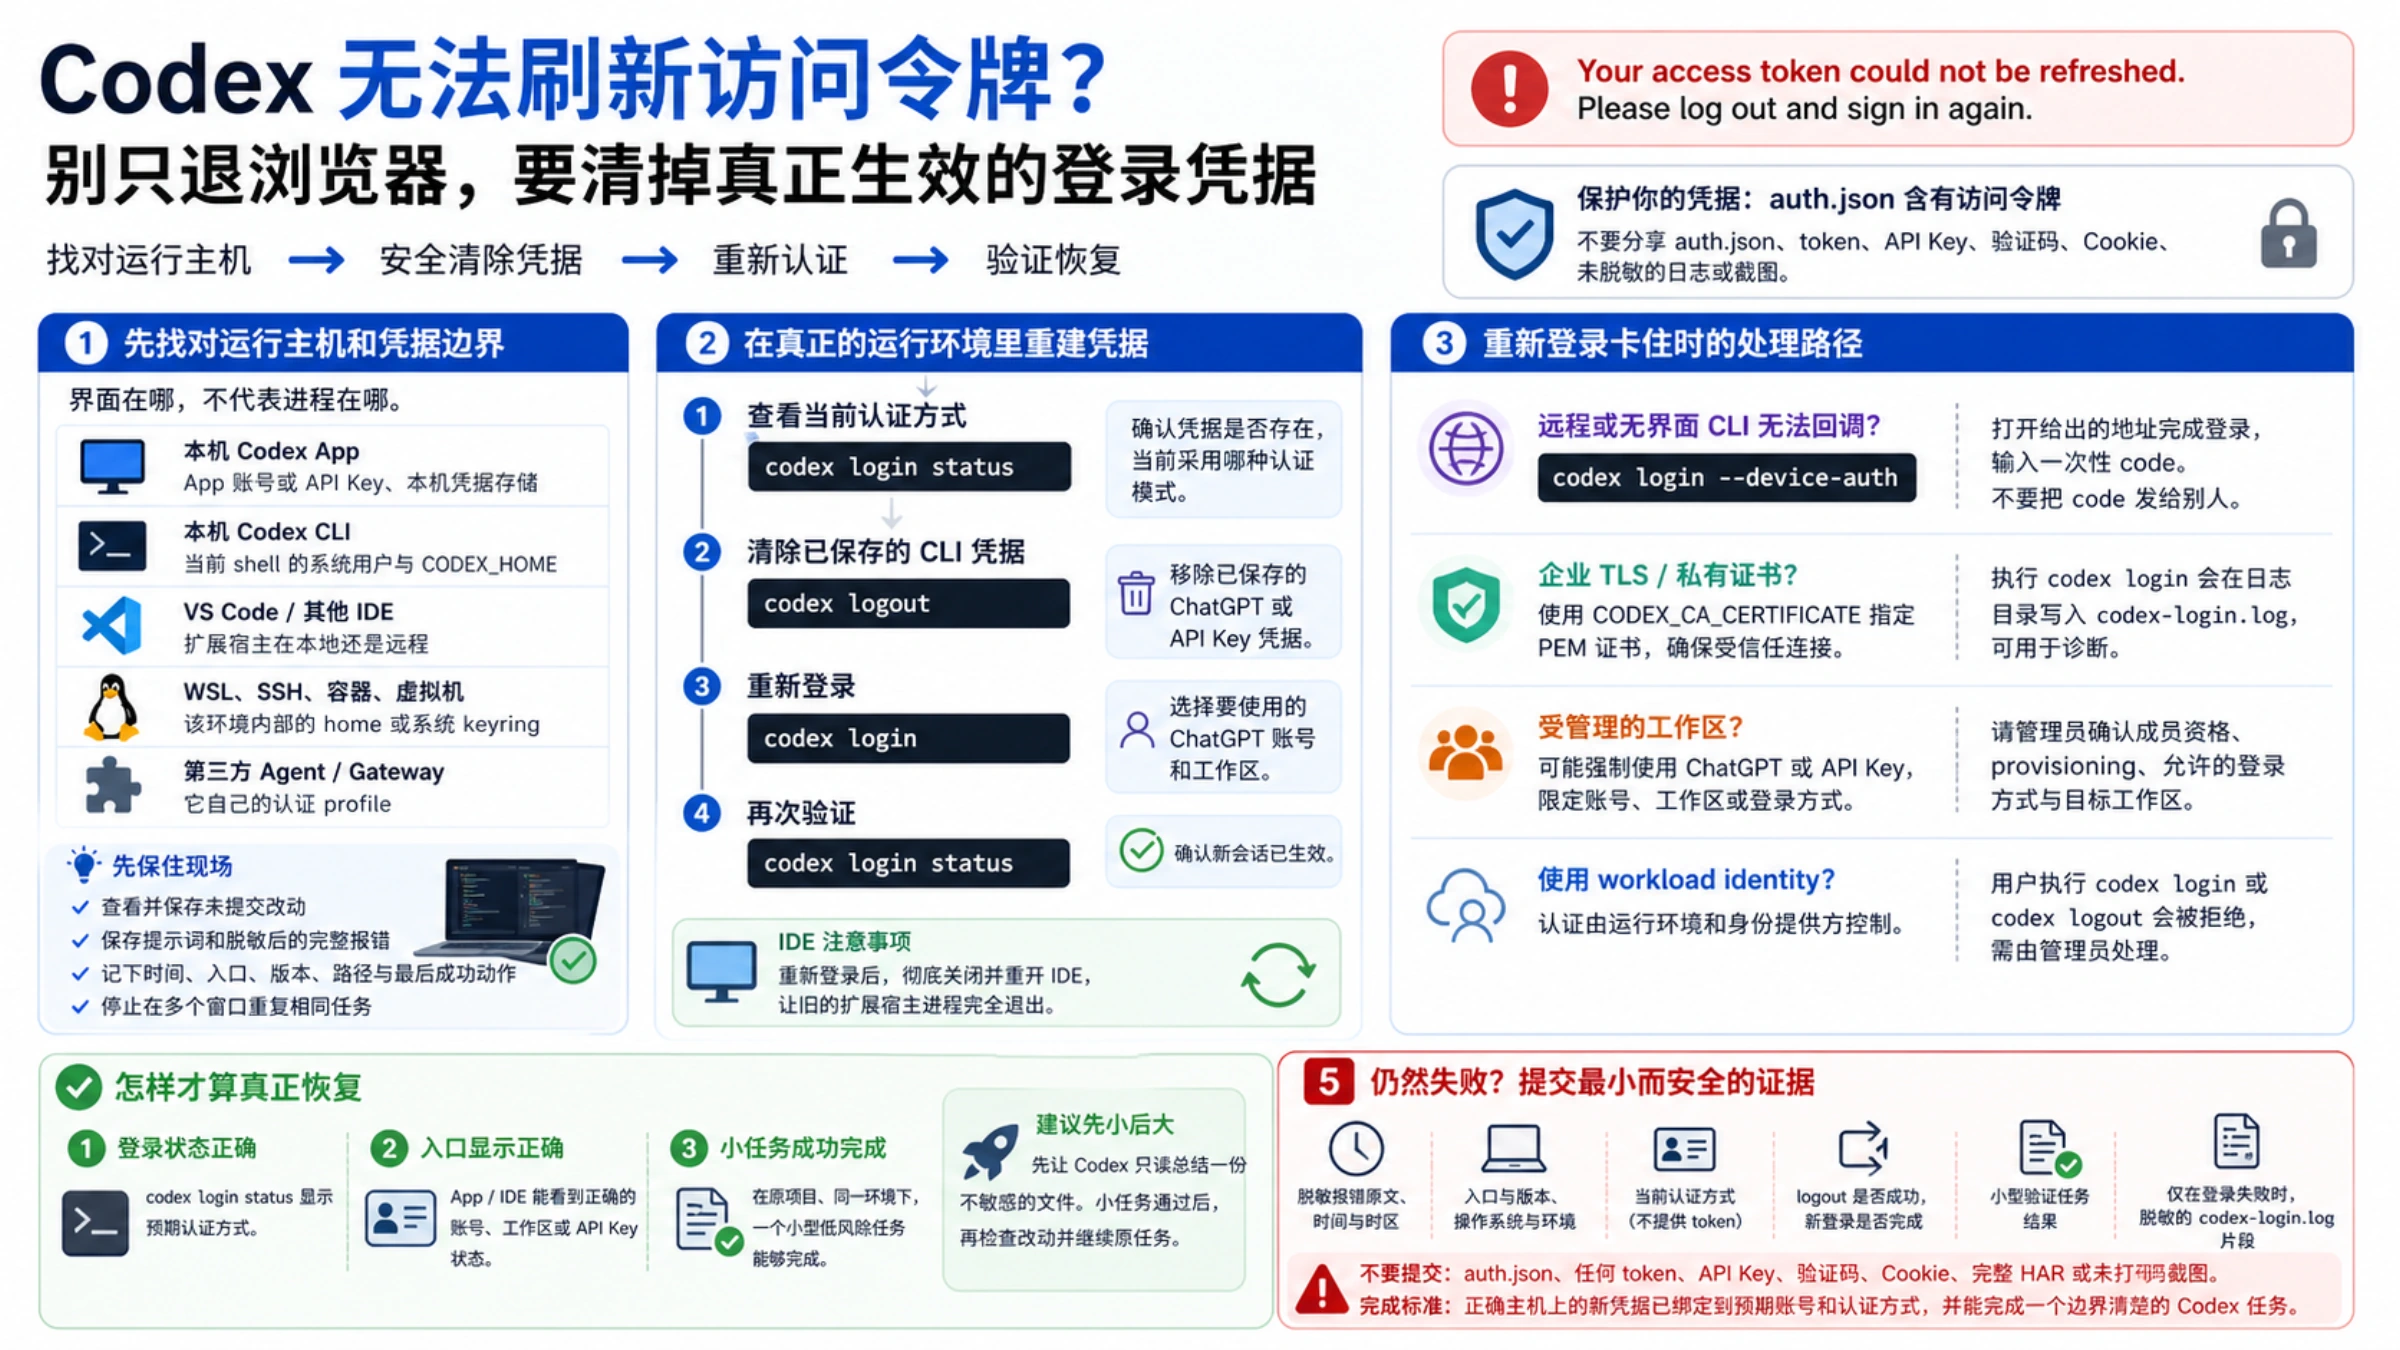
5. 认证只在证据指向它时处理
bashcodex login status
该命令只显示当前认证方式并在存在凭据时成功退出。它不验证云端配置请求能否及时完成,也不证明当前身份被分配到了正确 workspace。
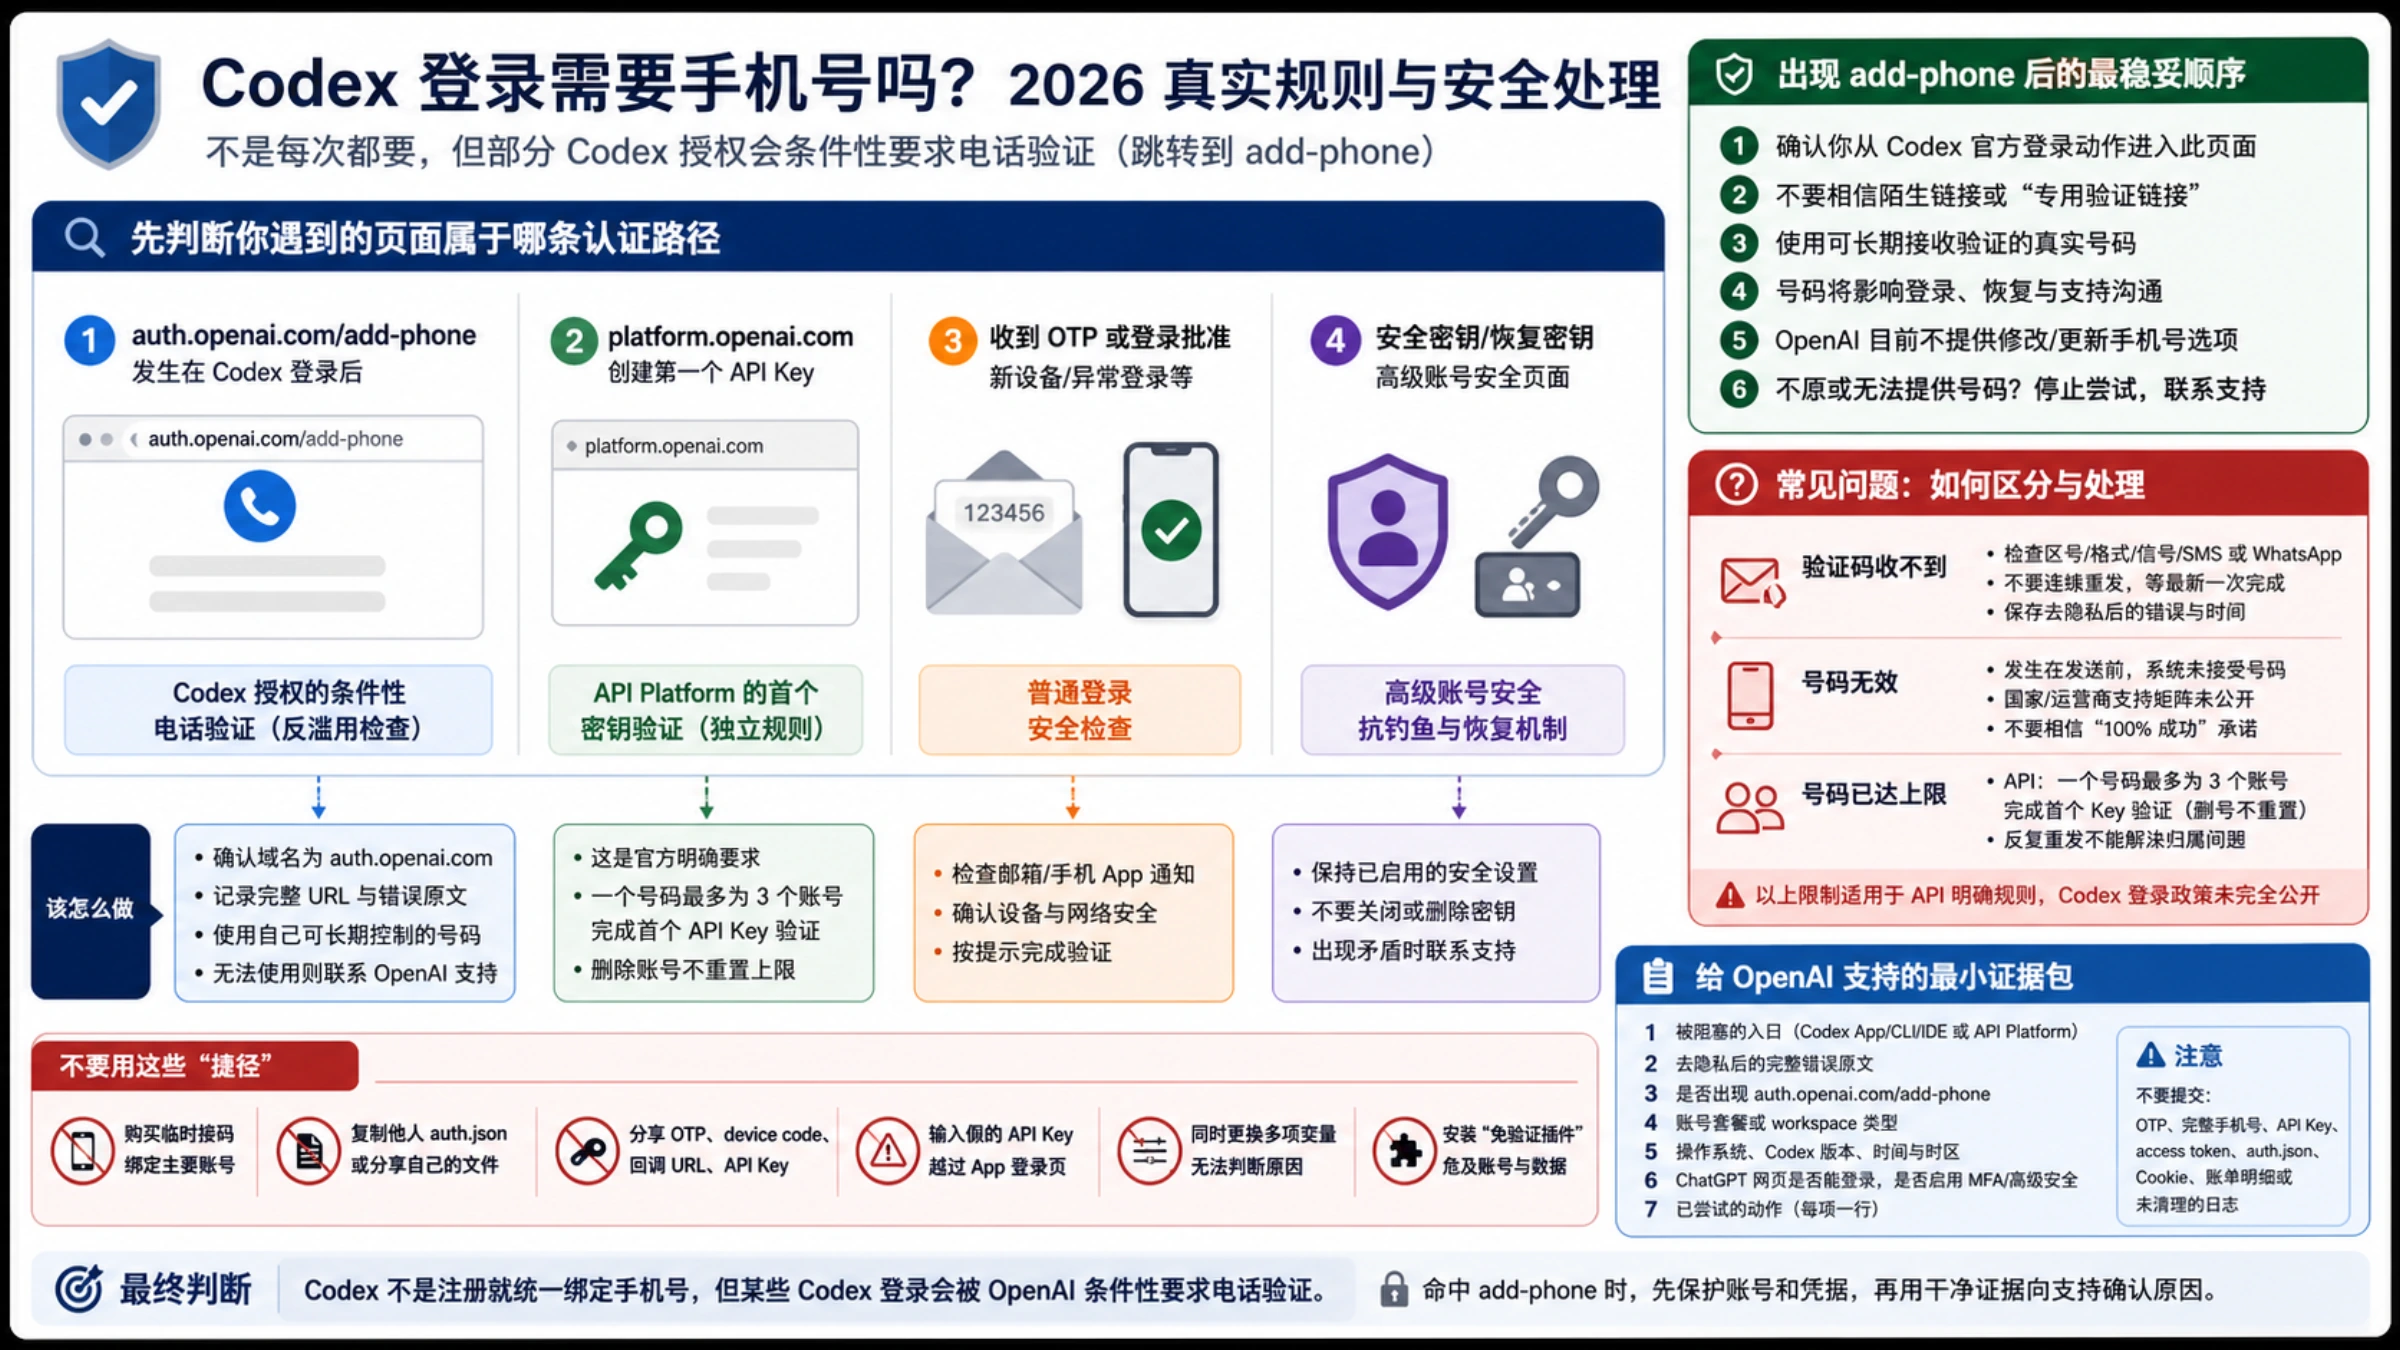
只有当错误同时明确出现 unauthorized、token refresh、账号已切换,或 login status 与预期身份不符时,才值得进入重新认证路径。codex logout 会删除保存的 ChatGPT 和 API key 凭据,不是通用的 timeout 刷新按钮。若屏幕显示的是 “Your access token could not be refreshed”,应使用单独的访问令牌恢复流程,不要把两类错误混在一起。
6. 受管 workspace 要让管理员验证分配
OpenAI 文档把云端配置包定义为企业托管 requirements 的交付层。它可以与系统 requirements.toml、旧 managed config 和 macOS MDM 要求一起合成;具体支持项还会随客户端与版本变化。普通用户修改 ~/.codex/config.toml 不能覆盖管理员强制要求,也不能证明云端分配正确。
如果只有某个受管账号或 workspace 失败,向管理员提供客户端版本、发生时间、入口、完整错误和一次网络对照结果。管理员应核对策略是否分配给正确用户/组、所用客户端版本是否支持策略中的字段,以及代表性允许/禁止流程是否符合预期,而不是要求用户继续删除本地状态。
为什么不应先删缓存或重写 config.toml
云端配置包的缓存不是普通“临时垃圾”。官方说明把它描述为经过签名、与身份匹配的启动输入;成功的后台刷新供后续启动使用。手动删除未知缓存,可能把“还能用旧的有效策略启动”变成“每次启动都必须远端成功”。公开文档没有提供一个通用缓存路径,也没有把删缓存列为标准恢复步骤。
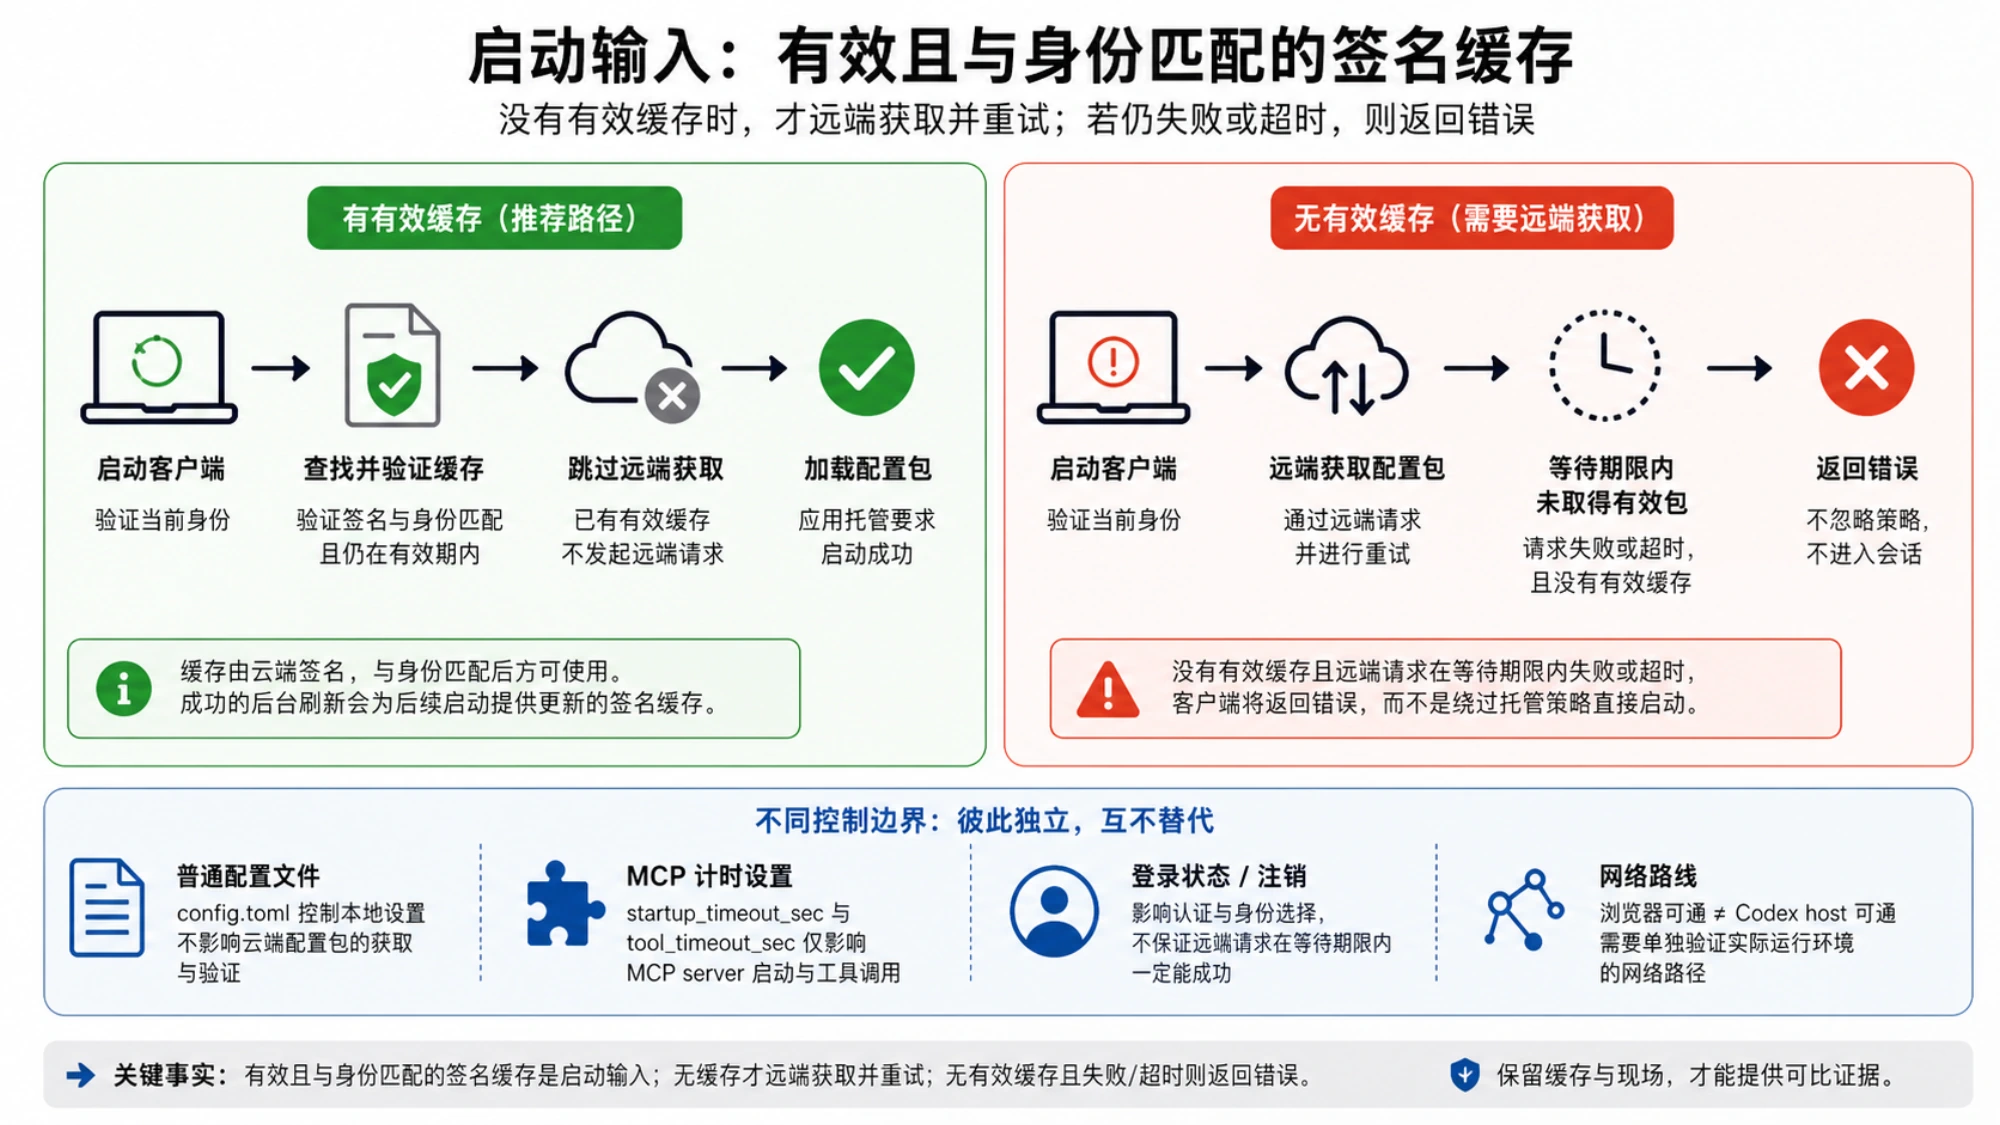
本地 config.toml 属于另一条配置链。Codex 会按 CLI override、受信任项目、profile、用户、系统和内置默认值解析普通设置;详细顺序见配置优先级。如果错误是 unknown field、TOML parse 或某个值在一个项目里被覆盖,才应转到 Codex 沙箱与 config.toml 指南。
同理,MCP 的 startup_timeout_sec 和 tool_timeout_sec 只控制 MCP server 启动与单次工具调用。把它们调大不会改变 cloud config bundle 的启动等待,也不会修复托管策略的认证或网络路线。
让下一次启动真正提供新证据
完成上述分诊后,只改变一个有依据的条件:等待官方事件恢复、使用管理员批准的正确网络路线、更新到已支持的客户端版本、修复明确的认证状态,或由管理员纠正 workspace 策略分配。然后用同一账号、同一项目和同一入口启动一次,并记录新的最后进展点。
如果成功,确认进入会话后实际生效的权限和 workspace 行为符合预期,再逐步恢复原网络或工作环境。如果仍在同一 15 秒边界失败,停止随机修改,把以下最小信息交给管理员或支持:
- exact error 与本地时间/时区;
- Codex surface、版本和操作系统;
- 个人账号还是受管 workspace,不含敏感身份信息;
- 实际运行 Codex 的 host 与网络类型;
- OpenAI status 当时是否有相关事件;
- 一次单变量对照及其结果;
codex doctor --summary中与安装、认证、配置或运行时直接相关的已脱敏行。
可观察的恢复标准不是“这次多等了一会儿”,而是客户端完成配置加载、进入正常会话,并且受管权限与预期一致。若最后进展已经越过配置加载,后续 timeout 就应按新的实际边界排查,而不是继续清理云端配置状态。