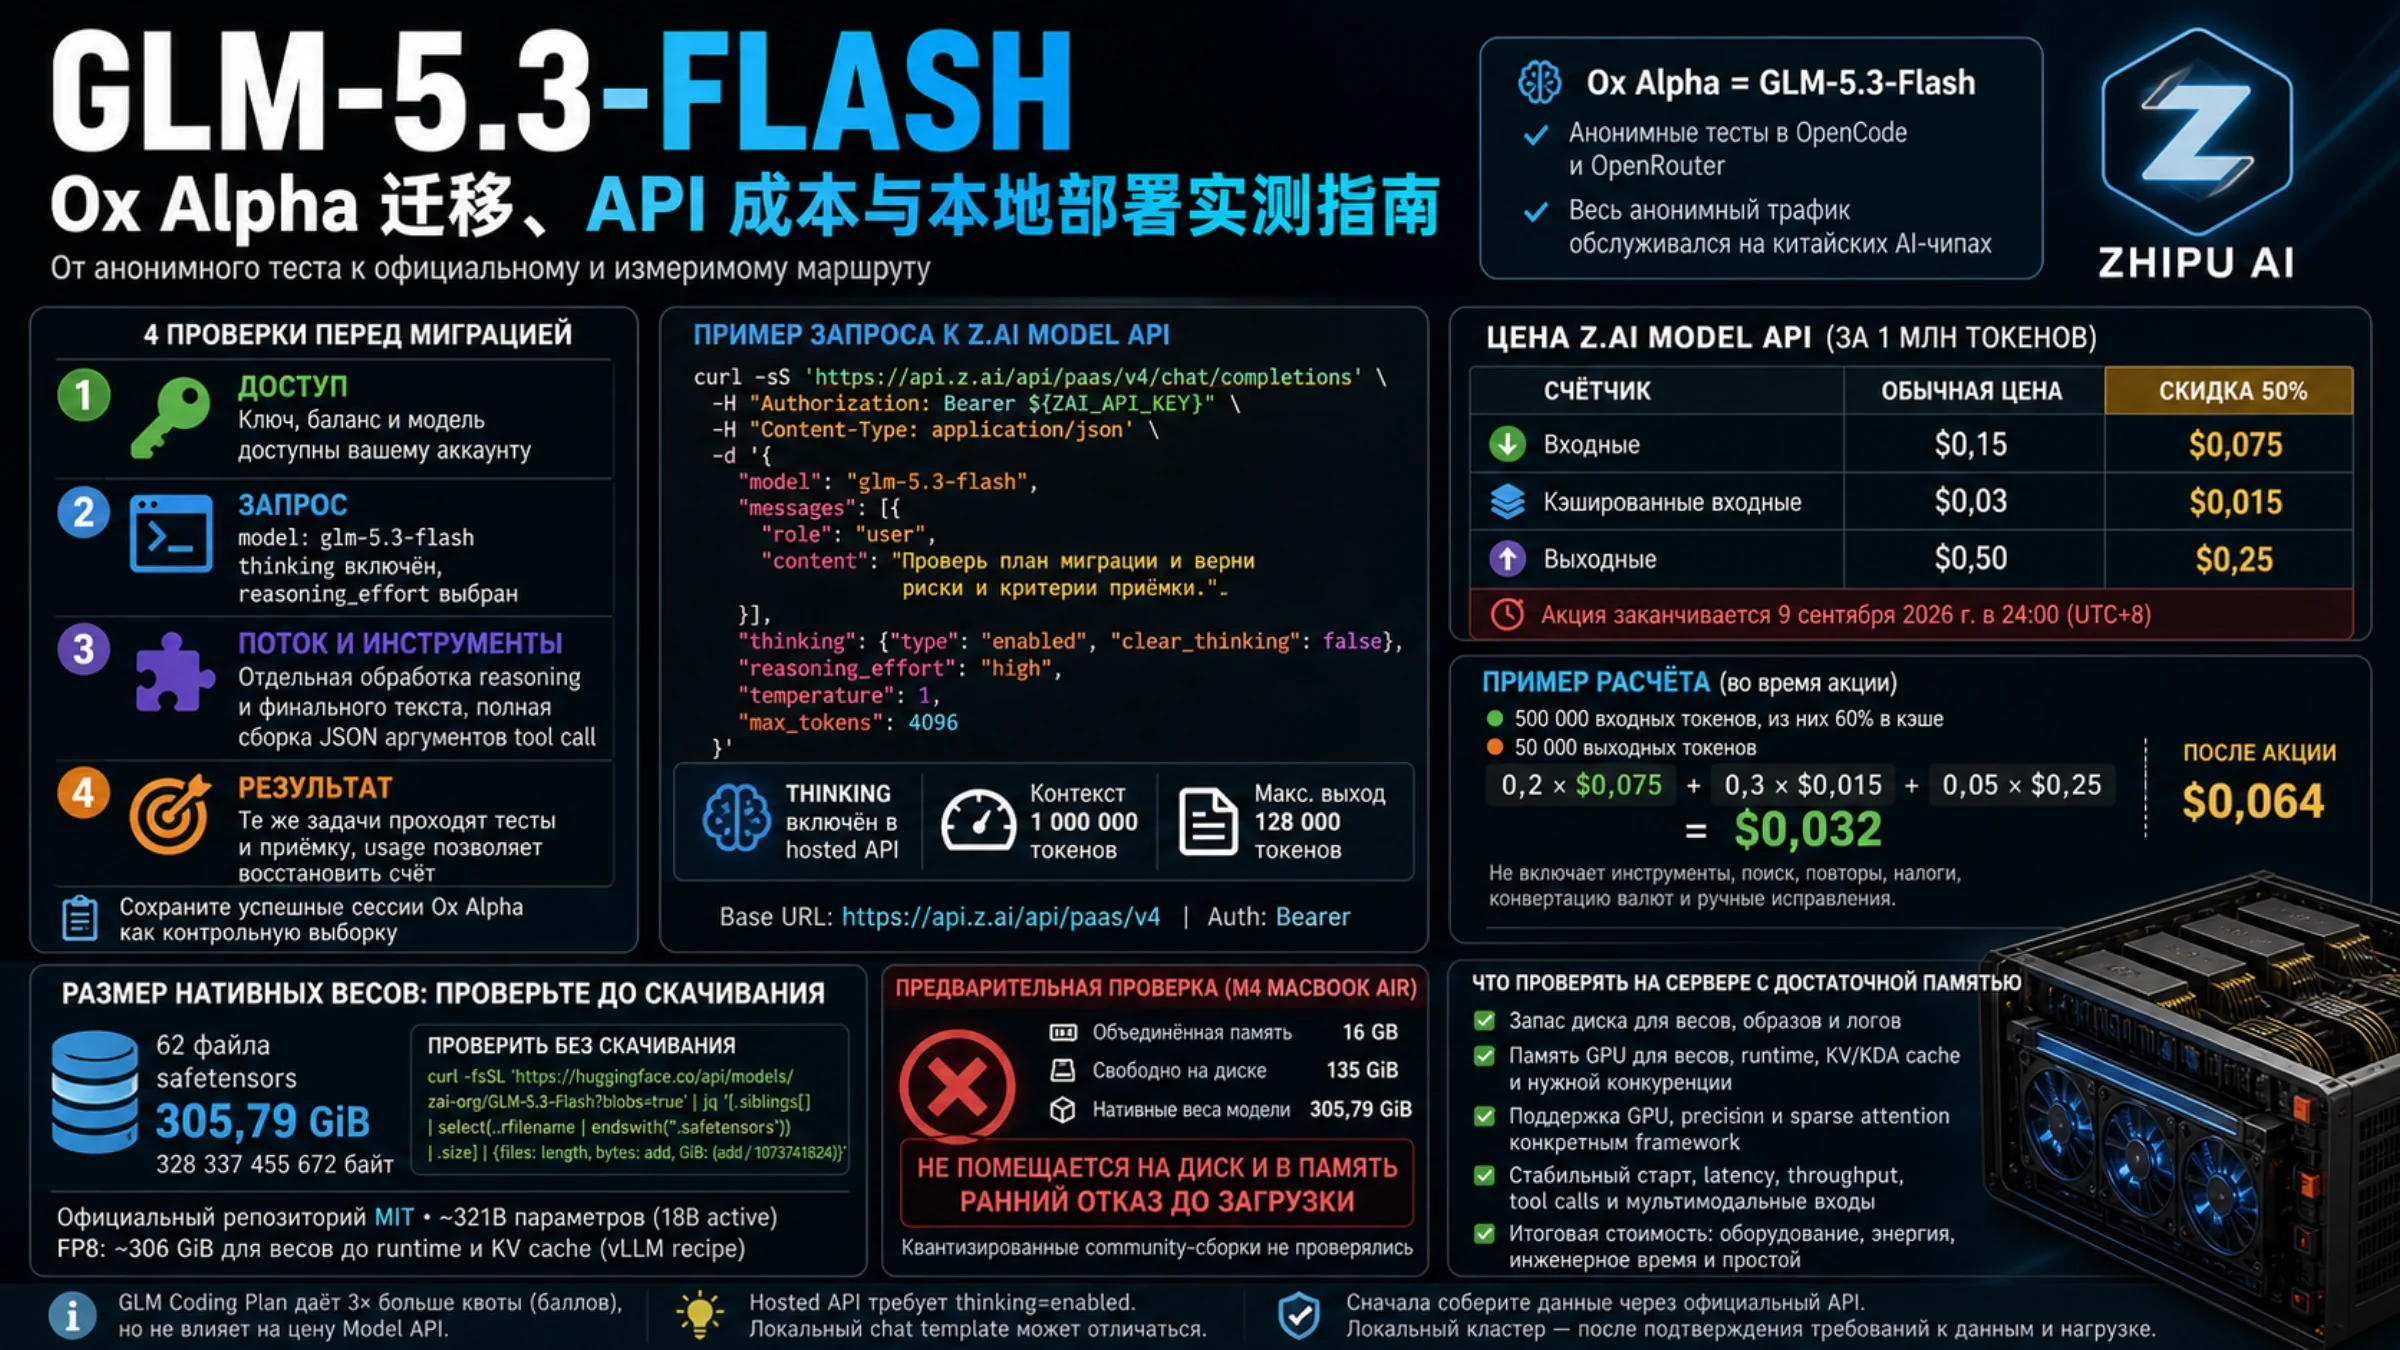
Zhipu AI официально подтвердила: модель, которую до релиза анонимно тестировали как Ox-Alpha в OpenCode и OpenRouter, — это GLM-5.3-Flash. Подтверждение опубликовано в сообщении о релизе от 26 августа 2026 года. Для постоянной интеграции используется идентификатор glm-5.3-flash.
Но из совпадения модели не следует совпадение сервиса. Старый адрес API, бесплатный период, лимит, кэш и формат событий могли принадлежать конкретному провайдеру. Поэтому при миграции нужно проверить правила нового API, а не только строку model.
Для разработчика из России есть ещё один предварительный вопрос: доступен ли официальный аккаунт, пополнение и нужный API именно сейчас. Документация Z.AI описывает глобальную платформу, но не обещает отдельный российский способ оплаты или гарантированный региональный маршрут. Сначала проверьте это в собственном аккаунте; рекламные страницы сторонних сервисов не являются доказательством официальной доступности.
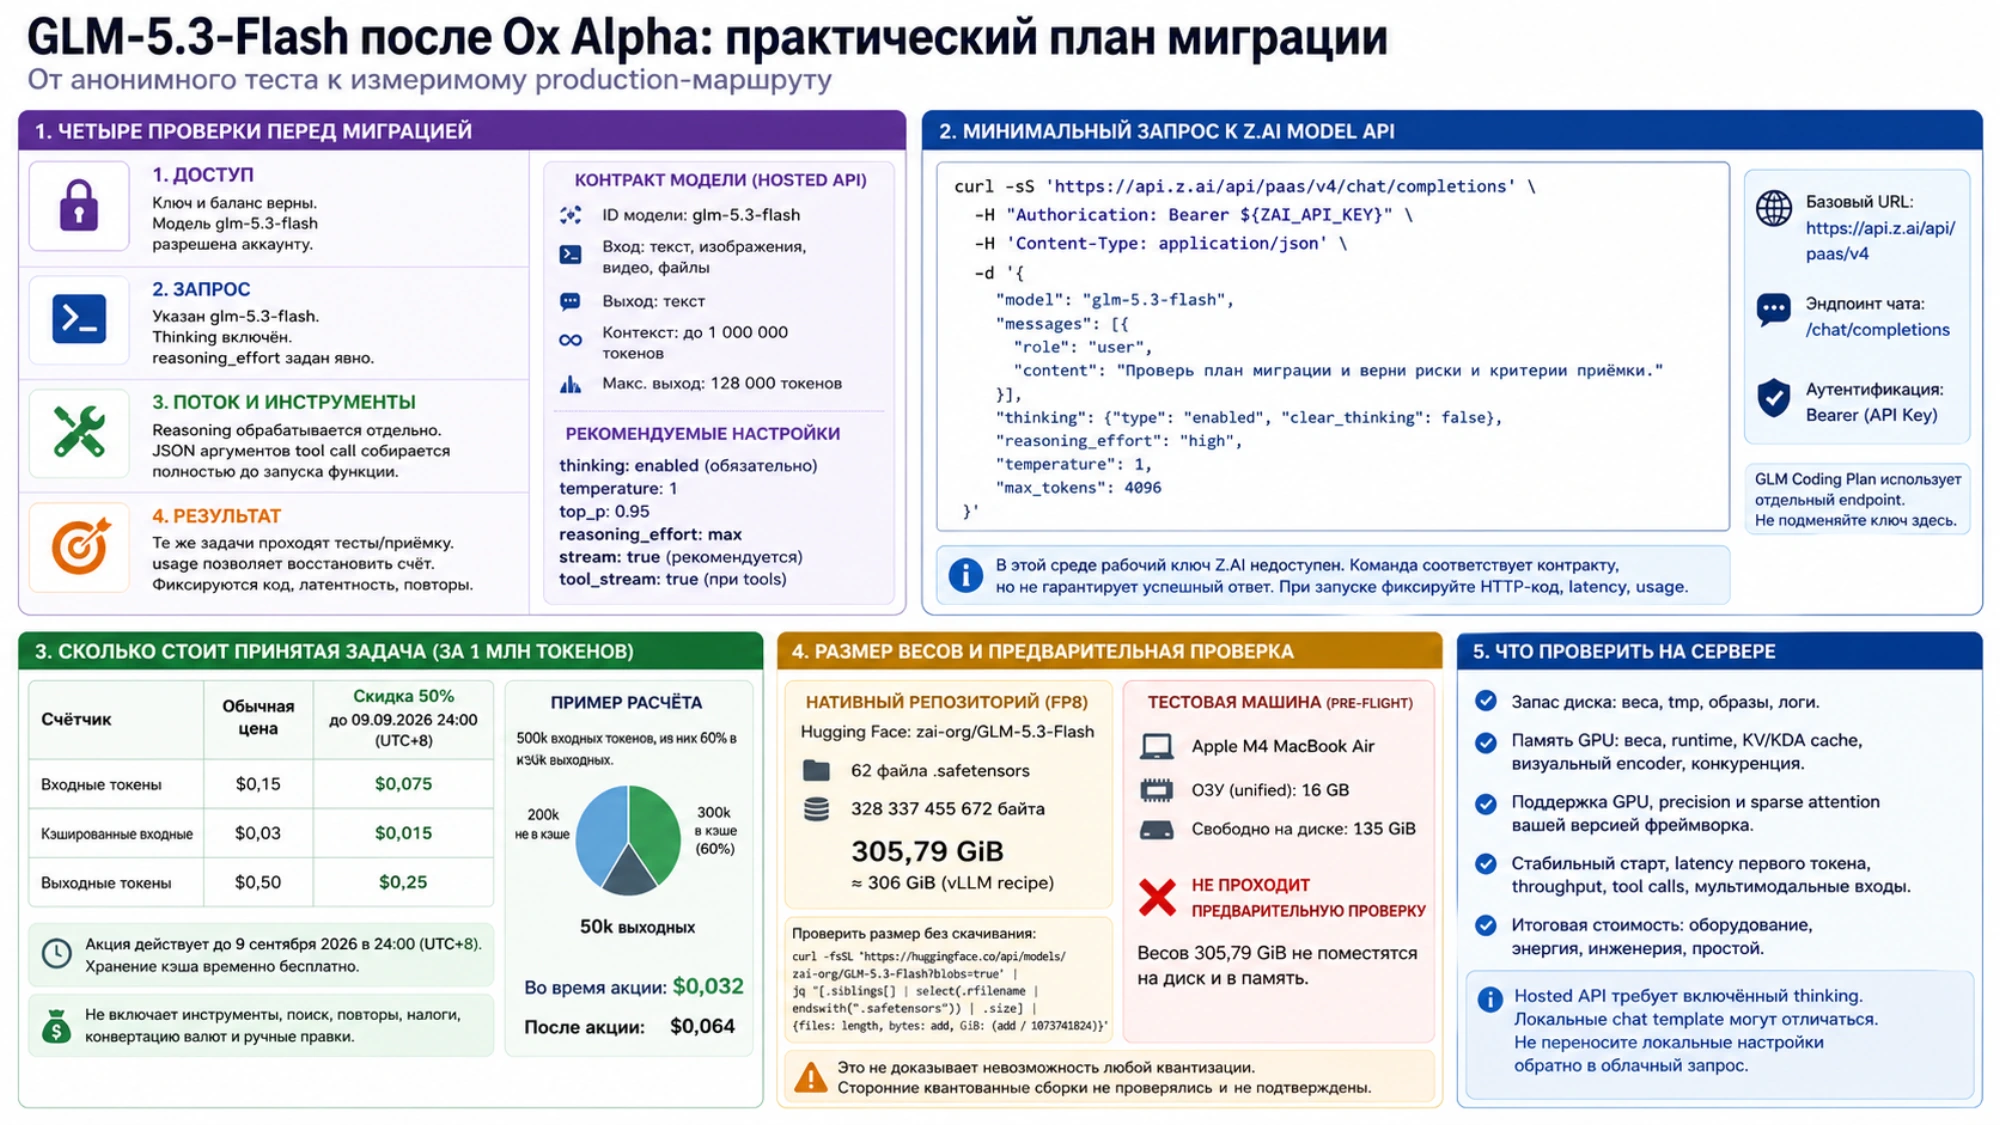
Четыре проверки вместо простого переименования
Сохраните несколько успешно завершённых сессий Ox Alpha: вход, разрешённые инструменты, таймаут, число шагов, артефакты и критерий приёмки. Они станут контрольной выборкой для нового подключения.
Затем проверьте четыре уровня:
- Доступ. Ключ и баланс относятся к нужной платформе, а модель действительно разрешена аккаунту.
- Запрос. Указан
glm-5.3-flash; рассуждения включены; параметрreasoning_effortвыбран явно. - Поток и инструменты. Клиент отдельно обрабатывает рассуждения и финальный текст, а JSON аргументов вызова инструмента собирается полностью до запуска функции.
- Результат. Те же задачи проходят машинные тесты или бизнес-приёмку, а usage позволяет восстановить счёт.
В официальном описании модели указаны текст, изображения, видео и файлы на входе, текст на выходе, контекст до 1M и максимум 128K выходных токенов. В размещённом у Z.AI API рассуждения отключить нельзя; рекомендуются temperature: 1, top_p: 0.95 и reasoning_effort: max.
Для примера заранее задайте ключ в переменной окружения ZAI_API_KEY. Следующий запрос к обычному Model API использует рекомендованный reasoning_effort: "max"; max_tokens: 4096 — ограничение примера, а не максимум модели:
curl -sS 'https://api.z.ai/api/paas/v4/chat/completions' \
  -H "Authorization: Bearer ${ZAI_API_KEY}" \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "glm-5.3-flash",
    "messages": [{
      "role": "user",
      "content": "Проверь план миграции: заменить модель сразу во всех запросах без сравнительных тестов и без сохранения прежней конфигурации. Назови риски и предложи критерии приёмки."
    }],
    "thinking": {"type": "enabled", "clear_thinking": false},
    "reasoning_effort": "max",
    "temperature": 1,
    "top_p": 0.95,
    "max_tokens": 4096
  }'
Базовый адрес указан в справочнике Z.AI API. У GLM Coding Plan отдельный адрес API, поэтому подписку нельзя подключать к этому примеру простой заменой ключа. Пример составлен по документации; запрос к платному API для этой статьи не выполнялся. При своём запуске фиксируйте код HTTP, задержку, usage, повторы, завершение цикла вызовов инструментов и итог приёмки.
Сколько стоит принятая задача
На 12 сентября 2026 года официальный прайс указывает следующие ставки в долларах США:
| Вид токенов, за 1 млн | Цена |
|---|---|
| Вход без кэша | $0,15 |
| Кэшированный вход | $0,03 |
| Выход | $0,50 |
Прежняя скидка 50% уже закончилась; в текущий расчёт она не входит. Хранение кэша пока помечено как временно бесплатное — срок этого условия проверяйте отдельно.
Условный пример: задача использовала 500 000 входных токенов, из них 60% попали в кэш, и 50 000 выходных. Кэшированная часть уже входит в общий вход, поэтому обычную ставку применяем к оставшимся 200 000 токенов:
0,2 × $0,15 + 0,3 × $0,03 + 0,05 × $0,50 = $0,064.
Это расчёт по заданному расходу, а не результат измерения модели. В сумму не входят платные инструменты, поиск, повторы, налоги, конвертацию валют и ручные исправления. Сравнивайте полные расходы на одну принятую задачу, а не только цену миллиона входных токенов.
Почему 18 миллиардов активных параметров не означают 18 ГБ памяти
GLM-5.3-Flash — MoE-модель с 320B общих и 18B активных параметров. На каждом токене вычисляется часть экспертов, но хранить нужно полный набор весов.
Официальный репозиторий Hugging Face опубликован по лицензии MIT. Размер загрузки зависит от выбранной ревизии и формата весов. Перед скачиванием сложите размеры всех нужных файлов, затем отдельно учтите память среды выполнения и KV-кэша. Требования к запуску приведены в инструкции vLLM.
Размер можно получить без скачивания модели:
curl -fsSL \
  'https://huggingface.co/api/models/zai-org/GLM-5.3-Flash?blobs=true' |
jq '[.siblings[]
  | select(.rfilename | endswith(".safetensors"))
  | .size]
  | {files: length, bytes: add, GiB: (add / 1073741824)}'
Сравните результат команды со свободным местом на своём диске. Для памяти одного размера файлов недостаточно: формат весов, вычислительные буферы, контекст и число одновременных запросов меняют требования. Если ресурсов не хватает уже на веса, остановитесь до загрузки. Эта проверка не измеряет скорость генерации.
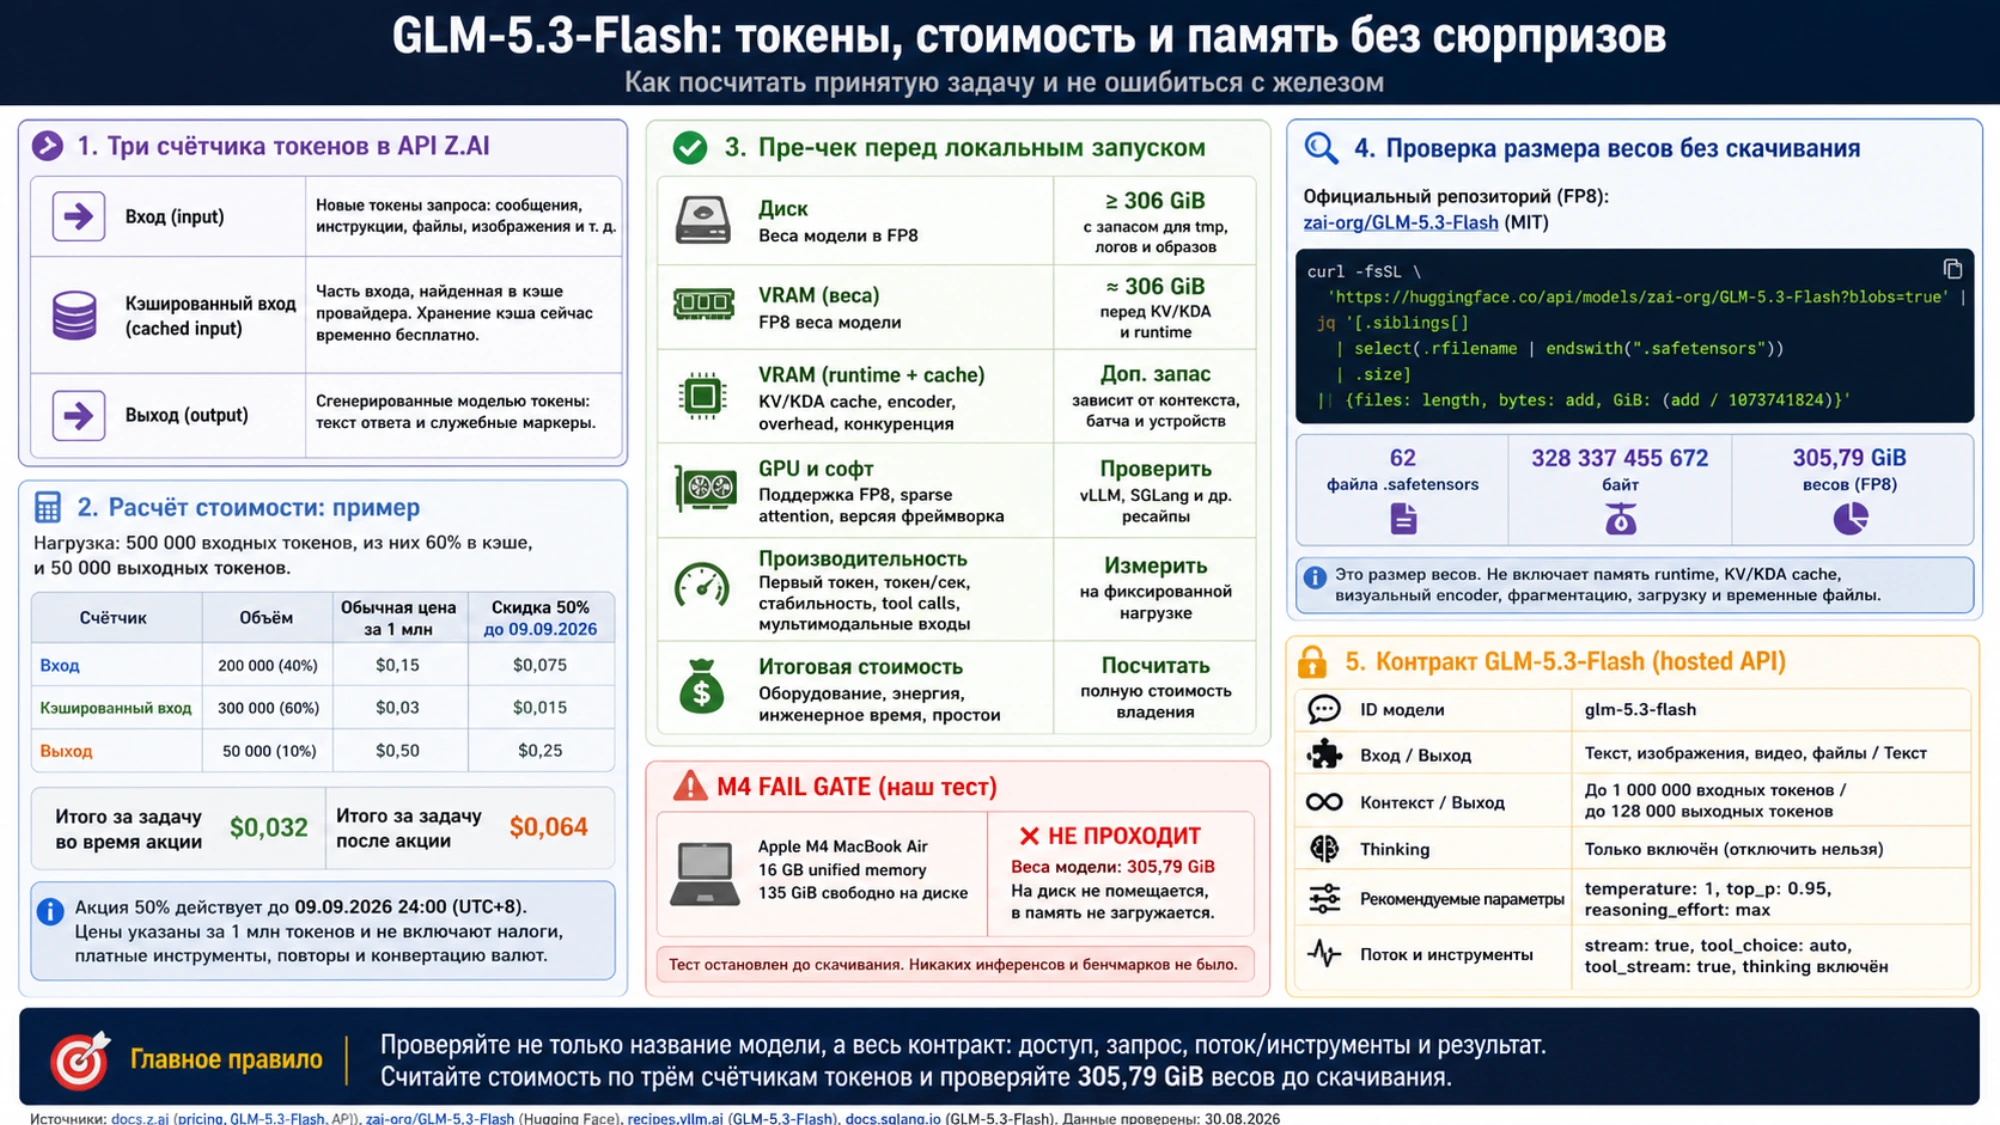
Нехватка ресурсов для исходных весов не исключает все сторонние квантованные сборки. Их качество, совместимость и требования к памяти нужно проверять отдельно; результаты официальной модели автоматически на них не переносятся.
Что проверять на сервере с достаточной памятью
В официальной карточке перечислены SGLang, vLLM, TokenSpeed, Transformers, KTransformers и Unsloth. Их поддержка железа различается. vLLM приводит многокарточные конфигурации, включая TP4 на GB200. Руководство SGLang отдельно настраивает пулы памяти KV и KDA и помечает часть аппаратных комбинаций как непроверенные.
До запуска подтвердите:
- запас диска для весов, временных файлов, образов и логов;
- память ускорителей для весов, среды выполнения, KV/KDA-кэша, визуального кодировщика и нужного числа одновременных запросов;
- поддержку GPU, выбранной точности и разреженного внимания конкретной версией движка;
- стабильный старт, время до первого токена, пропускную способность, вызовы инструментов и мультимодальные входы на фиксированной нагрузке;
- итоговую стоимость с учётом оборудования, энергии, инженерного времени и простоя.
API Z.AI требует включённых рассуждений, а локальный шаблон диалога может поддерживать другие настройки. Проверяйте инструкцию выбранного движка: локальное поведение нельзя переносить в облачный запрос.
Если задача — быстро оценить качество и цену, сначала соберите данные через официальный API. Локальный кластер имеет смысл после того, как требования к данным или устойчивая загрузка оправдают многокарточную инфраструктуру. Для отдельного выбора между провайдерами есть русское сравнение GLM-5.3 и DeepSeek V4 Pro; здесь критерий другой — воспроизводимый переход от анонимного теста к документированному подключению с проверенными результатами.