2026년 10월 6일(미국 시간)부터 OpenAI Decisions API는 일반 개발자가 쓸 수 있는 공개 베타입니다. OpenAI API 변경 이력에는 같은 날 "Decisions API를 gpt-6-luna로 베타 출시했다"는 항목이 올라왔고, Decisions 가이드는 "앞으로 몇 주 안에 GA(정식 출시)할 예정"이라고 적고 있습니다. 9월 29일 DevDay부터 10월 6일 전까지는 선정된 고객만 쓰는 제한적 프리뷰였기 때문에, 그 기간의 "문서·가격 없음"이나 403 오류 이야기는 지금 상태와 맞지 않습니다.
지금 바로 확인할 사실은 세 가지입니다.
- 호출 방법: 전용 엔드포인트
POST /v1/decisions, 지원 모델은gpt-6-luna하나입니다. SDK에서는client.decisions.create(...)를 쓰며 Python 3.26.0, JavaScript 7.30.0 이상이 필요합니다. 코드 없이 Playground에서 먼저 시험할 수도 있습니다. - 가격: 입력 100만 토큰당 $0.10만 청구되고 출력·캐시 읽기·캐시 쓰기 요금은 없습니다. 대신 캐시 할인도 없어서 모든 입력 토큰이 같은 단가입니다.
- 한국에서: 한국은 OpenAI API 지원 국가이므로 OpenAI 계정과 API 키로 직접 호출하면 됩니다.
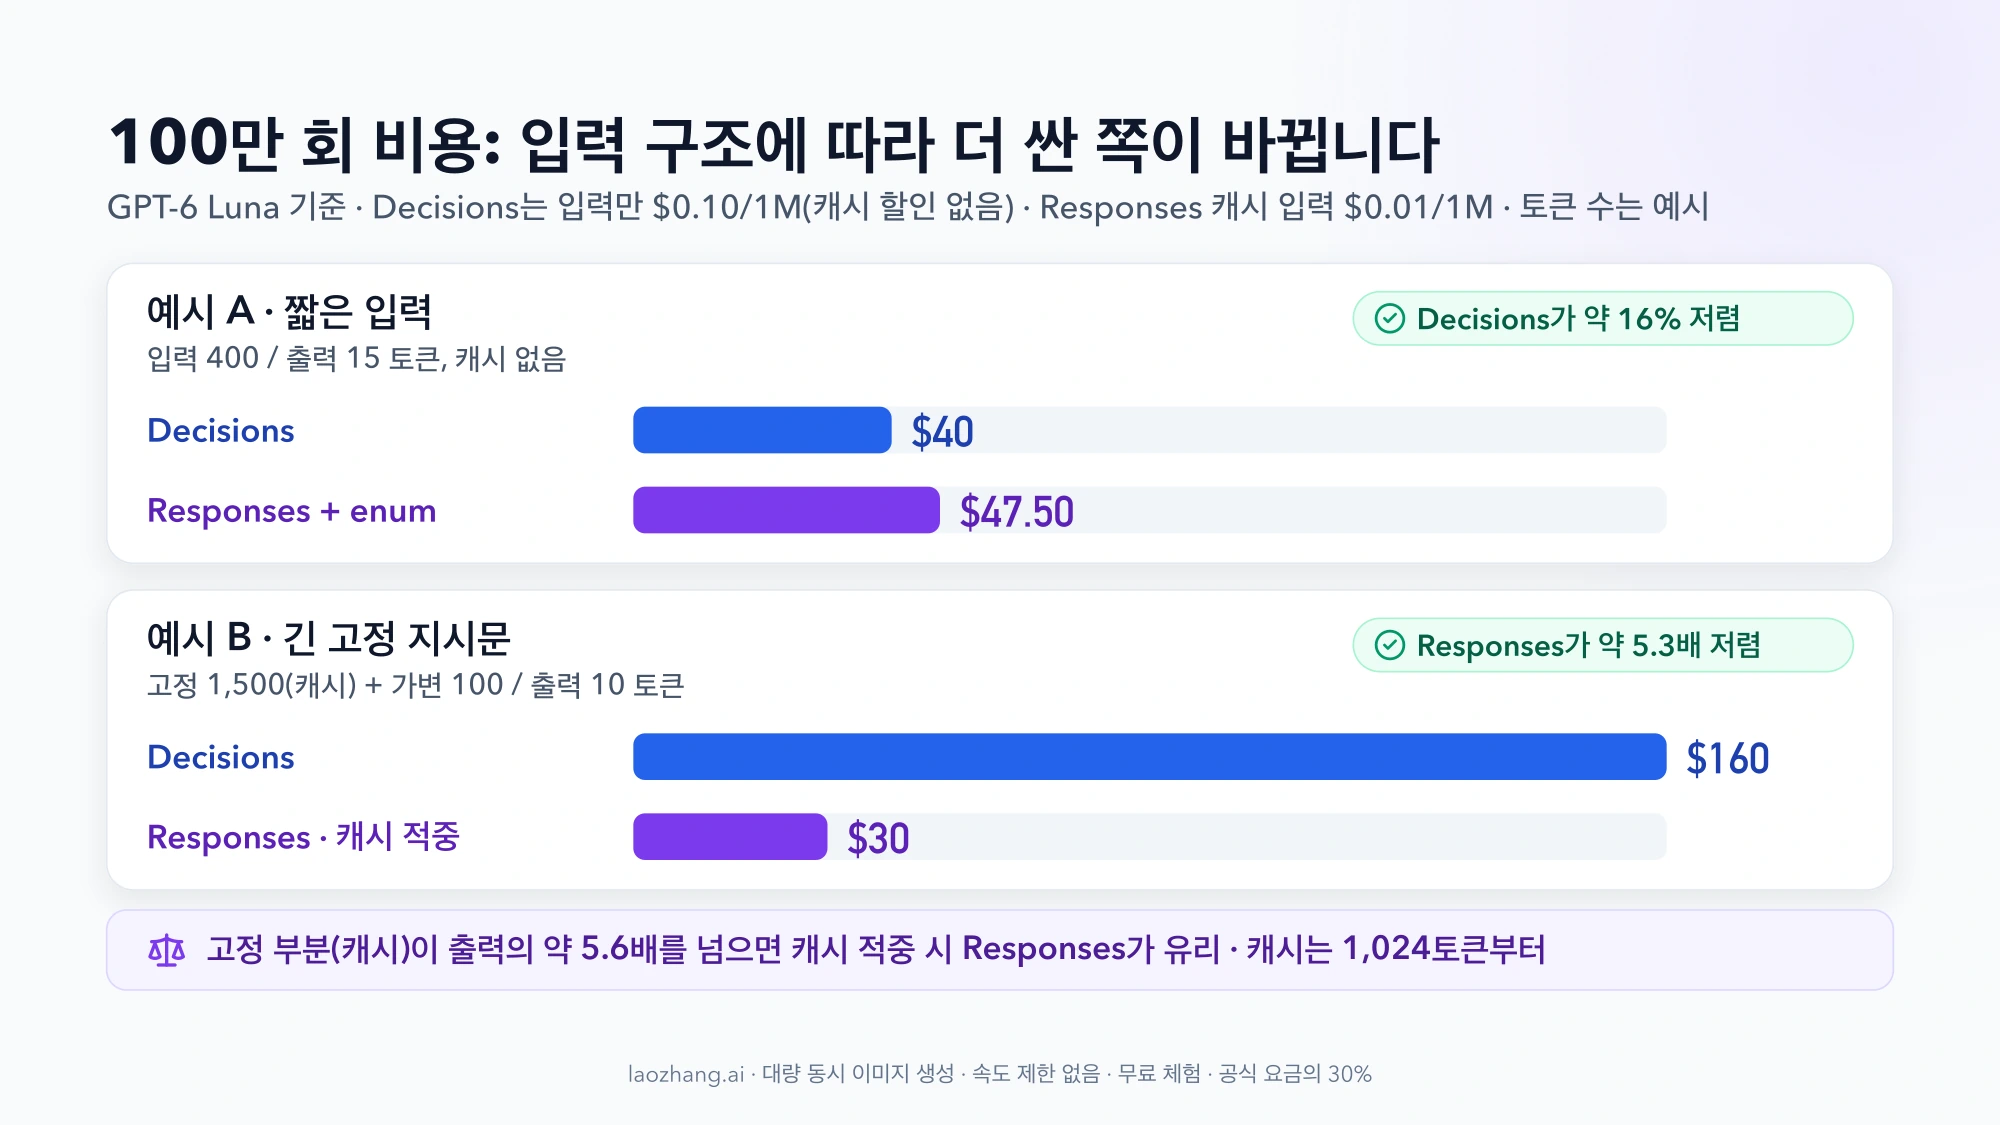
비용으로 보면 갈림길은 입력 구조입니다. 입력 400토큰짜리 짧은 분류라면 Decisions는 100만 회에 $40로, 같은 일을 GPT-6 Luna의 Responses API와 enum 스키마로 할 때($47.50)보다 싸고 확률까지 돌려줍니다. 반대로 1,500토큰짜리 고정 지시문을 매번 붙이고 프롬프트 캐시가 적중하는 구조라면 Responses가 100만 회 $30, Decisions가 $160입니다. 두 경우의 토큰 수는 설명을 위한 가정이므로, 이미 Luna + enum 구현을 운영 중이라면 아래 계산식에 자기 서비스의 평균 토큰 수를 넣어 본 뒤 옮길지 정하세요.
Decisions API가 하는 일: 미리 정한 선택지 중 하나를 고르는 결정 모델
Decisions API는 글을 생성하지 않습니다. 텍스트나 이미지를 받아, 개발자가 미리 정한 질문에 정해진 형태의 답만 돌려주는 엔드포인트입니다. 요청은 평가할 모델(model), 모든 질문이 공유하는 입력(input), 질문 목록(questions) 세 부분으로 이루어지고, 응답의 answers 배열에 질문 순서대로 답이 담깁니다. 질문 유형은 세 가지입니다.
| 질문 유형 | 이런 판단에 씁니다 | 돌려받는 값 |
|---|---|---|
조건 판정(predicate) | 사진에 파손이 보이는가, 문서가 질의와 관련 있는가 | probability: 조건이 참일 확률 추정치(0~1) |
선택(choice) | 담당 부서, 콘텐츠 분류처럼 순서 없는 범주 | choice(개발자가 준 값 중 하나), 선택지별 probabilities, confidence |
점수(score) | 장애 심각도, 우선순위처럼 순서 있는 단계 | score(0부터 시작하는 단계 번호의 확률 가중평균), probabilities, confidence |
용도는 문의 분류, 요청 라우팅, 작업 우선순위 정하기입니다. OpenAI는 Live API와 연결해 음성 명령에서 "뒤로 가기 / 새로고침 / 아무것도 안 함" 같은 행동을 고르는 예시도 문서로 내놓았습니다.
반대로 Decisions가 맞지 않는 일도 가이드에 분명히 적혀 있습니다. 추출한 필드나 설명 문장처럼 직접 정의한 JSON 객체가 필요하면 Responses API의 Structured Outputs를, 모델이 도구를 호출해야 하면 function calling을 쓰라는 것입니다.
속도는 OpenAI가 "Responses API보다 약 10배 빠르다"고 밝혔지만 측정 조건은 공개하지 않았습니다. 제3자 측정은 다음과 같습니다. 일본 classmethod가 공식 예제를 curl로 5회씩 호출한 테스트에서 중앙값은 256~273ms였고, OpenAI 개발자 커뮤니티의 한 사용자는 이미지 입력 시 약 0.8초(약 3Mbps 회선)가 걸렸다고 보고했습니다. 프리뷰 기간에 고객 지원 자동화 업체 eesel이 잰 Luna + enum 우회 구현은 추론 none 기준 중앙값 1.46초였습니다. 측정 장소와 조건이 모두 다르므로 지연 시간 목표는 자기 서버 위치에서 p50·p95를 다시 재서 정해야 합니다. 보도에 나온 "약 150ms"는 OpenAI 문서에 없는 수치입니다.
2026년 10월 10일 기준 공개된 것과 공개되지 않은 것
공개 베타와 함께 문서, 요청·응답 형식, 가격이 모두 나왔습니다. 남은 미공개 항목은 주로 GA 이후 조건과 사용 한도입니다.
| 항목 | 2026년 10월 10일 기준 |
|---|---|
| 이용 상태 | 공개 베타(2026년 10월 6일, 미국 시간). GA는 "앞으로 몇 주 안"이며 날짜 미정 |
| 이용 대상 | 커뮤니티 공개 베타 공지는 "모든 개발자 대상". 별도 신청 절차나 티어 조건은 문서에 없음 |
| 모델 | gpt-6-luna만 지원 |
| 엔드포인트·SDK | POST /v1/decisions, client.decisions.create(Go는 client.Decisions.New) |
| SDK 최소 버전 | Python 3.26.0, JavaScript 7.30.0, Go 3.73.0, Ruby 0.101.0, Java 4.78.0 |
| 가격 | 입력 100만 토큰당 $0.10, 출력·캐시 읽기·캐시 쓰기 과금 없음(Decisions 가이드에 기재, 요금 페이지에는 별도 행 없음) |
| 데이터 통제 | 대상 고객은 ZDR(데이터 미보존)·HIPAA 사용 가능. 데이터 상주·지역 처리는 미국, 유럽(EEA+스위스) |
| 미공개 | GA 날짜와 GA 가격, Decisions 전용 속도 제한, 요청당 질문 수 상한, score 단계 수 상한, 캐시 할인 도입 여부 |
한 가지 헷갈리기 쉬운 점이 있습니다. GPT-6 Luna 모델 페이지의 엔드포인트 표에는 2026년 10월 10일 기준으로도 v1/decisions가 없습니다. 문서끼리 맞지 않는 것이므로 모델 페이지만 보고 "Luna는 Decisions를 지원하지 않는다"고 판단할 필요는 없습니다. 지원 여부는 Decisions 가이드와 변경 이력이 기준입니다.
Luna 기준 비용 계산: 캐시 없는 Decisions가 비싸지는 지점
Decisions 가이드의 가격 항목에 따르면 /v1/decisions에서는 입력 토큰만 100만 토큰당 $0.10으로 청구됩니다. "출력 과금 없음"은 엔드포인트가 무료라는 뜻이 아니라, 들어간 입력 토큰을 하나도 할인 없이 센다는 뜻입니다. 비교 대상인 Luna의 Responses API 표준 요금은 모델 페이지 기준 입력 $0.10, 캐시된 입력 $0.01, 캐시 쓰기 $0.125, 출력 $0.50(모두 100만 토큰당)입니다.
Decisions 1회   = 입력 토큰 × $0.10 / 1,000,000
Responses 1회   = 캐시 안 된 입력 × $0.10 / 1,000,000
                + 캐시 적중 입력 × $0.01 / 1,000,000
                + 출력 토큰 × $0.50 / 1,000,000
두 가지 대표 구조에 대입하면 결과가 정반대로 나옵니다. 토큰 수는 가정한 값이고, Responses 쪽은 추론을 none으로 두고 {"answer":"billing"} 같은 한 필드짜리 JSON을 받는 경우입니다.
| 가정 | 경로 | 1회 | 1,000회 | 100만 회 |
|---|---|---|---|---|
| A: 입력 400 / 출력 15, 캐시 없음 | Decisions | $0.00004 | $0.04 | $40 |
| A: 입력 400 / 출력 15, 캐시 없음 | Luna Responses + enum | $0.0000475 | $0.0475 | $47.50 |
| B: 고정 지시문 1,500 + 가변 100 / 출력 10 | Decisions | $0.00016 | $0.16 | $160 |
| B: 고정 지시문 1,500 + 가변 100 / 출력 10 | Luna Responses, 캐시 적중 | $0.00003 | $0.03 | $30 |
- A(짧은 입력): Decisions는 400 × $0.10/100만 = $0.00004입니다. Responses는 여기에 출력 15 × $0.50/100만 = $0.0000075가 더해져 $0.0000475이므로, Decisions가 100만 회당 $7.50(약 16%) 쌉니다.
- B(긴 고정 지시문): Decisions는 1,600토큰 전부를 정가로 내서 $0.00016입니다. Responses는 캐시 적중 1,500 × $0.01/100만 = $0.000015, 가변 100 × $0.10/100만 = $0.00001, 출력 10 × $0.50/100만 = $0.000005를 합쳐 $0.00003으로, Responses가 약 5.3배 쌉니다.
손익분기는 식 하나로 정리됩니다. 캐시되는 고정 부분을 P, 캐시되지 않는 입력을 V, 출력을 O라고 하면 Decisions가 싼 조건은 0.10 × (P + V) < 0.01 × P + 0.10 × V + 0.50 × O, 즉 P가 O의 약 5.6배보다 작을 때뿐입니다. 출력 15토큰이면 고정 부분이 약 83토큰 미만이어야 한다는 뜻입니다. 그런데 프롬프트 캐시는 1,024토큰 이상의 접두부만 저장하고, 마지막 사용 후 최소 30분 동안 유지합니다. 그래서 캐시가 걸릴 만큼 긴 프롬프트는 캐시가 적중하는 한 Responses가 싸고, Decisions는 프롬프트가 짧거나 요청 간격이 길어 캐시가 자주 만료되는 경우에 비용상 유리합니다. 캐시가 빗나간 요청에서는 Responses가 접두부에 캐시 쓰기 요금($0.125)을 내므로 Decisions 쪽이 쌉니다.
이 비교는 토큰 단가만 본 것입니다. 확률 값과 속도는 Decisions에만 있는 장점이므로, 비용이 조금 높아도 이 두 가지가 필요하면 Decisions를 고를 이유가 됩니다. 결과를 바꾸는 조건도 함께 확인하세요.
- 이미지 입력: 스크린샷·사진은 두 경로 모두 입력 토큰을 늘립니다. 위 표는 텍스트만 기준입니다.
- 지역 처리와 긴 컨텍스트: Decisions에도 지역 처리 할증(Luna 기준 +10%)과 긴 컨텍스트 입력 배율이 그대로 적용됩니다.
- Batch: Luna Responses는 Batch·Flex가 표준의 50%라서 A 구조를 야간 일괄 처리하면 100만 회 $23.75입니다. Decisions 가이드에는 Batch·Flex 요금이 따로 나오지 않습니다.
- Responses에서 추론 단계를 올릴 때: eesel 테스트에서 문의 1,000건당 비용은 추론
none일 때 약 $0.047,medium일 때 약 $0.089였습니다. Decisions는 출력·추론 토큰을 청구하지 않습니다.
더 큰 모델로 바꿨을 때의 단가 차이는 GPT-6 Luna와 Sol 가격 비교: API 요금과 Codex 크레딧에서 같은 방식으로 계산합니다.
POST /v1/decisions 첫 요청: choice·predicate·score 작성법
준비물은 OpenAI API 키와 최신 SDK입니다. Python이라면 pip install -U "openai>=3.26.0"으로 올리고 OPENAI_API_KEY 환경 변수를 설정합니다. 아래 코드는 OpenAI 가이드의 요청 형태를 그대로 따르고 문자열만 한국어로 바꾼 예제이며, 응답 예시의 숫자는 문서가 "예시"라고 밝힌 값입니다. 실제 값은 직접 호출해서 확인해야 합니다.
choice 질문으로 문의 라우팅하기
from openai import OpenAI

client = OpenAI()  # OPENAI_API_KEY 환경 변수를 읽습니다

decision = client.decisions.create(
    model="gpt-6-luna",
    input="주문 #4471 결제가 두 번 됐습니다. 환불해 주세요.",
    questions=[
        {
            "type": "choice",
            "name": "department",
            "instructions": "이 고객 문의를 처리할 부서는 어디입니까?",
            "choices": [
                {"value": "billing", "description": "결제, 청구서, 환불"},
                {"value": "technical", "description": "제품 사용 중 문제"},
                {"value": "shipping", "description": "배송과 배송 조회"},
                {"value": "other", "description": "위 분류에 해당하지 않는 요청"},
            ],
        }
    ],
)

answer = decision.answers[0]
if answer.type == "refusal":
    print(f"답변 거부: {answer.name}")
elif answer.type == "choice":
    print(answer.choice, answer.confidence)
    for item in answer.probabilities:
        print(item.value, item.probability)

print(decision.usage.input_tokens)  # 과금 대상 입력 토큰 수
문서에 실린 예시 응답은 다음과 같습니다.
{
  "answers": [
    {
      "type": "choice",
      "name": "department",
      "choice": "billing",
      "probabilities": [
        { "value": "billing", "probability": 0.95 },
        { "value": "technical", "probability": 0.02 },
        { "value": "shipping", "probability": 0.01 },
        { "value": "other", "probability": 0.02 }
      ],
      "confidence": 0.93
    }
  ]
}
선택지마다 description을 붙여 언제 그 값을 고르는지 설명해 두는 것이 가이드의 권장 사항이고, 어느 범주에도 맞지 않는 입력을 받을 other 같은 예비 선택지도 넣으라고 안내합니다. curl로 보낼 때는 같은 JSON을 https://api.openai.com/v1/decisions에 Authorization: Bearer $OPENAI_API_KEY 헤더와 함께 POST하면 됩니다.
응답 필드 읽는 법: probability·choice·confidence·score
| 필드 | 나오는 질문 유형 | 의미 | 코드에서 쓰는 법 |
|---|---|---|---|
probability | predicate | 조건이 참일 확률 추정치(0~1) | 직접 정한 임계값과 비교 |
choice | choice | 개발자가 준 값 중 하나. 문자열과 불리언은 타입까지 구분 | 분기 키 |
probabilities | choice, score | 선택지(또는 단계)별 확률 배열. score는 단계 번호(value)와 label도 포함 | 1·2위 차이 확인, 로그 저장 |
confidence | choice, score | 확률 분포와 별도로 주는 값. 계산 방식은 문서에 없음 | 임계값 후보로 쓰되 라벨 데이터로 검증 |
score | score | 0부터 시작하는 단계 번호의 확률 가중평균. 단계 사이 값이 나올 수 있음 | 구간을 나눠 처리 |
type: "refusal" | 모든 유형 | 그 질문에 대한 답을 거부. 같은 요청의 다른 질문은 답을 받을 수 있음 | 사람 검토 대기열로 |
usage | 응답 전체 | input_tokens 등 토큰 집계 | 비용 기록 |
score의 계산은 예를 보면 바로 이해됩니다. 단계가 "외관만(0) / 우회 가능(1) / 사용 불가(2)"이고 확률이 0.1, 0.7, 0.2라면 score는 0 × 0.1 + 1 × 0.7 + 2 × 0.2 = 1.1입니다. "가장 가능성 높은 단계 하나"가 필요하면 score가 아니라 choice로 물어야 합니다.
이미지와 여러 질문을 한 요청에 담기
서로 독립적인 질문은 같은 questions 배열에 유형을 섞어 넣을 수 있습니다. 반대로 앞 질문의 답에 따라 다음 질문이 달라진다면 요청을 나눠야 합니다. 아래 예제는 반품 사진 한 장으로 파손 여부(predicate)와 제품 분류(choice)를 한 번에 묻고, 파손 확률이 높을 때만 심각도(score)를 두 번째 요청으로 묻습니다.
import base64
from pathlib import Path

from openai import OpenAI

client = OpenAI()
image_base64 = base64.b64encode(Path("product.png").read_bytes()).decode("ascii")
photo_input = [
    {
        "role": "user",
        "content": [
            {"type": "input_text", "text": "고객이 반품 접수 때 보낸 제품 사진입니다."},
            {"type": "input_image", "image_url": f"data:image/png;base64,{image_base64}"},
        ],
    }
]

first = client.decisions.create(
    model="gpt-6-luna",
    input=photo_input,
    questions=[
        {
            "type": "predicate",
            "name": "visible_damage",
            "instructions": "제품에 금, 찢어짐, 찌그러짐 같은 눈에 보이는 파손이 있습니까? 그림자와 포장 손상은 무시하세요.",
        },
        {
            "type": "choice",
            "name": "category",
            "instructions": "사진 속 제품의 분류는 무엇입니까?",
            "choices": [
                {"value": "electronics", "description": "전자제품"},
                {"value": "apparel", "description": "의류·잡화"},
                {"value": "furniture", "description": "가구"},
                {"value": "other", "description": "그 밖의 제품"},
            ],
        },
    ],
)

answers = {a.name: a for a in first.answers}
damage = answers["visible_damage"]
DAMAGE_THRESHOLD = 0.7  # 예시 값입니다. 라벨을 붙인 실제 사진으로 다시 정하세요

if damage.type == "predicate" and damage.probability >= DAMAGE_THRESHOLD:
    second = client.decisions.create(
        model="gpt-6-luna",
        input=photo_input,
        questions=[
            {
                "type": "score",
                "name": "severity",
                "instructions": "파손이 제품 사용에 주는 영향은 어느 정도입니까?",
                "levels": [
                    {"label": "외관만", "description": "겉모습만 상했고 기능은 정상"},
                    {"label": "우회 가능", "description": "일부 기능이 안 되지만 다른 방법으로 사용 가능"},
                    {"label": "사용 불가", "description": "제품을 쓸 수 없음"},
                ],
            }
        ],
    )
print(second.answers[0])levels는 낮은 단계부터 높은 단계 순서로 적고, 이웃한 단계의 기준이 겹치지 않게 써야 합니다. 이미지는 base64 data URL로 보내는 편이 안전한데, 그 이유는 바로 아래 제한 표에 있습니다.
Decisions API 제한: 선택지 2~255개, 이미지 128장, user 역할만
API 레퍼런스와 가이드에 적힌 제한을 모으면 다음과 같습니다.
| 항목 | 제한 |
|---|---|
| choice 선택지 수 | 2~255개, 값은 서로 달라야 함(문자열 또는 불리언) |
| 이미지 | 요청 전체에서 최대 128장, detail은 low·high·auto(기본)·original |
| 이미지 전달 방식 | base64 data URL 권장. file ID는 불가 |
| 메시지 역할 | user만 허용. developer·system 메시지 불가 |
| 지원하지 않는 입력 | 파일, 오디오, 도구·함수 호출, item 참조 |
| 질문 간 의존 | 앞 답에 따라 달라지는 질문은 별도 요청 |
safety_identifier | 선택 항목, 최대 128자 |
| 문서에 없는 상한 | 요청당 질문 수, score 단계 수 |
이미지 전달 방식은 문서끼리 다릅니다. 가이드는 "이미지는 인라인 base64 data URL이어야 하며 HTTP·HTTPS 이미지 URL은 지원하지 않는다"고 하고, API 레퍼런스는 "base64 data URL 또는 공개 HTTP(S) URL"을 허용한다고 적습니다. 두 문서가 모두 인정하는 base64를 쓰면 어느 쪽이 맞든 동작하므로, 이미지 URL을 넘기는 기존 코드는 서버에서 내려받아 base64로 바꾸는 것이 안전합니다.
속도 제한(RPM·TPM)은 Decisions 전용 수치가 공개되지 않았습니다. OpenAI는 2026년 10월 6일 사용 등급(usage tier)을 Free·Build·Launch·Grow로 바꿨으므로 예전의 "Tier 1" 같은 이름과 수치는 더 이상 맞지 않습니다. 속도 제한 문서에 실린 Luna 표준 한도(Build 5,000 RPM / 200만 TPM, Launch 10,000 RPM / 1,000만 TPM, Grow 30,000 RPM / 1억 8,000만 TPM)가 /v1/decisions에도 적용된다는 설명은 없으니, 자기 조직의 실제 한도는 Settings > Organization > Limits에서 확인하세요. Free 등급(지원 국가 사용자, 월 사용 한도 $100)에서 Decisions를 호출할 수 있는지도 문서에 나와 있지 않습니다.
403 "Decision API is not enabled"의 뜻: 공개 베타 전 프리뷰 권한 오류
이 403은 공개 베타 전 프리뷰 기간에 권한이 없는 계정이 받던 오류입니다. eesel이 2026년 10월 1일과 2일에 일반 API 키로 POST https://api.openai.com/v1/decisions를 호출했을 때 아래 응답을 받았다고 공개했습니다.
{
  "error": {
    "message": "Decision API is not enabled for this user.",
    "type": "invalid_request_error",
    "param": null,
    "code": null
  }
}
10월 6일 공개 베타 이후에는 이 오류를 받았다는 공개 보고가 없습니다. classmethod와 커뮤니티 테스터들도 접근 오류 없이 호출했다고 적었습니다. 지금 비슷한 오류를 만난다면 원인은 공식 문서에 없으므로 아래 순서로 좁혀 보는 수밖에 없습니다.
| 증상 | 먼저 확인할 것 |
|---|---|
403 Decision API is not enabled for this user. | 키가 속한 조직·프로젝트가 맞는지, 프로젝트 설정에서 모델·엔드포인트 사용을 막아 두지 않았는지 확인합니다. 재시도만으로는 해결되지 않습니다 |
| 404 | 경로가 /v1/decisions인지 확인합니다. 프리뷰 기간 테스트에서 /v1/decisions/create, /v1/beta/decisions는 404였습니다 |
client.decisions가 없다는 SDK 오류 | SDK가 최소 버전보다 오래된 경우입니다. Python 3.26.0, JavaScript 7.30.0 이상으로 올립니다 |
| 모델 관련 오류 | model이 gpt-6-luna인지 확인합니다. 다른 모델은 지원하지 않습니다 |
확률 임계값은 라벨 데이터로: 공개 테스트에서 본 choice 확률 편차
Decisions가 돌려주는 확률은 유용하지만, 숫자를 그대로 "맞을 확률"로 읽으면 안 됩니다. 공개 베타 직후 나온 두 테스트가 그 이유를 보여 줍니다.
- classmethod: 문서의 choice 예제를 5회 호출했더니 문서 예시(0.95 / confidence 0.93)와 달리 5회 모두 1.0 / 1.0이 나왔습니다. score 예제도 문서 예시(1.1 / 0.55)와 달리 0.97 / 0.96이었고, 값은 매번 같고 소수점 둘째 자리까지만 나왔습니다.
- OpenAI 개발자 커뮤니티 사용자의 동전 테스트: 앞면이 70% 나오도록 설정한 상황을 물었더니 predicate는 약 70%로 실제 비율과 비슷했지만, choice는 약 98%로 한쪽에 몰렸고 선택지 순서를 바꾸면 확률이 달라졌다고 보고했습니다.
둘 다 작은 표본의 제3자 결과입니다. 그래도 방향은 OpenAI 가이드의 권고와 같습니다. 가이드는 라우팅·필터링·검토 기준이 되는 임계값을 자기 애플리케이션의 라벨 데이터로 정하고, 오탐과 미탐 중 어느 쪽이 더 비싼지에 따라 고르라고 안내합니다. 실무에서는 다음처럼 적용할 수 있습니다.
- 확률 자체가 의미를 가져야 하는 판단(자동 승인할지, 사람에게 넘길지)은 choice보다 predicate로 묻는 방식을 먼저 검토합니다.
- choice를 쓴다면 같은 입력을 선택지 순서만 바꿔 두 번 보내 보고, 확률이 크게 흔들리는 질문은 문구를 고칩니다.
- 사람이 정답을 붙인 실제 입력을 모아 임계값별로 자동 처리 비율과 오류 건수를 계산한 뒤 기준을 정합니다.
'unsure' 선택지와 사람 확인이 필요한 이유
Decisions의 choice도, Luna의 엄격한 enum 스키마도 보장하는 것은 답이 목록 안에 있다는 것까지입니다. Structured Outputs 가이드는 모델이 항상 스키마를 지키려 한다고 설명하면서, 입력이 올바른 답을 낼 수 없는 경우를 어떻게 처리할지 프롬프트에 적어 두라고 안내합니다. Decisions 가이드가 other 같은 예비 선택지를 넣으라고 하는 것도 같은 이유입니다. 분류 범주 밖의 입력은 other, 판단하기 어려운 입력은 unsure처럼 나눠 두면 사람 확인 대기열로 보낼 기준이 분명해집니다.
eesel의 프리뷰 기간 테스트도 이 차이를 보여 줍니다. 문의 20건을 설정별로 두 번씩 돌린 160회 호출에서 담당 팀 선택은 모든 설정이 40건 중 40건을 맞혔지만, "자동 답변을 보내도 안전한가"라는 질문에서는 Luna(추론 none)가 40건 중 33건만 맞혔습니다. 정확도 숫자 자체보다 질문 종류에 따라 정답률이 크게 갈린다는 점이 핵심입니다.
판단 결과가 실제 행동으로 이어지는 경우에는 다음 조건을 지키세요.
- 고객에게 메시지를 보내거나, 결제·환불을 실행하거나, 데이터를 바꾸는 작업은 모델 답만으로 실행하지 않습니다.
unsure·other이거나 확률이 임계값보다 낮은 결과는 사람 확인 대기열로 보냅니다. - 팀 배정처럼 틀려도 다시 옮기면 되는 작업은 자동 처리하되, 사람이 결과를 고친 건수를 기록합니다.
- 입력, 선택지, 모델 답, 확률, 사람이 고친 최종 답을 함께 저장합니다. 이 로그가 임계값을 다시 정하고 두 구현을 비교하는 평가 세트가 됩니다.
GPT-6 Luna와 enum 스키마로 같은 선택 기능 구현하기
프리뷰 기간에는 이 방식이 Decisions를 기다리는 동안의 대체 구현이었지만, 공개 베타 이후에도 다음 경우에는 Responses API 쪽이 낫습니다.
- 1,024토큰이 넘는 고정 지시문·선택지 설명을 매번 붙이고, 요청이 30분 안에 꾸준히 이어져 캐시가 적중하는 경우(위 계산의 B 구조)
- 라벨과 함께 판단 이유 문장이나 추출 필드도 받아야 하는 경우
- 판단 중에 도구를 호출해야 하는 경우
- 과거 데이터를 Batch로 싸게 재분류하는 경우
- Decisions를 제공하지 않는 게이트웨이를 거쳐야 하는 경우
게이트웨이 상황은 이렇습니다. Vercel AI Gateway는 openai/gpt-6-luna-decisions 모델로 Decisions API를 제공하지만 AI SDK 방식이라 요청 형식이 OpenAI의 /v1/decisions와 다를 수 있습니다. laozhang.ai처럼 gpt-6-luna만 OpenAI 호환 형식으로 제공하고 Decisions 모델은 없는 곳에서는 아래 Responses + enum 구현이 쓸 수 있는 경로입니다. 어느 쪽이든 OpenAI 직접 호출과 같은 한도·데이터 조건이 보장되는 것은 아니므로 각 서비스의 문서를 따로 확인해야 합니다.
Python 예제: 판단 호출을 인터페이스 뒤에 두기
아래 코드는 기존 Luna 구현과 Decisions 구현을 같은 Decider 인터페이스 뒤에 둡니다. 호출하는 쪽은 route()만 알기 때문에, 생성하는 클래스 하나만 바꿔 두 경로를 오갈 수 있습니다. 두 클래스 모두 OpenAI 문서의 요청 형태대로 작성했으며, 운영에 넣기 전에 실제 문의로 정답률을 먼저 확인하세요.
import json
from dataclasses import dataclass
from typing import Protocol

from openai import OpenAI  # Decisions 경로는 openai 3.26.0 이상

FALLBACK = "unsure"  # 판단 불가: 사람에게 넘기는 선택지


@dataclass
class Verdict:
    answer: str
    confidence: float | None  # Luna(Responses) 구현은 확률이 없으므로 None


class Decider(Protocol):
    def decide(self, question: str, options: dict[str, str], text: str,
               image_data_url: str | None = None) -> Verdict: ...


def with_fallback(options: dict[str, str]) -> dict[str, str]:
    if FALLBACK in options:
        return options
    return {**options, FALLBACK: "어느 선택지에도 맞지 않거나 판단하기 어려움"}


def user_content(text: str, image_data_url: str | None) -> list[dict]:
    content: list[dict] = [{"type": "input_text", "text": text}]
    if image_data_url:  # data:image/png;base64,... 형식
        content.append({"type": "input_image", "image_url": image_data_url})
    return content


class LunaDecider:
    """Responses API + strict enum 스키마(기존 구현)."""

    def __init__(self, model: str = "gpt-6-luna") -> None:
        self.client = OpenAI()
        self.model = model

    def decide(self, question: str, options: dict[str, str], text: str,
               image_data_url: str | None = None) -> Verdict:
        opts = with_fallback(options)
        guide = "\n".join(f"- {value}: {desc}" for value, desc in opts.items())
        response = self.client.responses.create(
            model=self.model,
            reasoning={"effort": "none"},
            max_output_tokens=50,
            input=[
                {"role": "developer",
                 "content": f"{question}\n선택지:\n{guide}\n"
                            f"확신할 수 없으면 {FALLBACK}을 고르세요."},
                {"role": "user", "content": user_content(text, image_data_url)},
            ],
            text={"format": {
                "type": "json_schema",
                "name": "decision",
                "strict": True,
                "schema": {
                    "type": "object",
                    "properties": {"answer": {"type": "string", "enum": list(opts)}},
                    "required": ["answer"],
                    "additionalProperties": False,
                },
            }},
        )
        # 출력이 잘렸거나 안전 거부가 나오면 판단 불가로 처리합니다
        if response.status == "incomplete":
            return Verdict(FALLBACK, None)
        for item in response.output:
            if item.type == "message" and any(
                part.type == "refusal" for part in item.content
            ):
                return Verdict(FALLBACK, None)
        return Verdict(json.loads(response.output_text)["answer"], None)


class DecisionsApiDecider:
    """POST /v1/decisions의 choice 질문."""

    def __init__(self, model: str = "gpt-6-luna") -> None:
        self.client = OpenAI()
        self.model = model

    def decide(self, question: str, options: dict[str, str], text: str,
               image_data_url: str | None = None) -> Verdict:
        opts = with_fallback(options)
        decision = self.client.decisions.create(
            model=self.model,
            input=[{"role": "user", "content": user_content(text, image_data_url)}],
            questions=[{
                "type": "choice",
                "name": "route",
                "instructions": question,
                "choices": [{"value": value, "description": desc}
                            for value, desc in opts.items()],
            }],
        )
        answer = decision.answers[0]
        if answer.type != "choice":  # refusal
            return Verdict(FALLBACK, None)
        return Verdict(answer.choice, answer.confidence)


ROUTING_QUESTION = "이 고객 문의를 처리할 팀은 어디입니까?"
ROUTING_OPTIONS = {
    "billing": "결제, 청구서, 환불",
    "shipping": "배송과 배송 조회",
    "technical": "제품 사용 중 문제",
    "other": "위 분류에 해당하지 않는 요청",
}
CONFIDENCE_THRESHOLD = 0.8  # 예시 값입니다. 라벨 데이터로 다시 정하세요


def route(decider: Decider, text: str) -> str:
    verdict = decider.decide(ROUTING_QUESTION, ROUTING_OPTIONS, text)
    if verdict.answer in (FALLBACK, "other"):
        return "human_review"
    if verdict.confidence is not None and verdict.confidence < CONFIDENCE_THRESHOLD:
        return "human_review"
    return verdict.answer


if __name__ == "__main__":
    decider: Decider = DecisionsApiDecider()  # 기존 경로는 LunaDecider()
    print(route(decider, "주문 #4471 결제가 두 번 됐습니다. 환불해 주세요."))
구성에서 눈여겨볼 점은 세 가지입니다.
- 지시문 위치가 다릅니다. Decisions는
user역할만 받기 때문에, Luna 구현에서developer메시지에 넣던 지시는 질문의instructions와 선택지별description으로 옮깁니다. - 선택지는 한곳에서 관리합니다.
ROUTING_OPTIONS는 Luna 쪽에서는 enum 목록과 설명문이 되고, Decisions 쪽에서는choices배열이 됩니다. 선택지는 2~255개 안에서 정해야 합니다. - 확률 기준은 Decisions 경로에서만 작동합니다. Luna 구현은
confidence가None이므로unsure선택지만으로 사람 확인을 나누고, Decisions 구현은 여기에 임계값 조건이 더해집니다.
기존 코드가 Chat Completions라면 같은 스키마를 response_format={"type": "json_schema", "json_schema": {...}}에 넣으면 됩니다. Luna 모델 페이지에 따르면 Chat Completions에서 함수 호출을 함께 쓰려면 reasoning_effort를 none으로 둬야 합니다.
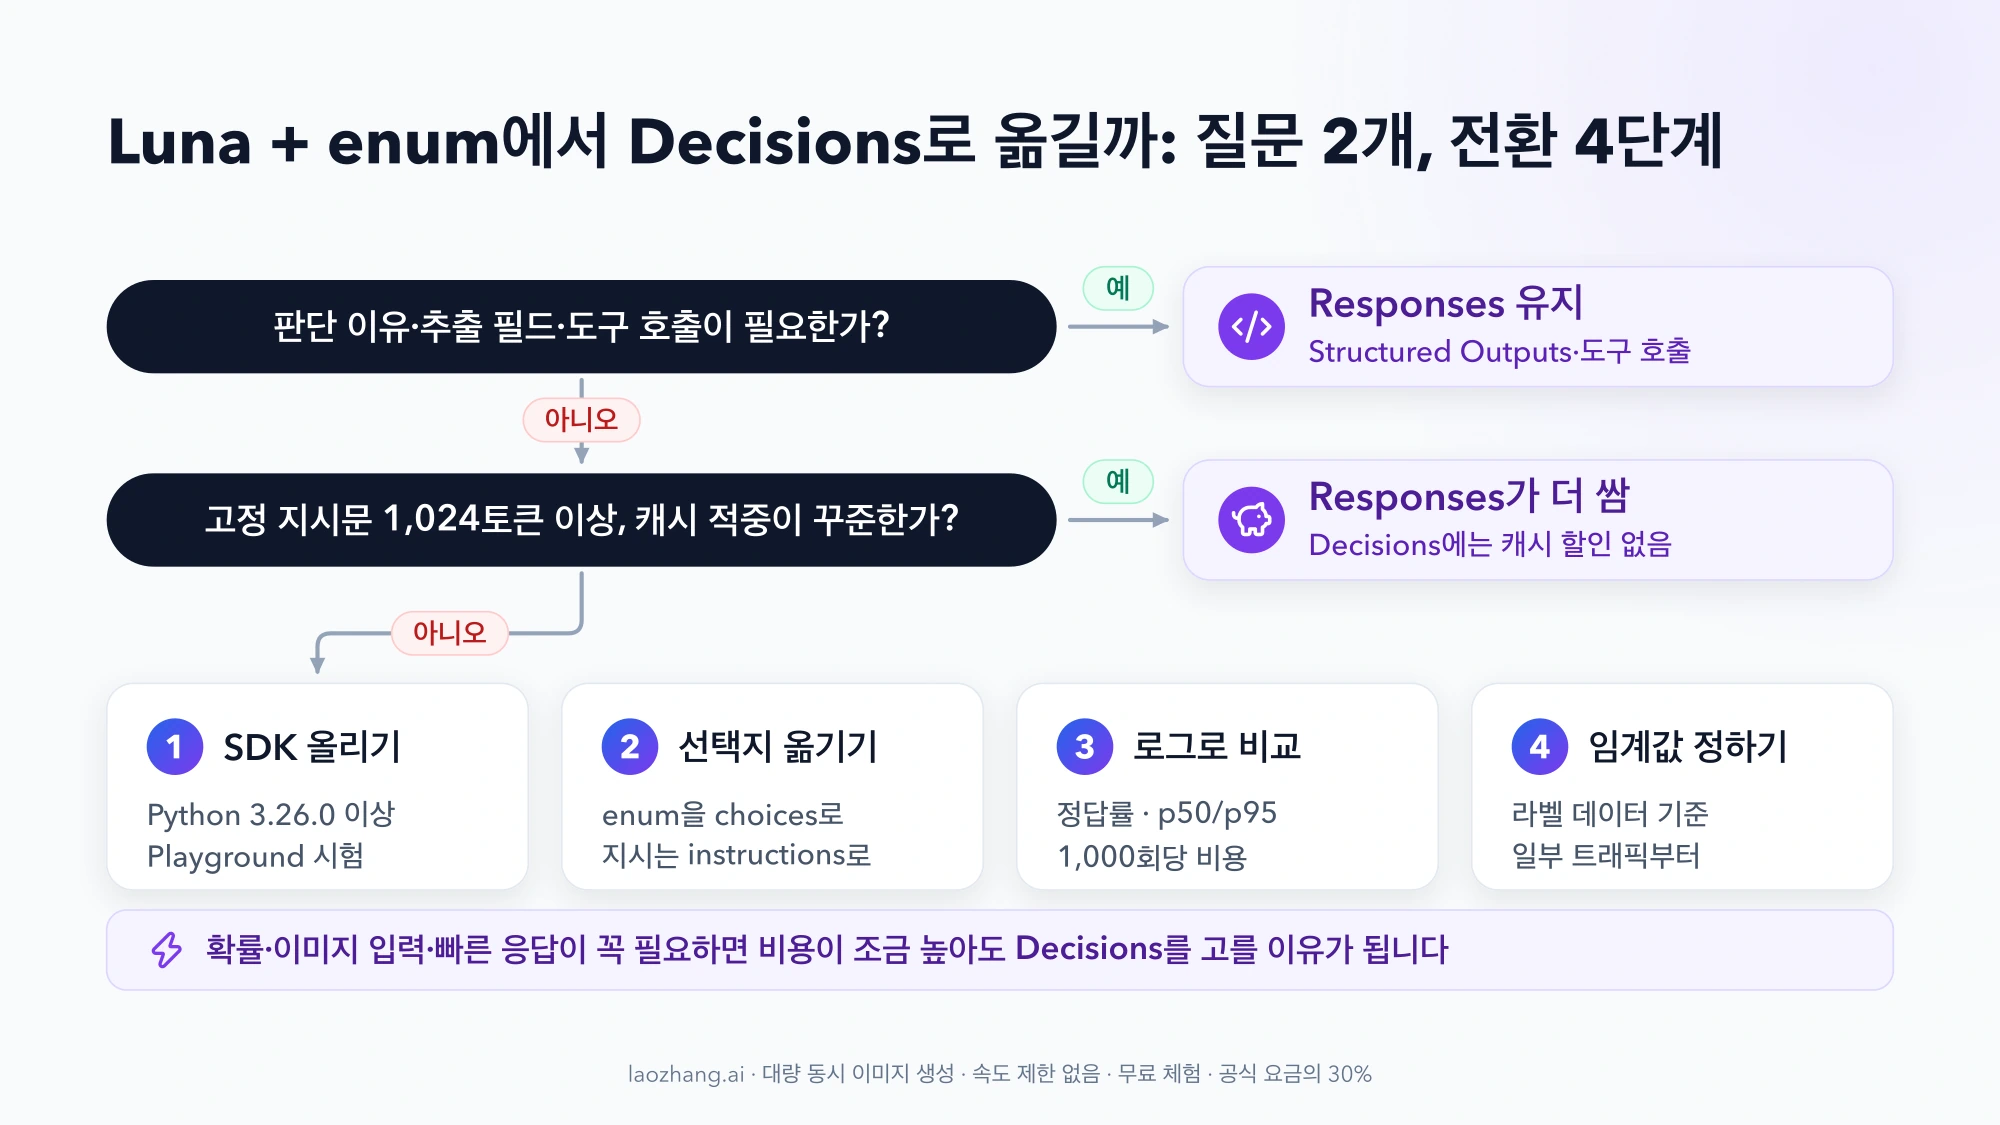
Decisions API로 전환을 검토해야 할 신호
이미 Luna + enum 구현을 운영 중이라면, 다음 중 하나 이상에 해당할 때 Decisions와 나란히 비교할 가치가 있습니다.
- 입력이 짧습니다. 고정 지시문이 캐시 최소 길이(1,024토큰)에 못 미치고 출력이 라벨 하나뿐이라면 위 A 구조처럼 Decisions가 쌉니다.
- 확률이나 점수로 처리를 나누고 싶습니다. 자동 처리와 사람 검토의 경계를 숫자로 정하려면
probability·probabilities·confidence가 있는 Decisions가 맞습니다. - 판단이 응답 속도를 붙잡고 있습니다. 실시간 채팅에서 답변 전에 라우팅하거나, 에이전트가 한 작업에서 작은 판단을 수십 번 반복하면 1초대와 수백 ms의 차이가 그대로 쌓입니다.
- 스크린샷·사진을 판단합니다. 이미지 입력을 받는 결정 전용 엔드포인트라는 점이 Decisions의 분명한 차별점입니다.
- 데이터 조건이 까다롭습니다. ZDR, HIPAA, 미국·유럽 데이터 상주가 필요하면 OpenAI 플랫폼 안에서 그 조건을 그대로 쓸 수 있습니다.
반대로 고정 지시문이 길고 캐시가 꾸준히 적중하거나, 판단 이유 문장이나 도구 호출이 필요하다면 지금 구현을 유지하는 편이 낫습니다. 전환하기로 했다면 순서는 다음과 같습니다.
- SDK를 최소 버전 이상으로 올리고, Playground에서 질문 문구와 선택지 설명을 몇 가지 입력으로 시험합니다.
- 위 예제처럼
DecisionsApiDecider를 추가합니다. 기존 enum 값은choices로,developer지시는instructions와description으로 옮기고, 예비 선택지는 그대로 유지합니다. - 저장해 둔 로그(입력과 사람이 확인한 최종 답)를 두 구현에 똑같이 흘려 보내고 정답률, p50·p95 지연 시간, 1,000회당 비용을 같은 표에 놓습니다. 비용은 응답의
usage.input_tokens로 계산합니다. - 같은 로그로
confidence나probability의 임계값을 정한 뒤, 운영 트래픽 일부만 Decisions로 보내 결과를 기록합니다. - 베타이므로 GA 때 이름이나 가격이 바뀔 수 있습니다. 인터페이스를 남겨 두면 그때도 클래스 하나만 고치면 됩니다.
OpenAI Decisions API 자주 묻는 질문
OpenAI Decisions API 가격은 얼마인가요?
2026년 10월 10일 기준 gpt-6-luna로 /v1/decisions를 호출하면 입력 100만 토큰당 $0.10이고, 출력·캐시 읽기·캐시 쓰기 요금은 없습니다. 캐시 할인도 없으므로 모든 입력 토큰이 정가로 청구되며, 지역 처리 할증과 긴 컨텍스트 배율은 적용됩니다. 입력 400토큰이면 1,000회 $0.04, 100만 회 $40입니다. 이 가격은 베타 기준이며 GA 가격은 아직 발표되지 않았습니다.
Decisions API는 언제 일반에 공개되나요?
이미 2026년 10월 6일(미국 시간)에 공개 베타로 열렸습니다. 그 전 9월 29일 DevDay부터는 선정된 고객만 쓰는 제한적 프리뷰였습니다. 다음 단계인 GA(정식 출시)는 Decisions 가이드에 "앞으로 몇 주 안"이라고만 적혀 있고 날짜는 정해지지 않았습니다.
Decisions API와 TypeSafe Jev는 무엇이 다른가요?
둘 다 정해진 선택지 중에서 고르는 결정 모델이지만, 어느 쪽이 낫다고 단정할 근거는 아직 없습니다. 제3자 비교는 엇갈립니다. classmethod 측정에서는 지연 시간이 비슷했고(중앙값 255ms 대 238ms) 요청당 비용은 Decisions가 높았습니다($0.0000406 대 $0.0000169, Jev 단가는 제3자 기재). 커뮤니티에서는 판단이 미묘한 문제에서 Jev가 더 정확했다는 보고와, 문서 판정·규칙 기반 라우팅에서는 차이가 없었다는 보고가 함께 나왔습니다. 분명한 차이는 Decisions가 이미지 입력을 받고(Jev는 텍스트만), OpenAI 플랫폼의 ZDR·HIPAA·데이터 상주 조건을 그대로 쓸 수 있다는 점입니다. 자기 데이터로 직접 비교해 보고 고르는 것이 가장 확실합니다.
ChatGPT에서 Decisions API를 쓸 수 있나요?
쓸 수 없습니다. Decisions API는 개발자가 API 키로 호출하는 엔드포인트이고, 코드 없이 시험하는 곳도 ChatGPT가 아니라 OpenAI 플랫폼의 Playground입니다. ChatGPT 앱이나 요금제 기능으로 안내된 내용은 없으며, 호출 비용은 ChatGPT 구독과 별개로 API 사용량에 청구됩니다.
Decisions API 응답에 신뢰도 점수가 포함되나요?
질문 유형에 따라 다릅니다. predicate는 조건이 참일 확률 probability 하나를 돌려주고, choice와 score는 선택지·단계별 probabilities와 별도의 confidence를 함께 돌려줍니다. 다만 confidence의 계산 방식은 공개되지 않았고, 공개 테스트에서는 choice 확률이 1.0으로 고정되거나 선택지 순서에 따라 달라진 사례가 보고됐습니다. 숫자를 그대로 믿기보다 라벨을 붙인 자기 데이터로 임계값을 정하고, unsure 같은 예비 선택지와 사람 확인 경로를 함께 두세요.
Decisions API 속도 제한(RPM)은 얼마인가요?
2026년 10월 10일 기준 Decisions 전용 속도 제한은 공개되지 않았습니다. GPT-6 Luna의 표준 한도(Build 등급 5,000 RPM 등)가 /v1/decisions에도 적용된다는 설명은 없으므로, 자기 조직의 Settings > Organization > Limits에서 직접 확인해야 합니다. 10월 6일에 사용 등급이 Free·Build·Launch·Grow로 바뀌었기 때문에 예전 "Tier 1" 기준 수치는 더 이상 맞지 않습니다.