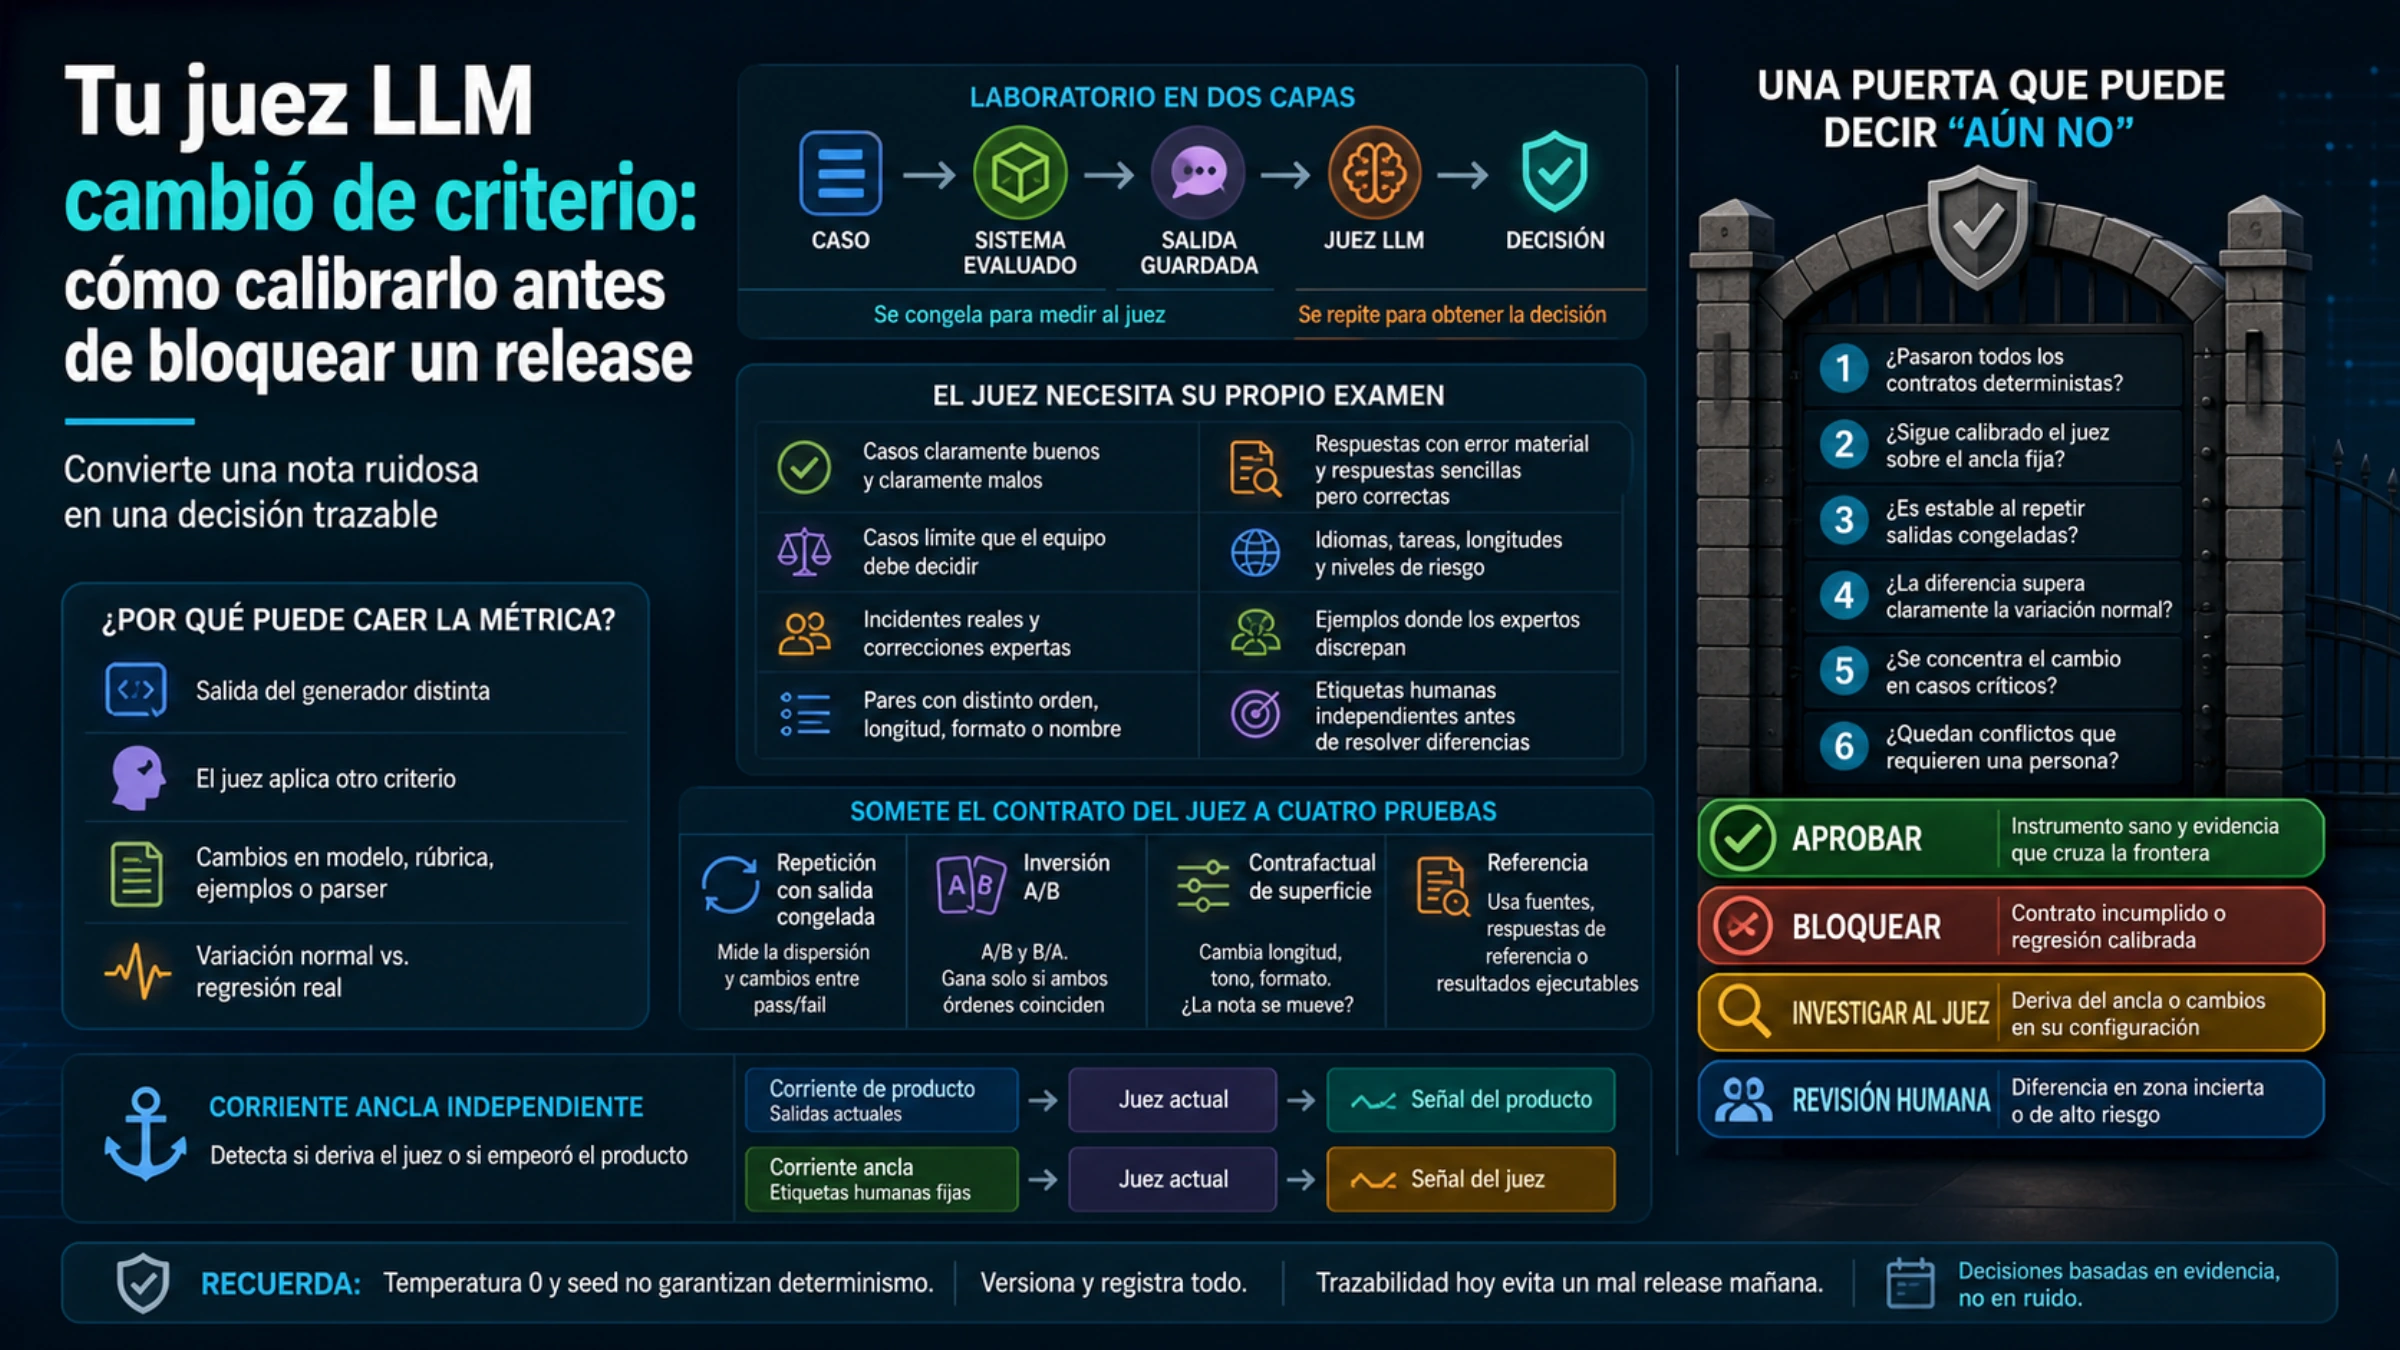
Una versión obtiene un 82 % de aprobados. Al día siguiente, sin cambios visibles en el producto, cae al 76 %. Ese descenso parece una regresión, pero la cifra mezcla dos sistemas probabilísticos: el modelo que genera la respuesta y el modelo que la califica.
La salida candidata puede ser distinta. El juez puede resolver de otra manera el mismo caso. También pueden haber cambiado su modelo, la rúbrica, los ejemplos o el parser. Una media final no identifica cuál de esas piezas se movió.
La meta útil no es prometer determinismo absoluto. Es poder atribuir el cambio a producto, juez, variación normal o evidencia insuficiente antes de tomar una decisión de lanzamiento.
Separa el laboratorio en dos capas
El flujo mínimo es:
caso -> sistema evaluado -> salida guardada -> juez LLM -> decisiónRepetir toda la cadena sirve para medir la experiencia completa, pero no la repetibilidad del juez. Para medir al juez hay que congelar la salida candidata y repetir únicamente la calificación.
| Pregunta | Qué se mantiene fijo | Qué se repite | Resultado |
|---|---|---|---|
| ¿El juez mantiene su criterio? | Caso, salida, rúbrica y configuración | Solo el juez | Dispersión y cambios entre aprobado y rechazado |
| ¿La experiencia es estable? | Conjunto de datos y criterios con versiones registradas | Generación y calificación | Distribución de extremo a extremo |
| ¿B mejora a A? | Casos y juez calibrado | Versión del producto | Diferencia emparejada e incertidumbre |
| ¿Derivó el juez? | Salidas fijas con etiqueta humana | Juez actual a lo largo del tiempo | Cambio en desacuerdo juez–humano |
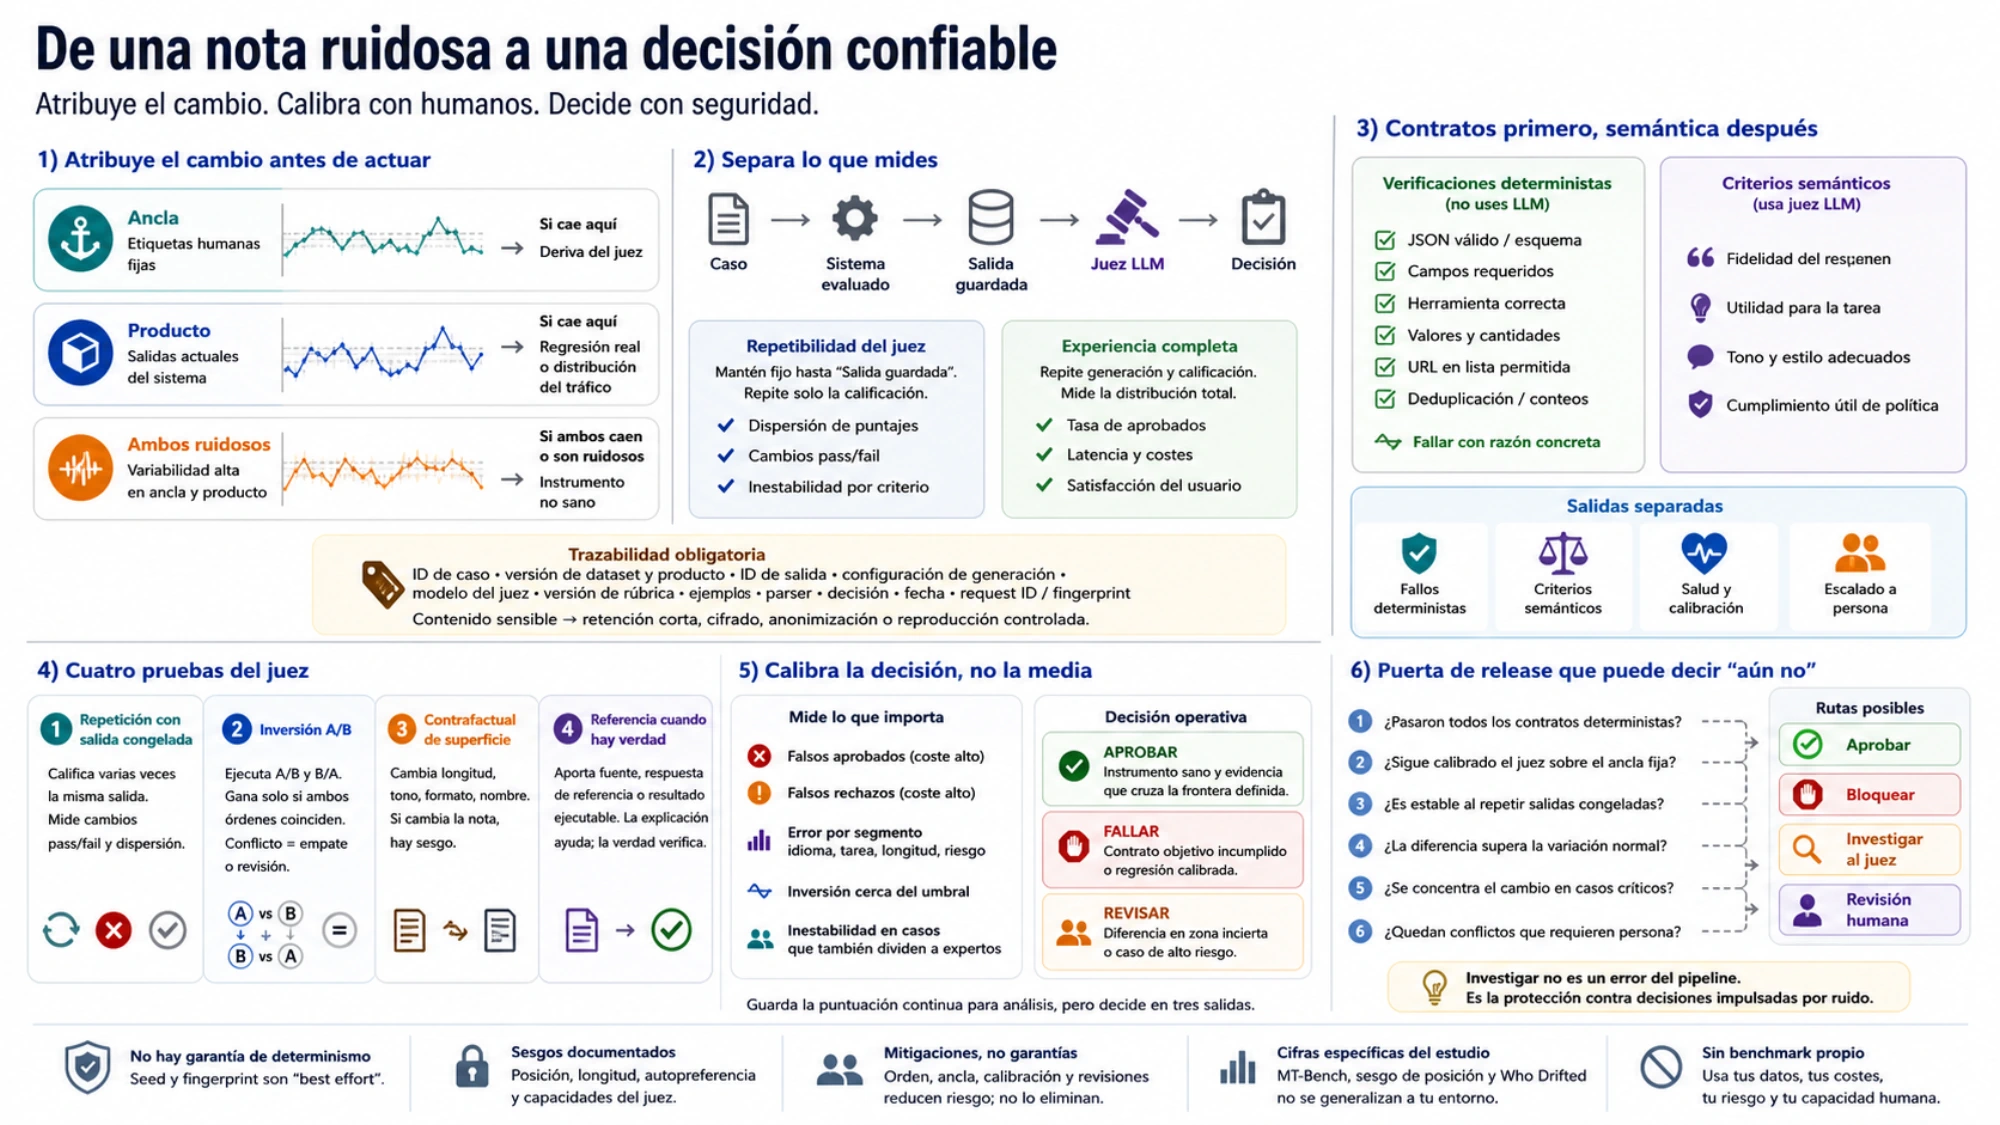
Para hacerlo posible, cada nota debe apuntar al ID del caso, versión del conjunto de datos y del producto, ID de la salida, configuración de generación, modelo del juez, versión de rúbrica, ejemplos y parser, decisión y fecha. Si el contenido es sensible, aplica retención corta, cifrado, anonimización o una reproducción controlada. No sacrifiques la trazabilidad sin diseñar una alternativa aprobada.
Quita del juez todo lo que pueda comprobar un programa
No uses un LLM para decidir si un JSON es válido, falta un campo, se llamó a la herramienta correcta, una cantidad coincide o una URL pertenece a una lista permitida. Son contratos ejecutables y deben fallar con una razón concreta.
Reserva el juez para criterios semánticos: fidelidad de un resumen, utilidad para la tarea, adecuación del tono o cumplimiento útil de una política.
La guía actual de OpenAI sobre buenas prácticas de evaluación recomienda evaluaciones específicas de la tarea, seguimiento continuo, calibración con valoraciones humanas y decisiones acotadas, como comparar pares o aprobar y rechazar. Su guía de evaluadores distingue comprobaciones de texto, similitud y evaluadores de modelo. La API es específica de OpenAI, pero el criterio de diseño es general: usa la medición menos ambigua que pueda responder a la pregunta.
Mantén salidas separadas para:
- fallos deterministas;
- cada criterio semántico;
- salud y calibración del juez;
- escalado a una persona.
Una nota global de 7,3/10 borra si el problema fue un dato falso, una estructura incorrecta o una simple preferencia de estilo.
El juez necesita su propio examen
Antes de conectarlo a CI, crea un conjunto de calibración con:
- casos claramente buenos y claramente malos;
- casos límite cuya política deba decidir el equipo;
- incidentes reales y correcciones expertas;
- pares de calidad similar con distinto orden, longitud, formato o nombre;
- respuestas fluidas con un error material y respuestas sencillas pero correctas;
- idiomas, tareas, longitudes y niveles de riesgo de producción;
- ejemplos donde los propios expertos discrepan.
Pide etiquetas independientes antes de resolver diferencias. El desacuerdo humano no es basura: puede mostrar una rúbrica ambigua, dos políticas legítimas o un caso que nunca debió automatizarse.
La investigación demuestra tanto el potencial como los límites. El estudio original de MT-Bench y Chatbot Arena obtuvo una alta concordancia entre un juez potente y humanos en su configuración, pero también documentó sesgo de posición, preferencia por respuestas largas, autopreferencia y límites de razonamiento. Su porcentaje pertenece a esos modelos, prompts y datos; no certifica otro juez.
Large Language Models Are Not Fair Evaluators mostró que cambiar el orden podía alterar rankings y evaluó equilibrio de posición, múltiples evidencias y participación humana. Después, un estudio sistemático del sesgo de posición cubrió 15 jueces, 22 tareas y más de 150 000 evaluaciones en su versión revisada de noviembre de 2025. El sesgo variaba según juez y tarea. Elegir un modelo más capaz no sustituye la validación local.
Somete el contrato del juez a cuatro pruebas
Repetición con salida congelada
Califica varias veces la misma salida guardada sin cambiar contrato ni configuración. Conserva todas las decisiones, no solo la media. Mide cuántas veces pasa de aprobado a rechazado o a la inversa y en qué criterio aparece la mayor dispersión.
Si incluso los casos obvios cambian de lado, el juez no está listo para decidir por sí solo si una versión se aprueba o se bloquea. Si la variación se concentra en casos genuinamente ambiguos, crea una zona de revisión humana.
Inversión A/B
En comparaciones por pares, ejecuta A/B y B/A. Una regla conservadora declara ganador solo cuando ambos órdenes coinciden; el conflicto se registra como empate o revisión. Aunque aleatorices el orden a gran escala, informa por separado la consistencia posicional.
Cambios de presentación sin alterar el contenido
Cambia longitud, encabezados, tono, nombre del asistente o formato sin cambiar el contenido útil. Si la nota cambia con la presentación, el juez mide una preferencia propia.
Esta prueba también permite detectar si el sistema aprende a satisfacer al evaluador en vez de mejorar: puede escribir más y con mayor autoridad, conseguir una nota superior y seguir sin resolver mejor la tarea según los expertos.
Referencia cuando existe verdad verificable
Para extracción, preguntas con fuentes, fidelidad de resúmenes, matemáticas o uso de herramientas, aporta texto fuente, respuesta de referencia o resultado ejecutable. La explicación del juez ayuda a depurar, pero no demuestra que el veredicto sea correcto.
Calibra la decisión, no una media
Restar 0,08 a todas las notas porque el juez puntúa más alto que los humanos no corrige rankings equivocados, errores asimétricos ni fallos de un segmento.
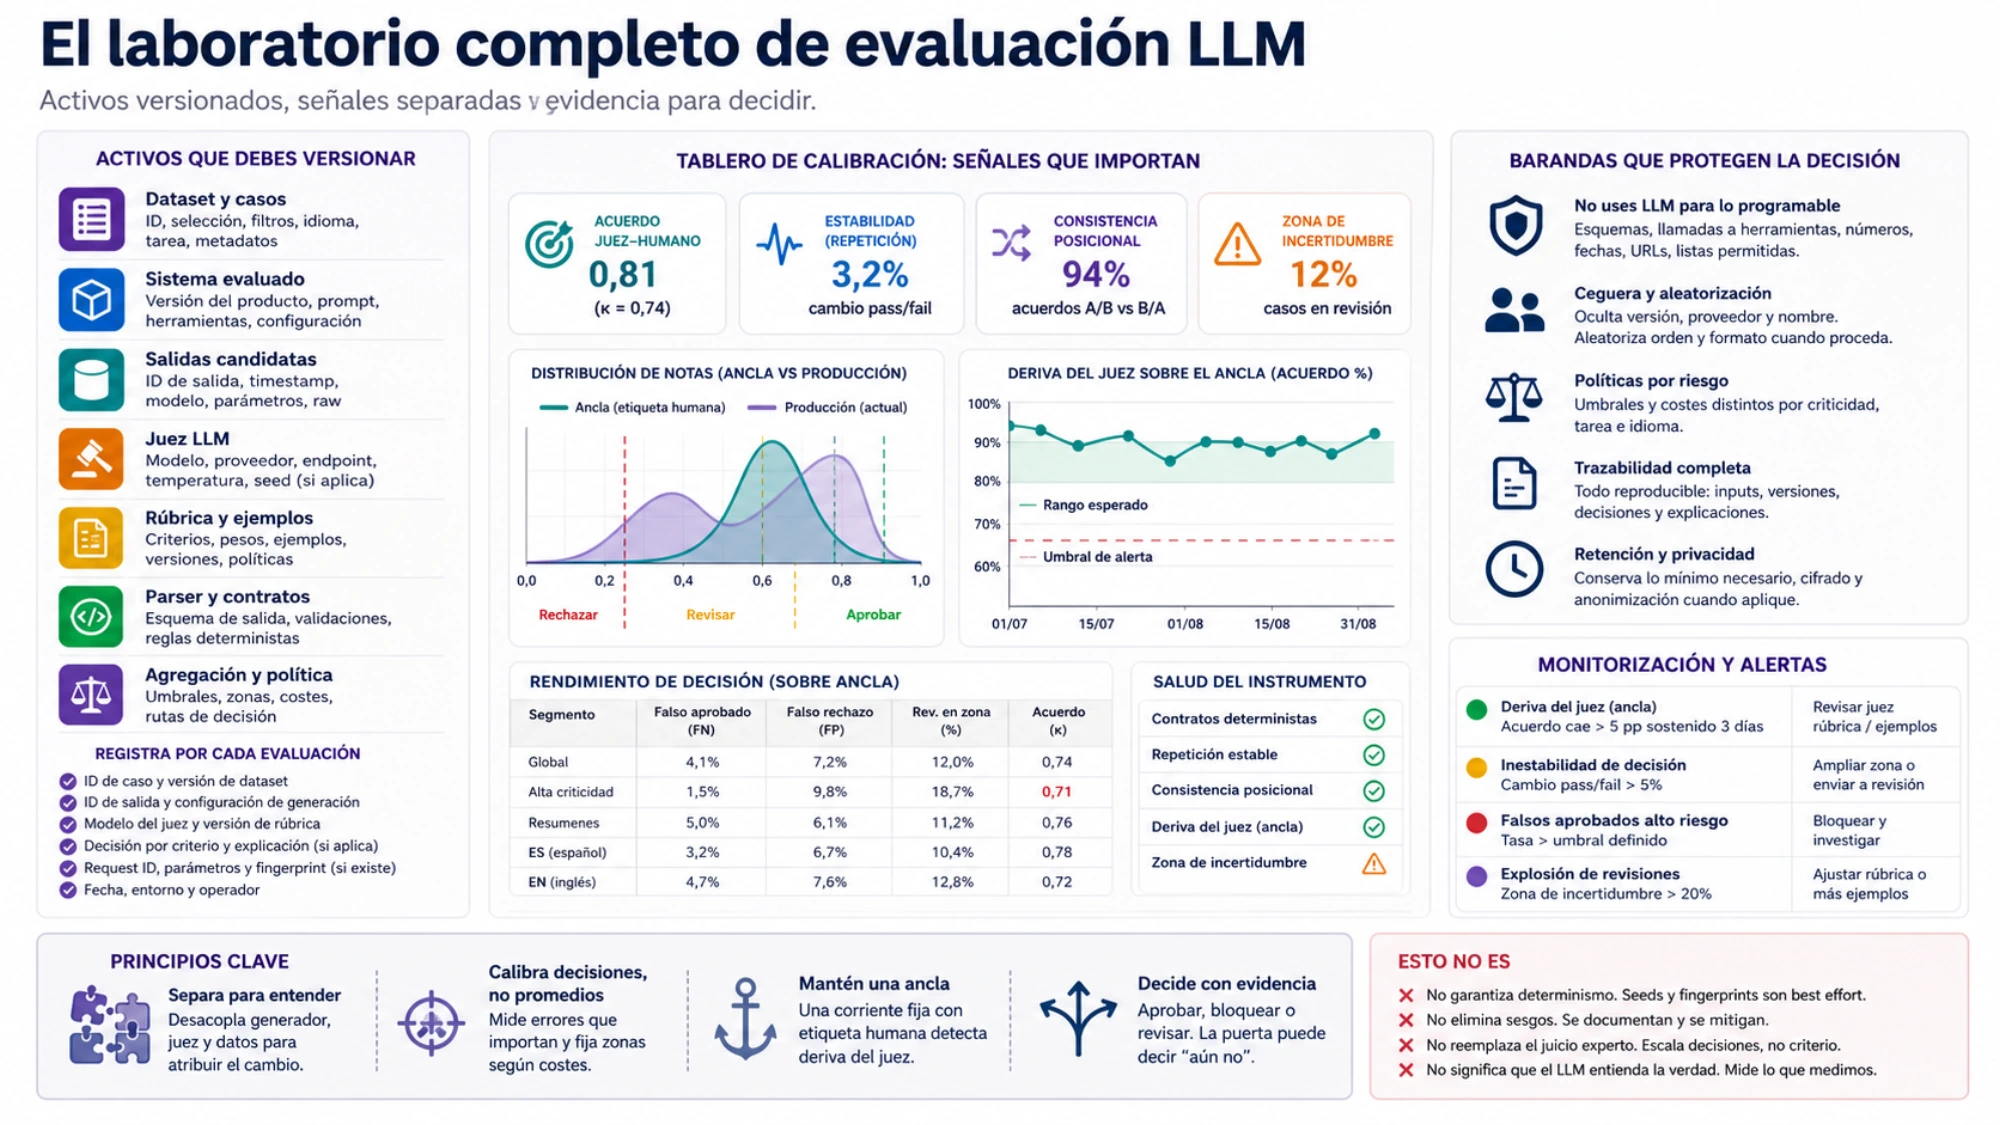
Mide las decisiones que importan:
- cuántos fallos claros deja pasar;
- cuántas salidas buenas bloquea;
- dónde cambia el error por idioma, tarea, longitud o riesgo;
- cuánto se invierte la decisión cerca del umbral;
- si la inestabilidad coincide con casos que también dividen a expertos.
Un falso aprobado y un falso rechazo no suelen costar lo mismo. Dejar pasar consejo sensible sin apoyo y mandar un titular de marketing a una revisión extra exigen políticas distintas. Define primero los costes y la capacidad humana; luego estima con tus datos el tamaño de muestra, repeticiones y zona de incertidumbre. No existe un 0,80 universal.
Para decidir un lanzamiento, aprobar, rechazar y revisar suelen ser más honestos que dos decimales. Puedes guardar una puntuación continua para análisis, sin fingir más precisión de la que respalda la calibración.
Mantén un conjunto de referencia independiente
Conserva un núcleo estable de salidas con etiquetas humanas y vuelve a calificarlas regularmente con el juez actual.
Producto: respuestas actuales -> juez actual -> resultado del producto
Referencia: respuestas fijas -> juez actual -> comparar con etiquetas humanas fijas
Si empeora la puntuación del producto y la referencia se mantiene estable, investiga el producto o la distribución del tráfico. Si el juez se vuelve más estricto también sobre el ancla, revisa modelo del juez, rúbrica, ejemplos, parser y backend. Si ambas señales son ruidosas, la medición aún no es suficientemente fiable para bloquear una versión.
El preprint de 2026 Who Drifted: the System or the Judge? formaliza esta separación mediante un conjunto fijo con etiquetas humanas y monitores distintos para la brecha juez–humano y el flujo principal. Sus tasas de detección y costes son resultados de ese experimento, no garantías. La identificación sí es útil: un cambio del producto no altera una salida ancla ya guardada; un cambio del juez puede alterar cómo la califica.
No sustituyas el conjunto de referencia con cada versión del producto. Añade casos bajo una nueva versión y registra por qué cambió una etiqueta humana o la política.
Permite que la decisión de lanzamiento quede pendiente
Una secuencia operativa:
1. ¿Pasaron todos los contratos deterministas?
2. ¿Sigue calibrado el juez sobre el ancla fija?
3. ¿Es estable al repetir salidas congeladas?
4. ¿La diferencia supera claramente la variación normal?
5. ¿Se concentra el cambio en casos críticos?
6. ¿Quedan conflictos que requieren una persona?
La salida puede ser:
- aprobar, si el evaluador sigue calibrado y los resultados superan el umbral definido;
- bloquear, por contrato objetivo incumplido o regresión calibrada;
- investigar al juez, si deriva el ancla o cambia su configuración;
- revisión humana, cuando la diferencia cae en la zona incierta o afecta alto riesgo.
Dejar una decisión pendiente es una salida válida del proceso. Evita retirar o lanzar una versión por una variación que aún no sabes explicar.
Temperatura cero y seed tampoco prueban determinismo. Alias del modelo, infraestructura, composición del prompt, herramientas y parser pueden cambiar. El ejemplo histórico de OpenAI sobre reproducibilidad con seed y system fingerprint hablaba de resultados “en su mayoría” iguales en modelos preview entonces compatibles y advertía que no garantizaba determinismo. No lo generalices a cualquier modelo, endpoint o proveedor actual.
Versiona modelo del juez, rúbrica, ejemplos, esquema de salida, parser, agregación y política de decisión. Registra el identificador de solicitud, los parámetros y la huella de la configuración del servicio, si están disponibles. Esos datos ayudan a explicar diferencias; no garantizan que una nueva ejecución produzca el mismo resultado.
Guion de incidente para una métrica que ya cayó
- Confirma versiones del conjunto de datos, producto, juez, rúbrica, ejemplos, parser y agregación.
- Separa fallos deterministas de decisiones semánticas.
- Recalifica las salidas guardadas sin volver a generarlas.
- Vuelve a evaluar las respuestas de referencia y compara los resultados con sus etiquetas humanas fijas.
- Segmenta el cambio por tarea, idioma, longitud, riesgo y origen.
- Repite pruebas de orden o presentación para el criterio afectado.
- Envía casos discutidos de alto impacto a expertos sin revelar qué versión es cuál.
- Cambia la decisión de lanzamiento solo cuando una hipótesis tenga evidencia que las demás no expliquen.
Un juez LLM gana autoridad de forma gradual. Primero se eliminan los criterios deterministas, después se mide su repetibilidad, se calibra con expertos, se prueban atajos y se vigila con anclas. La capacidad de detenerse ante evidencia insuficiente es lo que convierte una nota inestable en una herramienta de calidad.