更新(2026 年 10 月 8 日):
gpt-4o-mini文本模型不在 OpenAI 的弃用名单上,仍可调用,标准价每百万 token 输入 $0.15、输出 $0.60。它的并发上限由新的账户层级决定:截至 2026 年 10 月 8 日,gpt-4o-mini 模型页列出 Build 档 5,000 RPM / 2,000,000 TPM、Launch 档 10,000 RPM / 10,000,000 TPM、Grow 档 30,000 RPM / 150,000,000 TPM,免费层不支持;层级按累计充值 $5、$100、$500 自动升级(见 OpenAI 速率限制文档)。中转服务同样受上游限额和自身限流约束,"不限并发""50 倍性能提升"一类说法没有依据。遇到 429 报错,先看 OpenAI API 配额超限怎么办:429 insufficient_quota 排查指南。
GPT-4o-mini API 的并发上限取决于账户层级:截至 2026 年 10 月 8 日,Build 档 5,000 RPM、Launch 档 10,000 RPM、Grow 档 30,000 RPM。大多数应用升级层级、改用 Batch API 并做好缓存与限流后就够用;中转服务可以解决网络和付款问题,但不能承诺"不限并发"。下面给出官方限额、提高吞吐量的做法和代码。
在AI应用开发中,GPT-4o-mini凭借性价比被广泛使用。每百万输入token仅需0.15美元,比GPT-3.5 Turbo($0.50)便宜70%。当你准备将其应用到生产环境时,速率限制是必须提前规划的约束:无论是电商平台需要批量生成商品描述,还是智能客服系统需要同时处理数百个会话,亦或是研究机构需要分析海量文本数据,都要先算清所在层级的 RPM 和 TPM 够不够。
GPT-4o-mini API 官方速率限制:各层级 RPM 与 TPM
要提高吞吐量,首先需要理解限制的计算方式。OpenAI 的速率限制可以理解为令牌桶(Token Bucket):额度以恒定速率补充,每个API请求消耗一定额度;额度充足时可以短时间发送较多请求,耗尽后必须等待补充。根据OpenAI官方文档,速率限制按组织和项目计算,不按单个用户计算,并且会同时用 RPM、TPM 等多个指标衡量,先触到哪一个就先限流。
具体到数字上,截至 2026 年 10 月 8 日,gpt-4o-mini 模型页列出的限额如下:
| 层级 | 升级条件(累计充值) | RPM | TPM | Batch 队列上限 |
|---|---|---|---|---|
| Free | — | 不支持 | 不支持 | — |
| Build | $5 | 5,000 | 2,000,000 | 20,000,000 |
| Launch | $100 | 10,000 | 10,000,000 | 1,000,000,000 |
| Grow | $500 | 30,000 | 150,000,000 | 15,000,000,000 |
层级升级规则是公开的:只看组织的累计充值金额,达到门槛自动升级,没有等待天数要求。你的组织实际能用多少,以控制台 Settings > Organization > Limits 页面为准。
即使是付费用户,在请求集中突发时也可能遇到 429 速率限制错误。计算方法很简单:需要处理的请求数 ÷ RPM = 最少需要的分钟数。例如 5,000 个请求在 Build 档(5,000 RPM)理论上 1 分钟可以发完,但如果每个请求消耗 1,000 token,就需要 5,000,000 TPM,超过了 Build 档的 2,000,000 TPM,实际要分 3 分钟左右发送。所以规划时要同时算 RPM 和 TPM。
GPT-4o-mini 并发限制对业务的影响
限制的影响取决于任务量。以每天需要生成10万条商品描述的电商平台为例:在 Grow 档(30,000 RPM),只看请求数大约 4 分钟可以发完;若每条消耗 1,000 token,就需要 1 亿 token,按 150,000,000 TPM 计算也在 1 分钟的额度之内。真正容易出问题的是低层级账户和突发高峰:Build 档同样的任务受 2,000,000 TPM 限制,至少需要 50 分钟。
成本方面,GPT-4o-mini 的单价很低。以月处理1000万token(600 万输入、400 万输出)为例,官方标准价约为 600 万 × $0.15/百万 + 400 万 × $0.60/百万 = $0.90 + $2.40 = $3.30。对大多数应用来说,限制吞吐量的是速率限制,而不是费用。
响应速度直接影响用户体验。对实时交互类应用,应优先保证排队时间可控:设置并发上限、为 429 预留重试和降级路径,而不是一次把所有请求同时发出去。
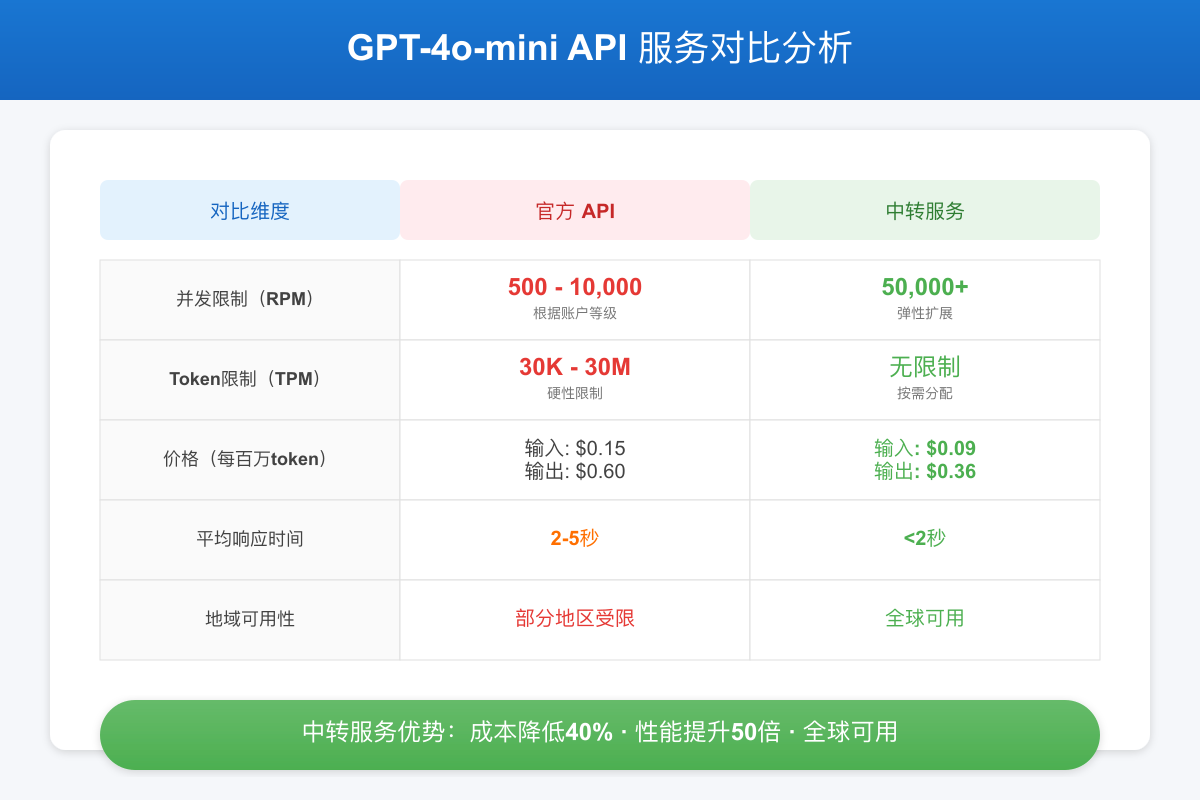
提高 GPT-4o-mini 并发的三种方案对比
面对限制,开发者通常有三种选择,每种方案都有其适用场景和权衡。
第一种是在官方API基础上进行优化:升级账户层级(累计充值 $500 即进入 Grow 档)、对不需要即时返回的任务改用 Batch API(不占用同步请求的速率限制,Grow 档 gpt-4o-mini 的 Batch 队列上限为 150 亿 token)、实施请求队列管理和结果缓存。这是最稳妥的方案,实现也相对简单,只需要在应用层添加一个中间件。
第二种方案是使用API中转服务。用户只需要修改API endpoint,就能通过中转服务调用模型。它主要解决国内网络和付款问题;并发能力取决于服务商自身的上游额度和限流策略,接入前要向服务商确认限额并做压测,不要把"不限并发"当作承诺。
第三种是用多个账号轮换来叠加限额。OpenAI 的使用条款不允许规避速率限制,这种做法有账号被封禁的风险,也难以运维,不建议采用。确实需要超过 Grow 档的稳定容量时,企业客户可以联系 OpenAI 销售了解 Scale Tier 等预留容量方案。
综合对比来看,优先用官方的层级升级、Batch API 和缓存解决吞吐量问题;国内网络或付款受限时,再叠加中转服务。
API 中转服务的典型架构
下面以常见的中转服务架构为例,说明请求经过了哪些环节,便于你评估服务商。
用户请求首先到达API网关层,这里进行身份认证、请求验证和协议转换。网关采用高性能的异步框架,能够同时处理数万个并发连接。每个请求都会被打上唯一标识,用于后续的追踪和审计。
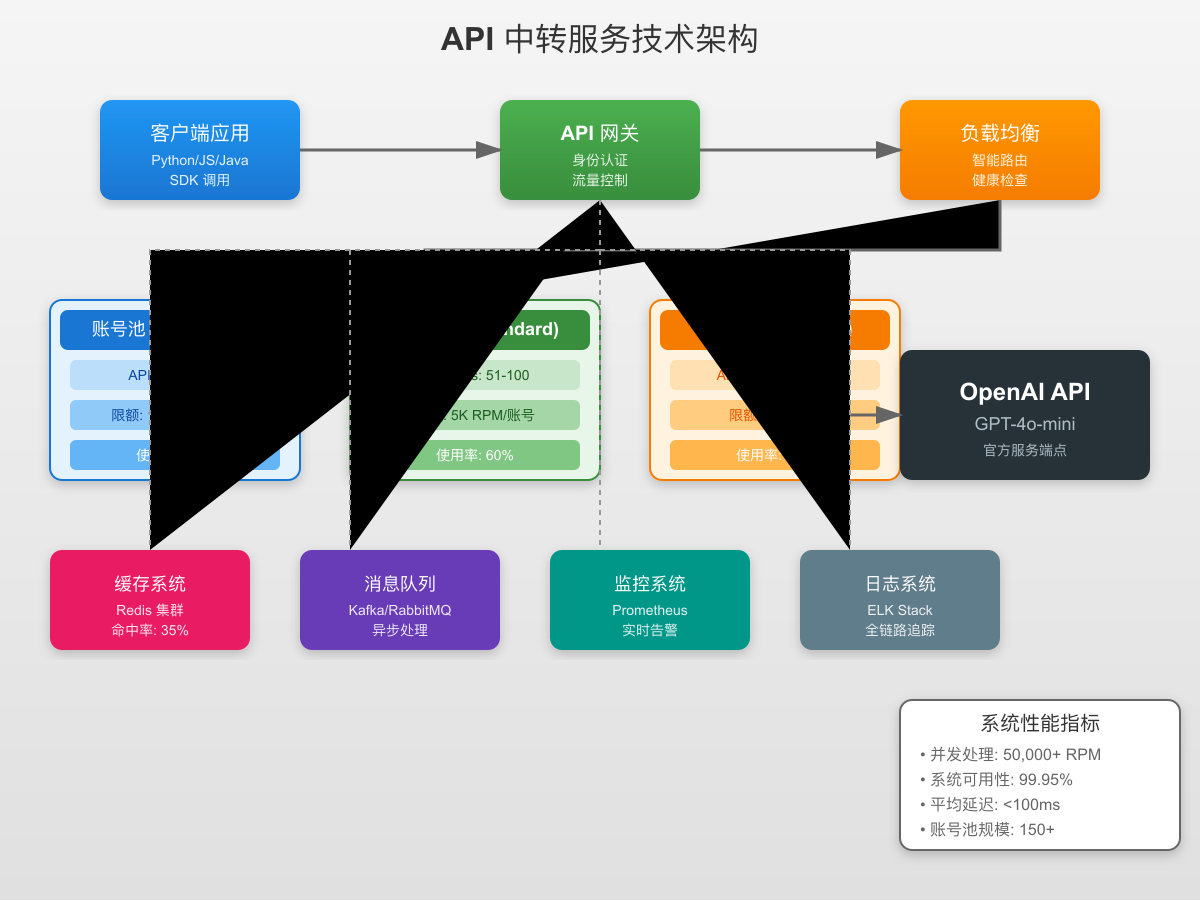
负载均衡层负责把请求分配到服务商的上游通道,并在某个通道响应变慢或出错时切换到其他通道。它能改善稳定性,但不会让总吞吐量超过服务商实际拥有的上游额度。
上游接入层负责把请求转发给模型厂商。服务商的上游额度、分组方式和限流策略决定了你能拿到的实际并发,这部分对用户不可见,所以要以压测结果和服务协议为准。
中间件层提供了额外的性能优化。智能缓存系统可以识别相似请求,直接返回缓存结果,减少实际API调用。消息队列确保请求不会丢失,即使在系统重启时也能恢复处理。监控系统实时跟踪各项指标,一旦发现异常立即触发告警和自动恢复机制。
5分钟快速接入教程
接入API中转服务的过程出人意料地简单。这里以Python为例,展示完整的接入流程。
首先,你需要在中转服务平台注册账号。大多数平台都提供免费试用额度,足够你进行充分的测试。注册后你会获得一个API密钥,这是你访问服务的凭证。
接下来修改你的代码。如果你使用的是OpenAI官方SDK,只需要修改一个参数:
from openai import OpenAI

# 原始方式 - 使用官方API
# client = OpenAI(api_key="sk-xxxxxxxxxxxxxx")

# 中转方式 - 仅需修改base_url
client = OpenAI(
    api_key="sk-xxxxxxxxxxxxxx",  # 你的中转服务API密钥
    base_url="https://api.example.com/v1"  # 中转服务endpoint
)

# 使用方式完全相同
response = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[
        {"role": "user", "content": "解释什么是量子计算"}
    ],
    temperature=0.7,
    max_tokens=500
)

print(response.choices[0].message.content)
对于需要批量处理的场景,可以使用异步并发:
import asyncio
from openai import AsyncOpenAI

client = AsyncOpenAI(
    api_key="sk-xxxxxxxxxxxxxx",
    base_url="https://api.example.com/v1"
)

async def process_batch(prompts):
    tasks = []
    for prompt in prompts:
        task = client.chat.completions.create(
            model="gpt-4o-mini",
            messages=[{"role": "user", "content": prompt}]
        )
        tasks.append(task)

    # 并发执行所有请求
    responses = await asyncio.gather(*tasks)
    return [r.choices[0].message.content for r in responses]

# 使用示例
prompts = ["问题1", "问题2", "问题3", ...]  # 可以是数百个
results = asyncio.run(process_batch(prompts))
配置优化方面,建议设置合理的超时时间和重试策略:
import httpx

client = OpenAI(
    api_key="sk-xxxxxxxxxxxxxx",
    base_url="https://api.example.com/v1",
    timeout=httpx.Timeout(60.0, read=30.0, write=10.0),
    max_retries=3
)
测试验证是关键的一步。你可以通过并发测试来验证性能提升:
import time
import concurrent.futures

def test_single_request():
    start = time.time()
    response = client.chat.completions.create(
        model="gpt-4o-mini",
        messages=[{"role": "user", "content": "Hello"}]
    )
    return time.time() - start

# 并发测试
with concurrent.futures.ThreadPoolExecutor(max_workers=100) as executor:
    futures = [executor.submit(test_single_request) for _ in range(100)]
    results = [f.result() for f in futures]

print(f"100个并发请求完成,平均响应时间: {sum(results)/len(results):.2f}秒")
100 个请求远低于 Build 档 5,000 RPM 的限额,无论直连官方还是走中转,正常情况下都应在几秒内完成。压测时逐步提高并发数,记录出现 429 的临界点,那才是你实际可用的并发上限。
高级优化技巧:在限额内提高吞吐量
掌握基础用法后,一些高级技巧能够进一步提升性能和降低成本。
异步并发编程的精髓在于合理控制并发数。并发过高会集中触发 429,反而降低整体效率。并发数可以按"RPM ÷ 60 × 平均响应秒数"估算,再按压测结果调整:
import asyncio
from typing import List

class BatchProcessor:
    def __init__(self, client, max_concurrent=50):
        self.client = client
        self.semaphore = asyncio.Semaphore(max_concurrent)

    async def process_with_limit(self, prompt):
        async with self.semaphore:  # 限制并发数
            return await self.client.chat.completions.create(
                model="gpt-4o-mini",
                messages=[{"role": "user", "content": prompt}]
            )

    async def process_batch(self, prompts: List[str]):
        tasks = [self.process_with_limit(p) for p in prompts]
        return await asyncio.gather(*tasks, return_exceptions=True)
智能请求调度可以根据任务优先级和复杂度分配资源。简单的任务使用较少的token限制,复杂任务分配更多资源:
class PriorityQueue:
    def __init__(self):
        self.high_priority = asyncio.Queue()
        self.normal_priority = asyncio.Queue()
        self.low_priority = asyncio.Queue()

    async def put(self, item, priority="normal"):
        if priority == "high":
            await self.high_priority.put(item)
        elif priority == "low":
            await self.low_priority.put(item)
        else:
            await self.normal_priority.put(item)

    async def get(self):
        # 优先处理高优先级任务
        if not self.high_priority.empty():
            return await self.high_priority.get()
        elif not self.normal_priority.empty():
            return await self.normal_priority.get()
        else:
            return await self.low_priority.get()
缓存策略的优化可以显著降低API调用次数。对于相似的问题,可以使用语义相似度匹配:
import hashlib
from typing import Dict, Optional

class SemanticCache:
    def __init__(self, similarity_threshold=0.95):
        self.cache: Dict[str, str] = {}
        self.threshold = similarity_threshold

    def _generate_key(self, prompt: str) -> str:
        # 简化示例:实际应使用embedding相似度
        normalized = prompt.lower().strip()
        return hashlib.md5(normalized.encode()).hexdigest()

    def get(self, prompt: str) -> Optional[str]:
        key = self._generate_key(prompt)
        return self.cache.get(key)

    def set(self, prompt: str, response: str):
        key = self._generate_key(prompt)
        self.cache[key] = response
成本控制方面,可以实施分级处理策略。非关键请求使用较低的max_tokens限制,关键请求才使用完整配置:
def optimize_request_params(prompt_type):
    if prompt_type == "simple_query":
        return {"max_tokens": 100, "temperature": 0.3}
    elif prompt_type == "creative_writing":
        return {"max_tokens": 500, "temperature": 0.8}
    else:
        return {"max_tokens": 300, "temperature": 0.5}
提高吞吐量的三种典型做法
下面三种做法适用于不同类型的批量任务。
批量生成:模板复用加 Batch API。 商品描述这类任务可以先按类目归类,相似商品复用同一套提示词模板,减少每次请求的 token 数;不需要实时返回的部分提交到 Batch API,在 24 小时窗口内完成,不占用同步请求的速率限制。
实时客服:缓存加分级路由。 常见问题直接从缓存返回,复杂问题才调用API;用信号量控制同时发出的请求数,超出部分排队,并为 429 设置带退避的重试和降级回复。
海量文本分析:分片加去重。 把数据分片处理,相似文本只处理一次,每个请求合并多条短文本(例如每批 100 条)以提高每次请求的利用率;任务量很大时优先用 Batch API。
成本效益分析:投入产出比计算
数字最有说服力。让我们详细计算使用API中转服务的成本效益。
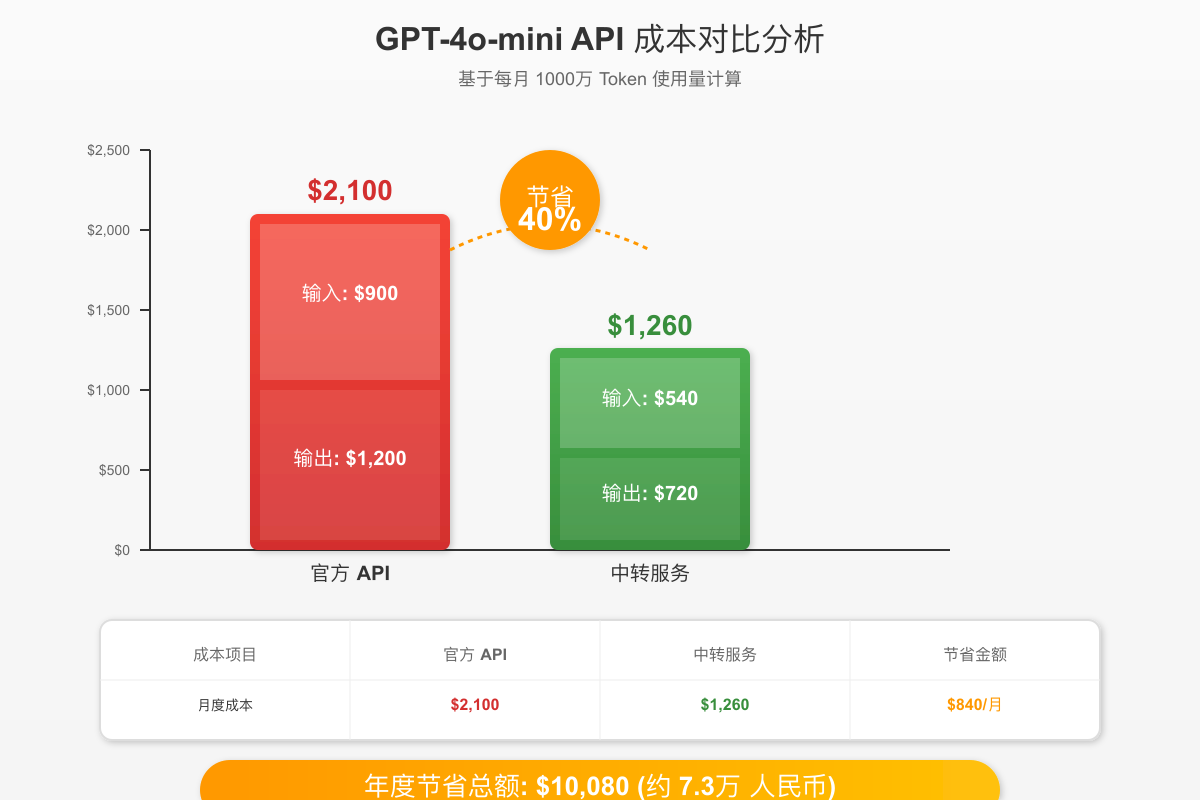
按官方标准价计算,月使用量1000万token(600 万输入、400 万输出)的成本是:输入 600 万 × $0.15/百万 = $0.90,输出 400 万 × $0.60/百万 = $2.40,月度总成本约 $3.30。用 Batch API 处理同样的量,价格更低(以价格页为准)。中转服务的价格以服务商控制台当日显示为准。
可以看出,对 gpt-4o-mini 来说,费用通常不是瓶颈,吞吐量才是。评估方案时,重点比较能否在业务高峰期稳定拿到所需的 RPM/TPM,以及出现限流时的恢复速度。
如果要计算投入产出比,可以用:(业务收益 − API 费用 − 维护成本) ÷ (API 费用 + 维护成本)。其中业务收益要用你自己的数据估算,不要套用别人的案例。
用量很大时,Batch API 和提示缓存是官方渠道里最直接的降本手段。
风险控制与合规建议
技术方案再好,也必须建立在合规和安全的基础上。
服务稳定性是首要考虑。选择中转服务商时,要重点考察其SLA承诺、历史可用性数据和故障恢复能力。建议采用多供应商策略,主服务商承担80%流量,备用服务商承担20%流量,确保在主服务商出现问题时能够快速切换。同时,在应用层面实施降级策略,当API服务完全不可用时,可以返回预设的默认响应或使用本地模型。
数据安全需要端到端的保护。确保所有API通信使用HTTPS加密,敏感数据在传输前进行脱敏处理。选择符合SOC2、ISO27001等安全认证的服务商。在应用层面,实施严格的访问控制和审计日志,所有API调用都应该可追溯。对于涉及用户隐私的数据,要确保符合GDPR、CCPA等隐私法规的要求。
合规使用方面,要注意 OpenAI 不向中国大陆提供服务,并且禁止规避速率限制;使用中转服务前,了解服务商的上游来源和数据处理方式。避免使用任何渠道进行违反OpenAI使用政策的活动,如生成有害内容、进行学术欺诈等。在商业使用时,确保有明确的服务协议和责任划分。
常见问题解答
在实际使用中,开发者最常遇到以下问题:
Q: 使用中转服务会影响响应速度吗? A: 中转会多一跳转发,延迟可能变高也可能因为网络线路更好而变低,取决于你的服务器位置和服务商线路。用自己的请求在目标地区测一段时间再决定。
Q: 如果中转服务商跑路了怎么办? A: 这确实是一个风险。建议选择运营时间超过1年、有真实公司背景的服务商。同时,保持代码的灵活性,能够快速切换到其他服务商或官方API。不要预付大额费用,采用按量付费模式。
Q: 模型更新时中转服务能及时跟进吗? A: 跟进速度因服务商而异。模型下线时同样要注意:例如 OpenAI 的 o4-mini、gpt-image-1 将于 2026 年 10 月 23 日停用,中转服务也会随之不可用。
Q: 如何选择合适的中转服务商? A: 重点考察以下指标:服务稳定性(历史可用率)、价格透明度、技术支持响应速度、API兼容性、付费方式灵活性。建议先使用免费额度进行测试,验证性能和稳定性后再正式使用。
总结与行动指南
GPT-4o-mini API的并发上限由账户层级决定,Grow 档已有 30,000 RPM、150,000,000 TPM。大多数应用通过升级层级、Batch API、缓存和并发控制就能满足需求;国内网络或付款受限时,再考虑中转服务,并以压测结果判断它能提供多少并发。
如果你正面临API限制的困扰,建议按以下步骤处理:第一步,在 Limits 页面确认所在层级和 gpt-4o-mini 的实际限额,算清峰值需要的 RPM 和 TPM;第二步,能异步处理的任务改用 Batch API,并加上缓存和并发控制;第三步,仍然不够时升级层级,或在测试后逐步引入中转服务,建议先迁移20%的流量,观察一周后再扩大。
技术的价值在于解决实际问题。把限额算清楚、让请求平稳地发出去,比追求"不限并发"更可靠。
最后更新:2026 年 10 月 8 日。限额与价格以 OpenAI 官方页面当日显示为准。