更新(2026 年 10 月 8 日): 2025 年时被称为"新一代"的 GPT-4.5、Claude 4 Opus、Gemini 2.0/2.5 等已不是各家当前的主力模型。截至 2026 年 10 月 8 日,OpenAI 主力 API 模型是 gpt-6-astra、gpt-6.1-sol、gpt-6-luna(OpenAI 价格页),xAI 推荐 Grok 4.7(xAI 模型页),Google 为新项目推荐 gemini-3.8-flash 或 gemini-3.5-flash-lite(Gemini API 弃用说明)。OpenAI 两款主力模型的价格算法,见 GPT-6 Luna 与 Sol 价格对比:API 和 Codex 分别怎么算。
在AI应用开发中,LLM API网关已经从一个可选工具变成很多生产应用的标准组件。模型更新越来越快,开发者要面对的问题是:如何在多家厂商的模型之间切换而不改业务代码?如何平衡成本与性能?某家 API 出故障时如何不让系统停摆?下面按这几个问题说明网关能做什么、主流方案怎么选,并给出可以直接改用的 Python 示例。
为什么LLM API网关成为开发必需品
直接调用单一厂商 API 的应用,通常会遇到三类问题:
- 可靠性:单一厂商限流、故障或模型下线时,业务直接受影响。比如 OpenAI 的
o4-mini、gpt-image-1将于 2026 年 10 月 23 日停用(OpenAI 弃用说明),把模型名写死在代码里的应用都要改。 - 成本:不同模型价格差距很大,同一个应用里的简单任务和复杂任务适合用不同价位的模型。
- 多模型管理:每家厂商的 SDK、计费、密钥和速率限制都不一样。
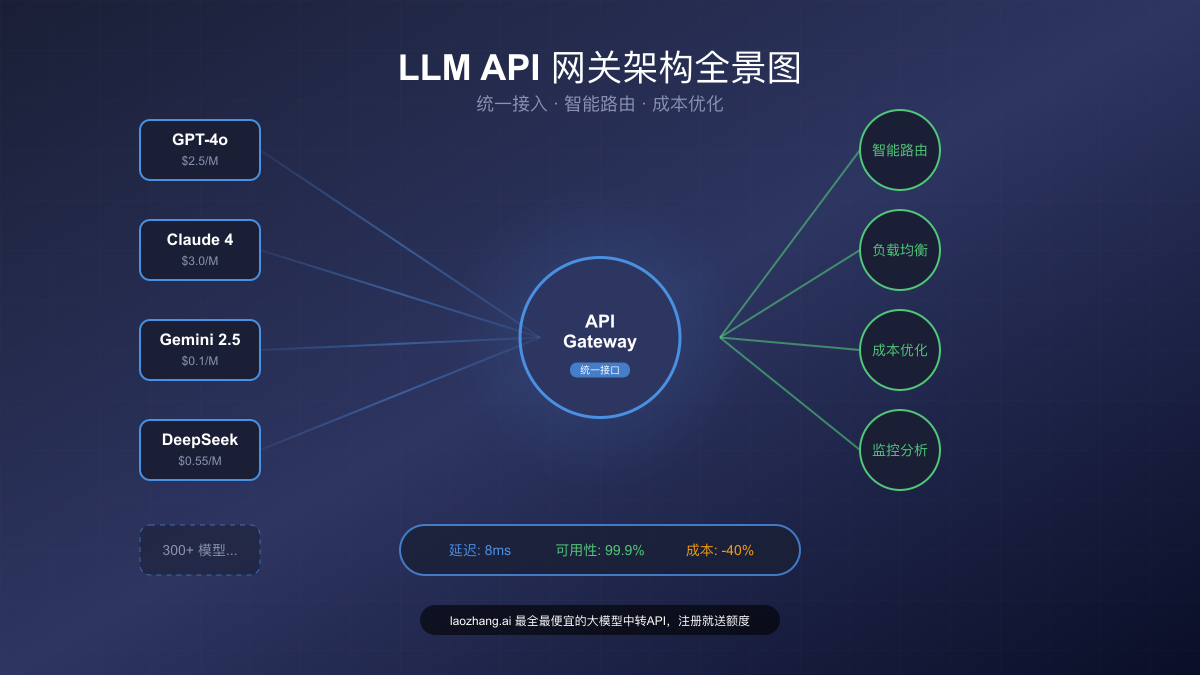
API 网关在应用和模型厂商之间加了一层统一接口,可以集中处理路由、故障切换、缓存、限流、密钥管理和成本统计。
LLM API 定价现状:截至 2026 年 10 月 8 日的官方价格
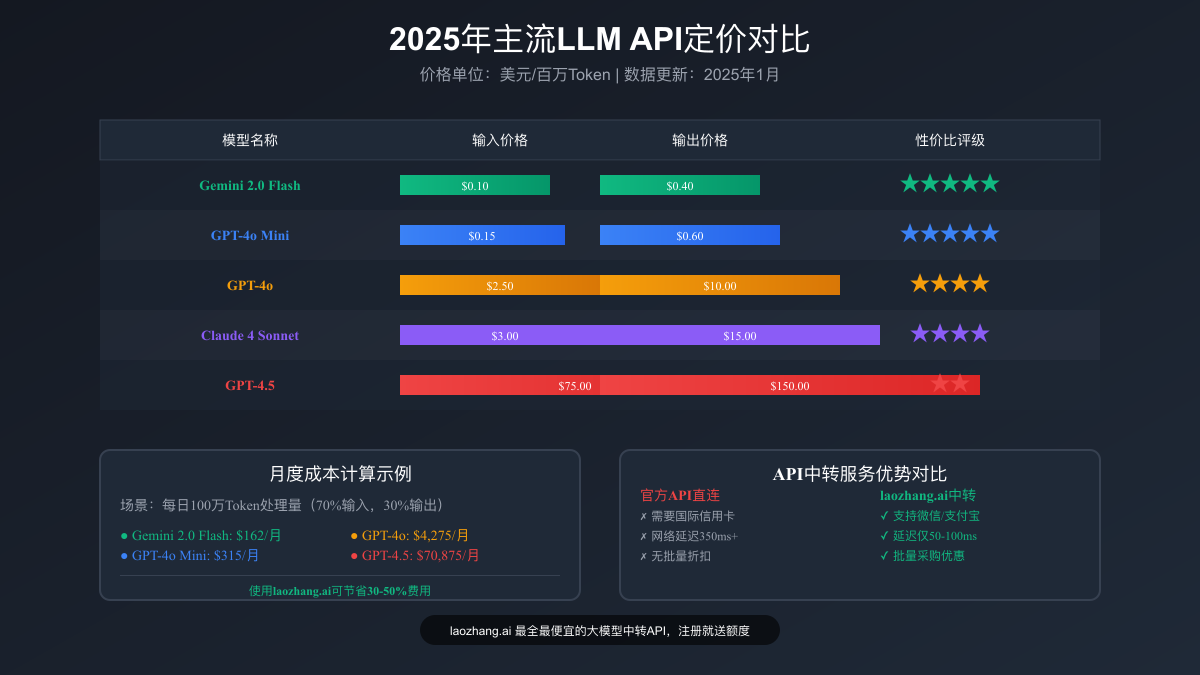
旗舰与低成本模型定价(每百万Token)
| 厂商 | 模型 | 输入 | 输出 | 来源 |
|---|---|---|---|---|
| OpenAI | gpt-6-astra(旗舰) | $10.00 | $50.00 | 价格页 |
| OpenAI | gpt-6.1-sol(均衡) | $2.00 | $10.00 | 价格页 |
| OpenAI | gpt-6-luna(低成本) | $0.10 | $0.50 | 价格页 |
| xAI | Grok 4.7 | $2.00 | $6.00 | 模型页 |
OpenAI 价格为 Standard 短上下文价;输入很长时进入长上下文档位,单价更高。Anthropic Claude 和 Google Gemini 的当前型号与价格,以 Anthropic 和 Google 的官方价格页当日显示为准。
同一档位的模型之间价格可以差 20 倍(gpt-6-luna 与 gpt-6.1-sol),这正是网关做"按任务分流"能省钱的原因。
中国开发者的特殊挑战与解决方案
对于中国开发者而言,直接访问这些API面临着独特的挑战:OpenAI API 和 Google Gemini API 的支持地区都不包括中国大陆,网络连接也不稳定;多数国际 API 服务不支持人民币结算或国内常用的支付方式。
这就是为什么兼容 OpenAI 接口格式的 API 中转服务在国内很常见。它们通常提供国内可访问的接入地址和国内付款方式。选择时要注意:中转服务的稳定性和数据处理方式由服务商自己负责,关键业务应保留直连官方的备用通道。
主流 LLM API 网关怎么选:按你缺的能力选
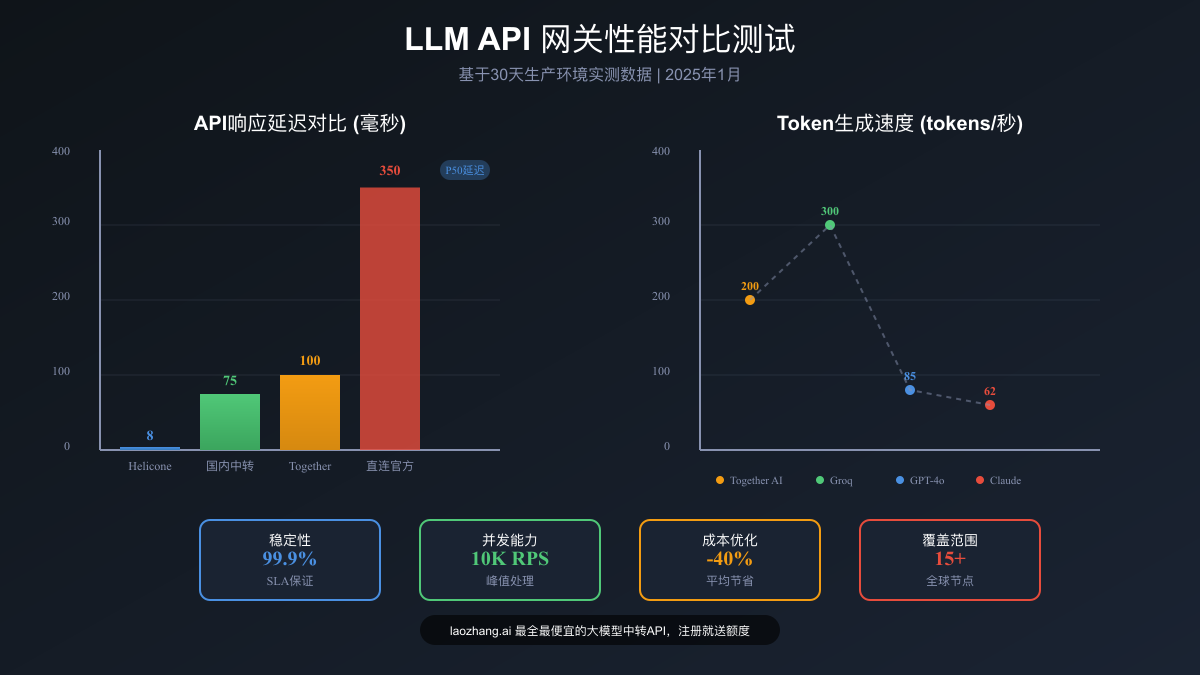
不同网关解决的问题不一样。先确定你最缺哪项能力,再选对应类型的方案:
| 你最需要的 | 方案类型 | 代表 | 说明 |
|---|---|---|---|
| 一个账号调用多家模型 | 模型聚合平台 | OpenRouter | 统一计费和接口,可按价格或可用性在多家供应商之间路由 |
| 企业治理、虚拟密钥、审计 | 网关中间件 | Portkey AI Gateway | 用 Virtual Key 给不同团队分配权限,不暴露真实密钥 |
| 用量观测与成本分析 | 观测平台 + 网关 | Helicone | 记录每次请求的延迟、token 和费用,便于找出高成本调用 |
| 托管开源模型 | 推理平台 | Together AI | 用 API 调用 Llama 等开源模型,无需自己部署 GPU |
| 国内网络与付款 | API 中转 | laozhang.ai 等 | 兼容 OpenAI 格式,支持国内付款方式 |
各平台的延迟、吞吐量和费率随版本和地区变化,上线前用自己的请求在目标地区测一遍,比参考任何一次性的跑分都可靠。
真实负载下要验证什么
把网关接入生产前,建议至少验证这几项:
- 故障切换:主模型返回 429、5xx 或超时时,是否按预期切到备用模型
- 成本统计:网关记录的 token 数和费用,与厂商账单是否对得上
- 缓存命中:相同请求是否命中缓存,缓存是否会返回过期内容
- 限流:网关自身的限流与厂商的速率限制叠加后,峰值吞吐够不够
LLM API 网关的典型用法
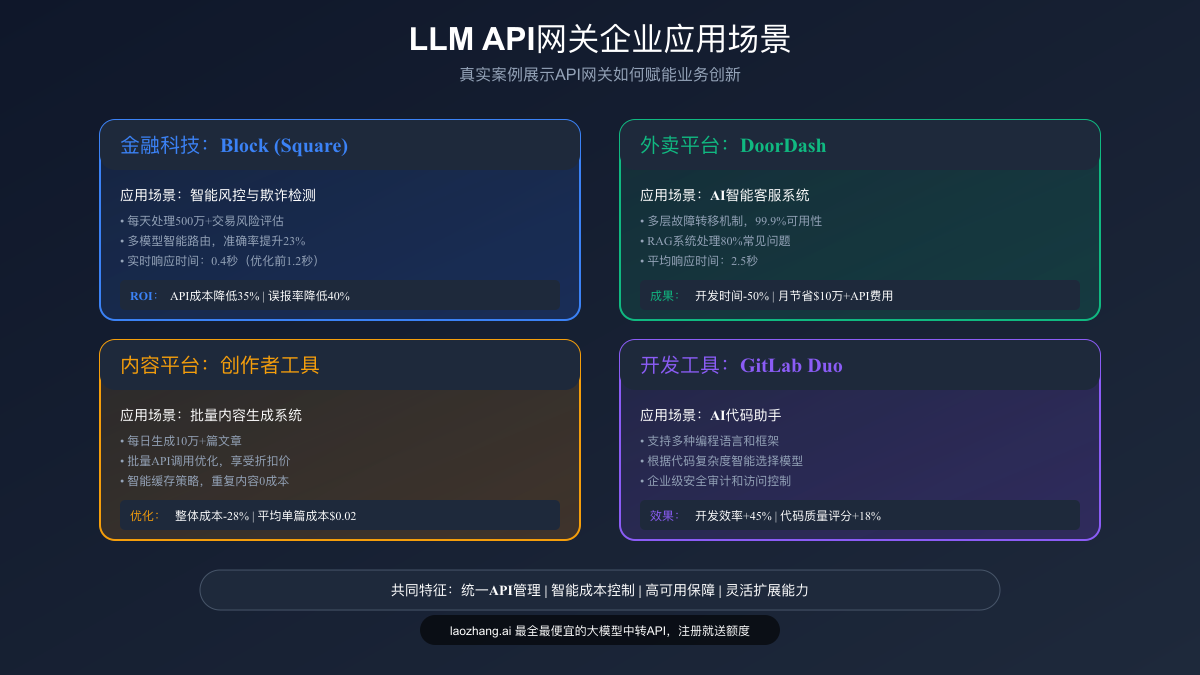
多层级故障转移
常见做法是设置一个主模型和一到两个备用模型:主模型延迟或错误率超过阈值时,自动切换到另一家厂商的同级模型;都不可用时,再降级到更便宜的模型或本地模型。这样即使某家厂商出故障,服务也不会完全中断。
检索增强生成与缓存
把常见问题的答案预先存进向量数据库或缓存,命中时直接返回,不必每次都调用 LLM。命中率越高,省下的 API 费用越多。
按任务分流
简单问答、分类、抽取交给 gpt-6-luna 这类低成本模型,复杂推理才交给 gpt-6.1-sol 或 gpt-6-astra。分流规则可以基于输入长度、任务类型或先用小模型判断难度。
中国开发者的做法
对于中国开发者,常见的是"国内中转 + 国际网关"的混合架构:用中转服务解决网络和支付问题,需要高级治理功能时再叠加国际网关。
laozhang.ai 是面向国内开发者的统一 API 中转服务之一,支持 OpenAI、Claude、Gemini 等厂商的模型,兼容 OpenAI 接口格式,支持国内付款方式。
实战代码示例:快速上手指南
下面的示例展示了如何通过统一API调用不同的模型。模型 ID 以你所用服务商控制台里实际可用的为准:
import requests
import json
import time

class LLMGateway:
    def __init__(self, api_key, base_url="https://api.laozhang.ai" ):
        self.api_key = api_key
        self.base_url = base_url
        self.headers = {
            "Content-Type": "application/json",
            "Authorization": f"Bearer {self.api_key}"
        }

    def chat_completion(self, model, messages, **kwargs):
        """
        统一的聊天接口,支持所有模型
        """
        payload = {
            "model": model,
            "messages": messages,
            **kwargs
        }

        try:
            response = requests.post(
                f"{self.base_url}/v1/chat/completions",
                headers=self.headers,
                json=payload,
                timeout=30
            )
            response.raise_for_status()
            return response.json()
        except requests.exceptions.RequestException as e:
            print(f"API调用失败: {e}")
            return None

    def smart_routing(self, messages, max_cost=0.1):
        """
        智能路由:根据任务复杂度选择最合适的模型
        """
        # 简单任务判断
        total_tokens = sum(len(m['content'].split()) for m in messages)

        if total_tokens < 100:
            # 简单任务使用便宜的模型
            model = "gpt-6-luna"
        elif total_tokens < 500:
            # 中等任务使用平衡的模型
            model = "gpt-6.1-sol"
        else:
            # 复杂任务使用高性能模型
            model = "gpt-6-astra"

        print(f"智能路由选择模型: {model}")
        return self.chat_completion(model, messages)

    def parallel_inference(self, messages, models=["gpt-6.1-sol", "grok-4.7"]):
        """
        并行推理:同时调用多个模型,选择最快的响应
        """
        import concurrent.futures

        def call_model(model):
            start_time = time.time()
            result = self.chat_completion(model, messages)
            elapsed = time.time() - start_time
            return model, result, elapsed

        with concurrent.futures.ThreadPoolExecutor(max_workers=len(models)) as executor:
            futures = [executor.submit(call_model, model) for model in models]

            # 获取第一个完成的结果
            for future in concurrent.futures.as_completed(futures):
                model, result, elapsed = future.result()
                print(f"模型 {model} 响应时间: {elapsed:.2f}秒")

                # 取消其他未完成的任务
                for f in futures:
                    f.cancel()

                return result

    def image_generation(self, prompt, model="gpt-image-2", quality="medium"):
        """
        图像生成示例(gpt-image-1 将于 2026-10-23 停用,示例改用 gpt-image-2)
        """
        payload = {
            "model": model,
            "messages": [
                {
                    "role": "user",
                    "content": [
                        {
                            "type": "text",
                            "text": prompt
                        }
                    ]
                }
            ],
            "n": 1,  # 生成数量
            "quality": quality  # low/medium/high/auto
        }

        return self.chat_completion(model, payload['messages'], n=payload['n'])

# 使用示例
if __name__ == "__main__":
    # 初始化网关(使用您的API密钥)
    gateway = LLMGateway(api_key="your-api-key-here")

    # 示例1:基础对话
    messages = [
        {"role": "system", "content": "你是一个专业的技术顾问"},
        {"role": "user", "content": "解释什么是LLM API网关"}
    ]

    response = gateway.chat_completion("gpt-6-luna", messages)
    if response:
        print("基础对话响应:", response['choices'][0]['message']['content'])

    # 示例2:智能路由
    complex_messages = [
        {"role": "user", "content": "请详细分析transformer架构的自注意力机制,包括数学推导"}
    ]

    smart_response = gateway.smart_routing(complex_messages)

    # 示例3:并行推理提高可用性
    parallel_response = gateway.parallel_inference(messages)

    # 示例4:图像生成(laozhang.ai 上 gpt-image-2 截至 2026-10-08 为 $0.03/次)
    image_response = gateway.image_generation(
        prompt="画一个现代化的API网关架构图,包含负载均衡和智能路由【16:9】",
        quality="high"
    )
成本优化实战技巧
在实际应用中,成本优化是一个持续的过程。以下是几种常用做法:
1. 实施智能缓存策略
import hashlib
import redis
import json

class CachedLLMGateway(LLMGateway):
    def __init__(self, api_key, redis_client=None):
        super().__init__(api_key)
        self.cache = redis_client or redis.Redis()
        self.cache_ttl = 3600  # 1小时缓存

    def _get_cache_key(self, model, messages):
        content = json.dumps({"model": model, "messages": messages}, sort_keys=True)
        return f"llm_cache:{hashlib.md5(content.encode()).hexdigest()}"

    def chat_completion_with_cache(self, model, messages, use_cache=True):
        if not use_cache:
            return self.chat_completion(model, messages)

        cache_key = self._get_cache_key(model, messages)

        # 尝试从缓存获取
        cached = self.cache.get(cache_key)
        if cached:
            print("缓存命中!")
            return json.loads(cached)

        # 缓存未命中,调用API
        response = self.chat_completion(model, messages)
        if response:
            self.cache.setex(cache_key, self.cache_ttl, json.dumps(response))

        return response
2. 批量处理优化
def batch_process_with_rate_limit(gateway, tasks, max_rpm=60):
    """
    批量处理任务,遵守速率限制
    """
    import time
    from collections import deque

    results = []
    request_times = deque()

    for task in tasks:
        # 速率限制检查
        current_time = time.time()
        request_times = deque([t for t in request_times if current_time - t < 60])

        if len(request_times) >= max_rpm:
            sleep_time = 60 - (current_time - request_times[0]) + 0.1
            print(f"达到速率限制,等待 {sleep_time:.1f} 秒")
            time.sleep(sleep_time)

        # 执行请求
        result = gateway.chat_completion(task['model'], task['messages'])
        results.append(result)
        request_times.append(time.time())

        # 可选:显示进度
        print(f"进度: {len(results)}/{len(tasks)}")

    return results
3. 模型下线前提前迁移
把模型 ID 放进配置文件而不是写死在代码里,并定期查看厂商的弃用页面。截至 2026 年 10 月 8 日,OpenAI 的 o1、o3-mini、o4-mini、gpt-image-1 将于 2026 年 10 月 23 日停用,o3、o3-pro 将于 2026 年 12 月 11 日停用。
LLM API 网关的演进方向
LLM API网关正朝着几个方向演进:
多模态统一:除了文本,越来越多的网关同时代理图像、音频和视频模型,用同一套密钥和计费管理。
成本预测与预算控制:基于历史使用数据,在请求执行前估算成本,并在接近预算时自动切换到更便宜的模型。
模型生命周期管理:厂商模型更新和下线越来越频繁,网关层统一做模型别名和迁移,能减少业务代码的改动。
实用工具推荐
为了帮助开发者更好地使用LLM API网关,下面几个工具可以参考:
LLM Price Calculator:比较多家模型的价格,支持自定义使用场景的成本预估。
Artificial Analysis Leaderboard:提供第三方的模型基准测试数据,包括延迟、吞吐量和质量指标。
Helicone Analytics:API使用分析平台,提供成本分解和请求日志。
对于国内开发者,也可以考虑 laozhang.ai:
- 多模型支持:GPT、Claude、Gemini 等厂商的模型,用一个兼容 OpenAI 格式的接口调用
- 价格:以控制台当日显示为准;截至 2026 年 10 月 8 日,gpt-image-2 为 $0.03/次
结语:按需求选网关,按官方价格算成本
LLM API网关已经从一个技术工具演变为AI应用的常用基础设施。选型时先确定你最缺的是多模型统一接入、企业治理、用量观测,还是国内网络与付款,再选对应类型的方案;成本按各家官方价格页计算,模型 ID 放进配置,留意厂商的弃用日期。