# Claude Haiku 5.5とGPT-6 Luna料金比較:10万トークン超で最大5倍
> Claude Haiku 5.5とGPT-6 LunaのAPI単価は同じでも、Haikuはプロンプト10万トークン超で全項目5倍。2026年10月8日時点の定価で請求額を試算します。
- Source: https://www.aifreeapi.com/ja/posts/claude-haiku-5-5-vs-gpt-6-luna
- Language: ja
- Published: 2026-10-08
- Updated: 2026-10-08
- Publisher: AI Free API (https://www.aifreeapi.com)
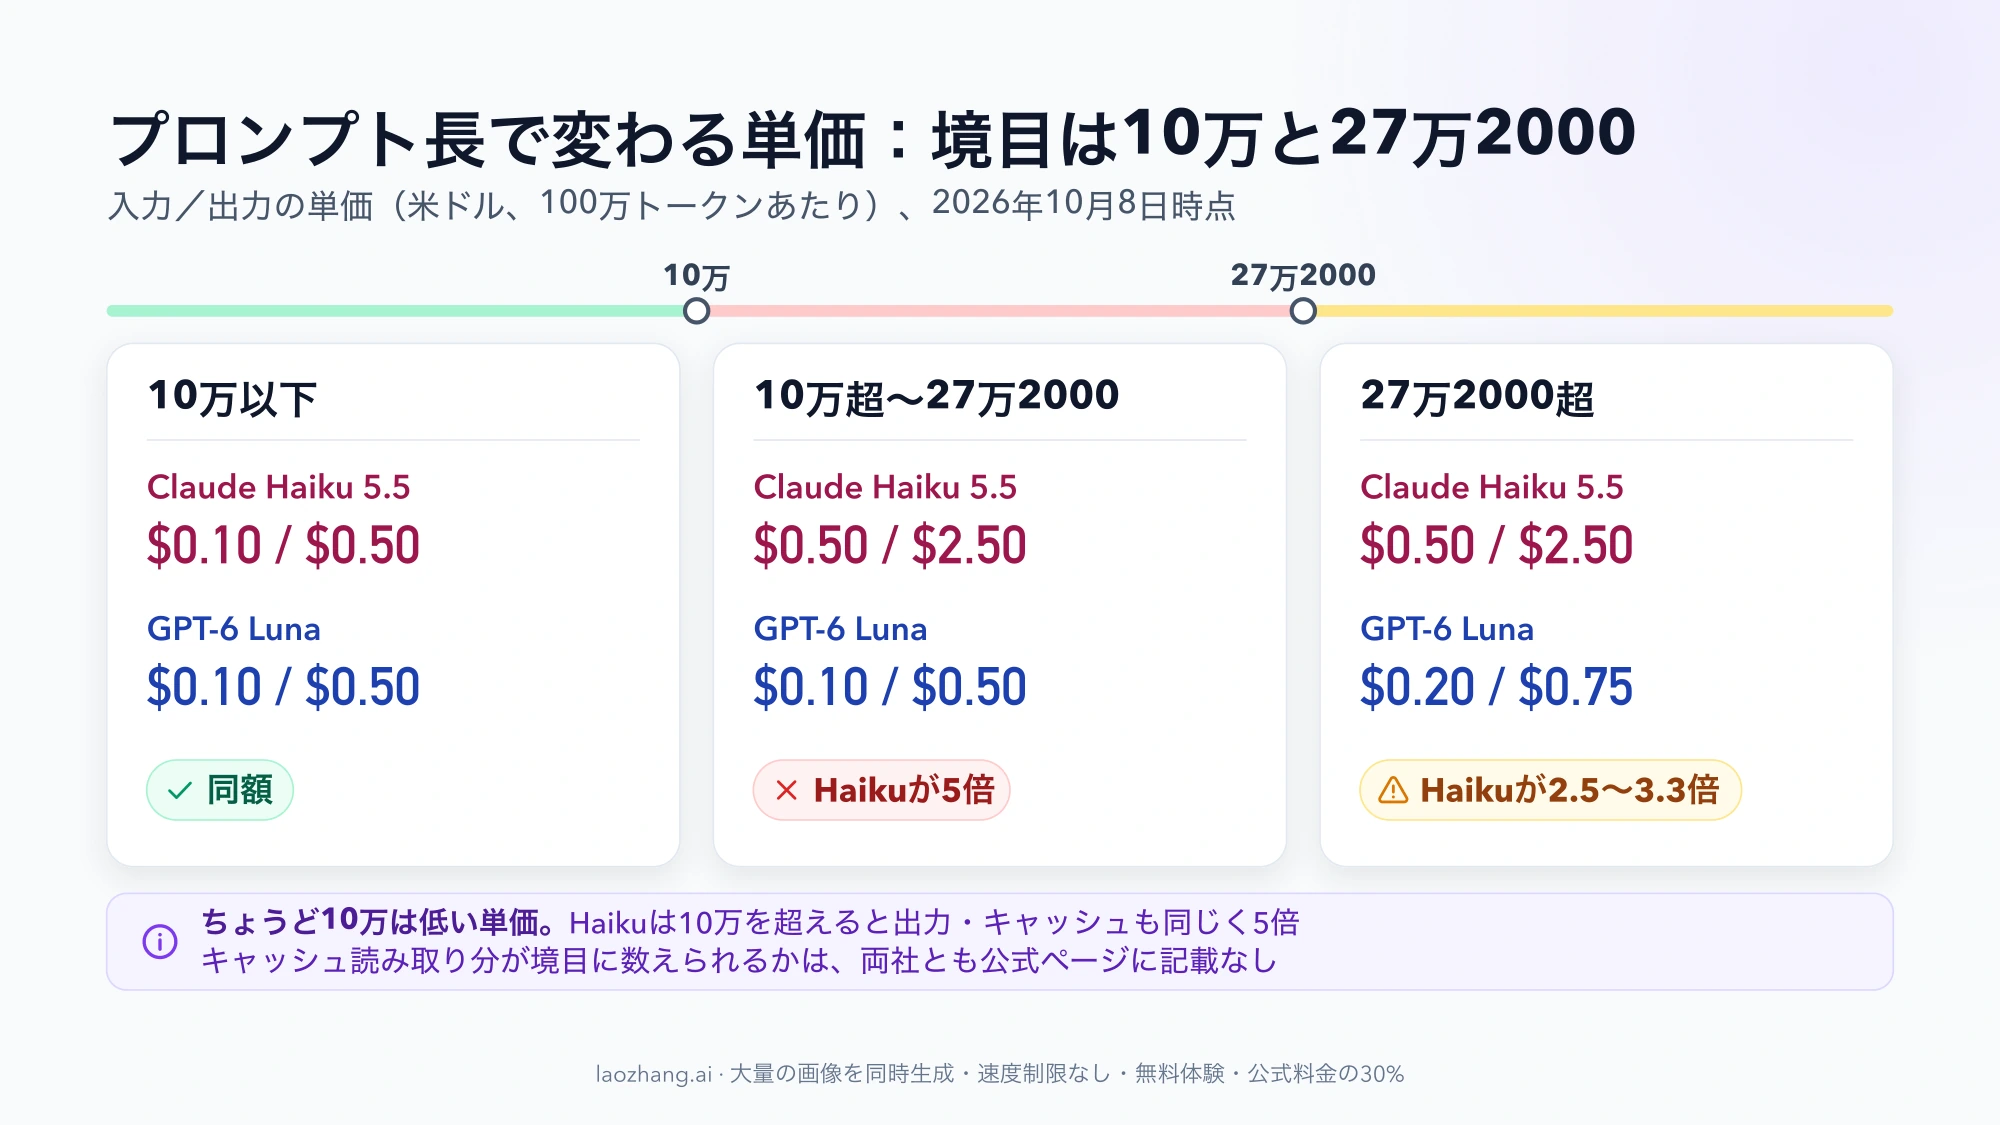
Claude Haiku 5.5とGPT-6 LunaのAPI基本料金は、2026年10月8日時点で同じです。100万トークンあたり入力$0.10、出力$0.50、キャッシュ読み取り$0.01、キャッシュ書き込み$0.125(Haikuは5分キャッシュの場合)。ただし、この同額が成り立つのはHaikuのプロンプトが10万トークン以下のときだけです。10万トークンを超えたリクエストではHaikuだけが入力・出力・キャッシュのすべてで5倍の単価になり、Lunaは入力27万2000トークンまで基本料金のままです([Anthropicの料金表](https://platform.claude.com/docs/en/about-claude/pricing)、[OpenAIの料金表](https://developers.openai.com/api/docs/pricing))。
ワークロード別に見ると、判断は次のように分かれます。
- **プロンプトが常に10万トークン以下**(分類、抽出、ルーティング、短いサポート返信):トークン単価は同額です。差は1件あたりの出力・思考トークンと品質で決まります。
- **10万〜27万2000トークンの長文書・RAG**:同じトークン数ならHaikuの請求額はLunaのちょうど5倍です。
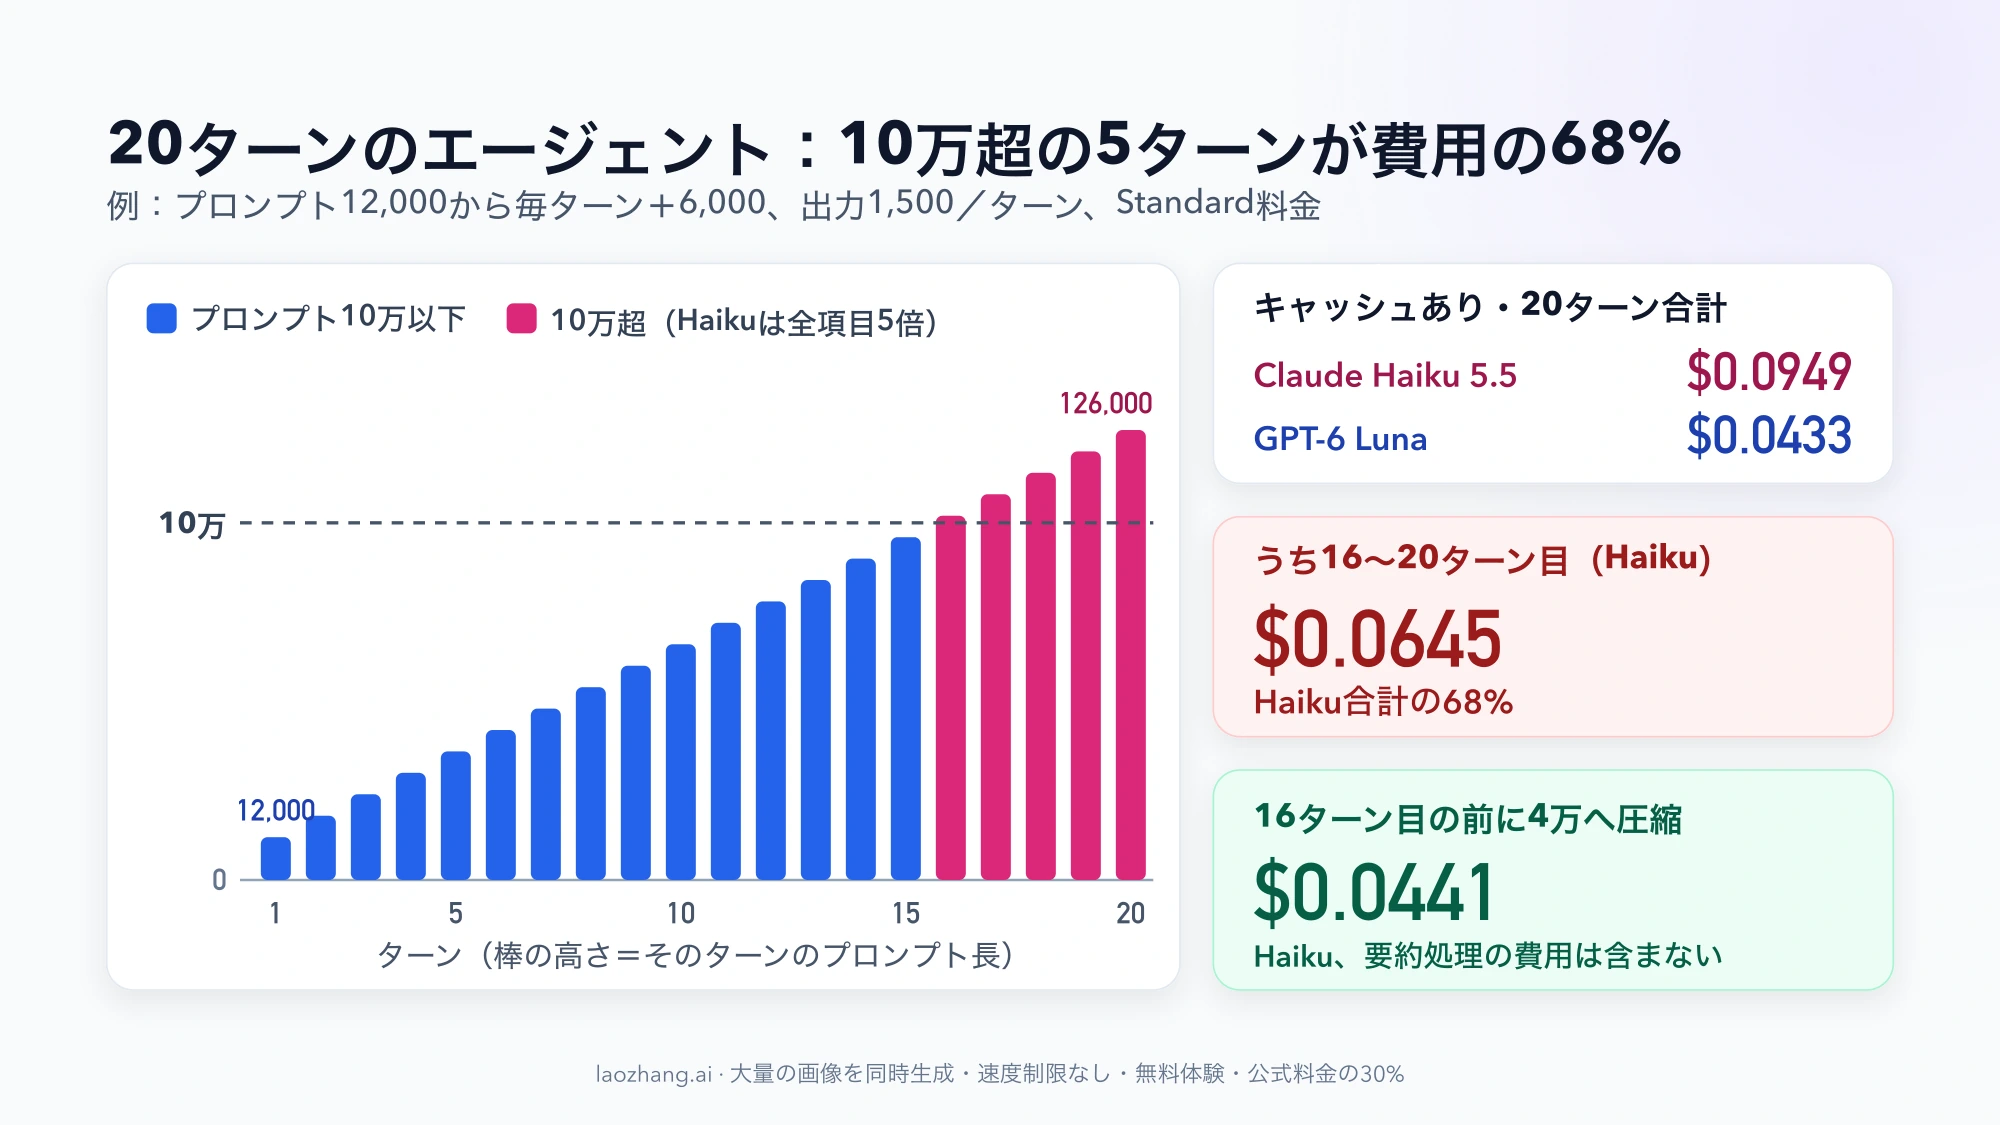
- **文脈が伸び続けるエージェント**:10万を超えたターンからHaikuが高くなります。下の20ターンの試算では、キャッシュを使ってもHaikuが約2.2倍になります。
- **同じ推論レベル名で同じタスク**:第三者評価ではHaikuのほうが出力トークンを多く使い、Medium同士のタスク単価は$0.05対$0.02です。ただしスコアもHaikuが高く、スコアが近い設定同士ならタスク単価の差は縮まります。
「単価が同じ」は「請求額が同じ」ではありません。自分のトラフィックでどちらが安いかは、プロンプト長の分布と1タスクあたりの出力トークンを測れば判断できます。その手順は後半にまとめています。
## Haiku 5.5とLunaのAPI単価:10万トークンまでは全項目同額
2026年10月8日時点の公式定価(Standard、米ドル、100万トークンあたり)です。Haikuは[Claude API](https://platform.claude.com/docs/en/models/haiku-5-5/overview)(`claude-haiku-5-5`)、Lunaは[OpenAI API](https://developers.openai.com/api/docs/models/gpt-6-luna)(`gpt-6-luna`)の直接利用の料金です。
| 課金項目 | Haiku 5.5
プロンプト10万以下 | Haiku 5.5
プロンプト10万超 | GPT-6 Luna
入力27万2000以下 | GPT-6 Luna
入力27万2000超 |
| --- | ---: | ---: | ---: | ---: |
| 入力 | $0.10 | $0.50 | $0.10 | $0.20 |
| キャッシュ読み取り | $0.01 | $0.05 | $0.01 | $0.02 |
| キャッシュ書き込み | $0.125(5分)
$0.20(1時間) | $0.625(5分)
$1.00(1時間) | $0.125 | $0.25 |
| 出力 | $0.50 | $2.50 | $0.50 | $0.75 |
表を読むときに押さえておきたい点は4つです。
1. **境目の数え方が違います。** Anthropicは「プロンプトの長さ」で料金を分け、10万トークンを超えたプロンプトに高単価を適用します。ちょうど10万トークンは低い方の料金です。OpenAIは「入力トークン」が27万2000を超えたリクエストについて、リクエスト全体に入力・キャッシュ2倍、出力1.5倍の単価を適用します。Claude側では、システムプロンプト、メッセージ、ツールの結果、画像、文書、ツール定義がすべて入力として数えられます([コンテキストウィンドウの説明](https://platform.claude.com/docs/en/build-with-claude/context-windows))。
2. **Haikuは出力も5倍になります。** 料金表の行がプロンプト長で区切られているため、10万トークンを超えたリクエストでは、出力と思考トークンにも$2.50が適用されます。
3. **キャッシュ分が境目に数えられるかは、どちらの公式ページにも記載がありません。** 以下の試算では、キャッシュから読んだトークンも含めてプロンプト長を数えています。請求額を少なく見積もらないための前提で、公式のルールではありません。
4. **割引と加算は両社で異なります。** Batchはどちらも50%引きです。LunaにはBatchと同額のFlexと、2倍料金のFastがあります。Haikuは米国内推論(`inference_geo: "us"`)を指定すると全項目1.1倍になり、Priority TierとFast modeは使えません。
Amazon BedrockやGoogle CloudでHaiku 5.5を使う場合は、それぞれのプラットフォームが独自の料金を設定しています。ここでの数字はAnthropicとOpenAIのAPIを直接使う場合に限ります。Lunaの27万2000トークンのルールやSolとの差は、[GPT-6 SolとLunaの料金比較:APIとCodexでどう違う?](/ja/posts/gpt-6-luna-vs-sol-price)でも扱っています。
## リクエスト規模別の請求額:10万トークンを超えた瞬間に5倍
1リクエストの費用は次の式で求められます。キャッシュとツールを使わない場合です。
> 費用 =(入力トークン × 入力単価 + 出力トークン × 出力単価)÷ 1,000,000
たとえば入力15万・出力2,000トークンなら、Haikuは(150,000 × $0.50 + 2,000 × $2.50)÷ 100万 = $0.080、Lunaは(150,000 × $0.10 + 2,000 × $0.50)÷ 100万 = $0.016です。同じトークン数を前提に、境目の両側で計算した結果が次の表です。
| 入力 + 出力(トークン) | Haiku 5.5 | GPT-6 Luna | 倍率 |
| --- | ---: | ---: | ---: |
| 2,000 + 200 | $0.0003 | $0.0003 | 同額 |
| 20,000 + 1,000 | $0.0025 | $0.0025 | 同額 |
| 100,000 + 2,000 | $0.011 | $0.011 | 同額 |
| 100,001 + 2,000 | $0.0550 | $0.0110 | 5倍 |
| 150,000 + 2,000 | $0.080 | $0.016 | 5倍 |
| 272,000 + 2,000 | $0.141 | $0.0282 | 5倍 |
| 300,000 + 5,000 | $0.1625 | $0.06375 | 2.55倍 |
| 150,000 + 2,000(Batch) | $0.040 | $0.008 | 5倍 |
入力2,000・出力200トークンの分類リクエストを100万回送ると、どちらも$300です。一方、プロンプトが10万から1トークン増えるだけで、Haikuの1回あたりの費用は$0.011から$0.055に跳ね上がります。10万超〜27万2000の区間では、Haikuの全項目がちょうど5倍でLunaは基本料金のままなので、倍率は出力の量にかかわらず5倍です。27万2000を超えるとLunaも高単価になり、倍率は入力・キャッシュで2.5倍、出力で約3.3倍に縮みます。
長いプロンプトをHaikuで扱う場合、検索結果の件数や添付文書を絞って10万トークン以下に収められるかどうかで、請求額が5分の1になるか5倍のままかが決まります。
## エージェントのマルチターン試算:キャッシュありでもHaikuは約2.2倍
ツールを呼びながら会話を続けるエージェントでは、ターンごとに文脈が伸び、途中で10万トークンを超えます。20ターン分の費用を、次の条件で計算します。
- 1ターン目のプロンプト12,000トークン、以降は毎ターン6,000トークンずつ増加(20ターン目は126,000)
- 出力は毎ターン1,500トークン、Standard料金
- 16〜20ターン目の5回が10万トークンを超える
- キャッシュありの場合は、前のターンまでの文脈をキャッシュから読み、増えた6,000トークンを5分キャッシュに書き込む
| 条件 | Haiku 5.5 | GPT-6 Luna | 倍率 |
| --- | ---: | ---: | ---: |
| キャッシュなし | $0.396 | $0.153 | 2.59倍 |
| キャッシュあり | $0.0949 | $0.0433 | 2.19倍 |
| キャッシュあり、16ターン目の前に文脈を4万トークンまで圧縮(Haikuのみ) | $0.0441 | — | — |
キャッシュありのHaiku $0.0949のうち、$0.0645(68%)は10万トークンを超えた最後の5ターンで発生しています。15ターン目までに文脈を要約して10万以下に戻せば、Haikuの費用はLunaとほぼ同じ水準まで下がります(圧縮のための要約処理そのものの費用は含めていません)。
この試算は両モデルのトークン数が同じという前提です。実際のHaiku 5.5は、次の節で説明するように過去の思考ブロックを既定で文脈に残すため、文脈はこの表より速く伸びる可能性があります。請求書の実額ではなく、境目がエージェントの費用にどう効くかを見るためのモデルとして使ってください。
## 同じ推論レベルでもHaikuのタスク単価は2.5〜4.4倍:第三者評価
トークン単価が同じでも、同じタスクに使うトークン数が違えば請求額は変わります。Artificial Analysisの評価(Intelligence Index v4.3.2、10種類の評価、Haiku 5.5公開の翌日時点)では、同じ推論レベル名で比べるとHaikuのほうが1タスクあたりの出力トークンがはるかに多くなっています([Medium同士](https://artificialanalysis.ai/models/comparisons/claude-haiku-5-5-medium-vs-gpt-6-luna-medium)、[High同士](https://artificialanalysis.ai/models/comparisons/claude-haiku-5-5-high-vs-gpt-6-luna-high)、[Low同士](https://artificialanalysis.ai/models/comparisons/claude-haiku-5-5-low-vs-gpt-6-luna-low)、[Max同士](https://artificialanalysis.ai/models/comparisons/claude-haiku-5-5-vs-gpt-6-luna)の比較ページ)。
| 推論レベル | 指数(Haiku/Luna) | 出力トークン/タスク | タスク単価 |
| --- | ---: | ---: | ---: |
| Low | 29/22 | 約17,000/約2,000 | $0.02/$0.0045 |
| Medium(両モデルの既定) | 34/30 | 約33,000/約11,000 | $0.05/$0.02 |
| High | 38/33 | 約55,000/約20,000 | $0.08/$0.03 |
| Max | 43/38 | — | $0.21/$0.07 |
Maxの行はAAの既定の比較ページから取った数値で、表の中では最も不確かで、今後改定される可能性があります。
レベル名をそろえるとHaikuは指数が4〜7ポイント高く、タスク単価は2.5〜4.4倍です。ただし、`effort`(Anthropic)と`reasoning effort`(OpenAI)は各社が独自に定めた段階で、同じ「Medium」でも作業量が同じという意味ではありません。指数が近い組み合わせで並べ直すと、見え方が変わります。
| 指数が近い組み合わせ | 指数 | タスク単価 |
| --- | ---: | ---: |
| Haiku Low/Luna Medium | 29/30 | $0.02/$0.02 |
| Haiku Medium/Luna High | 34/33 | $0.05/$0.03 |
| Haiku High/Luna Max | 38/38 | $0.08/$0.07 |
既定設定のまま比べるとLunaのほうが安く、Haikuの`effort`を1段下げて同程度のスコアで比べると差はほとんどなくなる、というのがこの評価から読み取れる傾向です。応答速度は設定によって逆転します。同じレベル名ではLow・High・MaxのいずれでもLunaのほうが最初のトークンまでの時間が短く(Low:Haiku 9.93秒、Luna 3.05秒)、一方で指数38同士ではHaiku Highが28.01秒、Luna Maxが111.31秒でした。
注意点もあります。評価機関1社の測定で、公開直後の値は改訂される可能性があります。AAの表ではHaikuのタスク単価に注記の印が付いており、評価には長文脈テストも含まれるため、一部のリクエストが10万トークンを超えて高単価になったかどうかは公開情報からは分かりません。Anthropic自身が公表したベンチマーク(Terminal-Bench 4.0でHaiku 5.5が39.2%、報道によるとLunaは16.4%)はメーカー公表値です。いずれも自分のタスクの合格率を測る際の目安として使ってください。
## 単価表に出ない差:トークナイザーとHaikuの思考ブロック
**同じ文章のトークン数は、モデルごとに数え直す必要があります。** Haiku 5.5はClaude 4.7以降と同じ新しいトークナイザーを使い、同じ文章がHaiku 4.5より約30%多く数えられます([Haiku 5.5の新機能](https://platform.claude.com/docs/en/models/haiku-5-5/whats-new-haiku-5-5))。Haiku 5.5とLunaで同じ文章が何トークンになるかを比べた公開データはありません。トークン単価が同じでも、どちらかが同じ文章を多めに数えれば、その分だけ請求額が増えます。
**思考トークンは出力として課金されます。** Haiku 5.5は適応型の思考(adaptive thinking)が既定で有効で、`effort`の既定は`medium`です。思考トークンは出力単価で課金され、`max_tokens`にも含まれます。さらにHaiku 5.5は、過去のターンの思考ブロックを既定で文脈に残し、残ったブロックは後続のリクエストで入力として課金されます([コンテキストウィンドウの説明](https://platform.claude.com/docs/en/build-with-claude/context-windows))。マルチターンでは文脈が伸びやすく、そのぶん早く10万トークンの境目に達します。
出力を抑える手段は両方にあります。
- **Haiku 5.5**:`effort`を`low`に下げる。`high`以下では`thinking: {"type": "disabled"}`で思考を無効にできます。Anthropicは品質と速度・費用の調整には`effort`を使うよう勧めています。
- **GPT-6 Luna**:`reasoning effort`は`none`、`low`、`medium`(既定)、`high`、`xhigh`、`max`から選べます。`none`が推論なしの設定です。
思考・推論トークンがusageのどの項目に出て、請求とどう対応するかは、[推論トークンを二重計上しない:Gemini・OpenAI・Claudeのusage検算](/ja/posts/reasoning-token-billing)で確認できます。
## どちらが安いか:ワークロード別の判定と結論を変える条件
| ワークロード | 同じトークン数での料金 | 結論を変える条件 |
| --- | --- | --- |
| 分類・抽出・ルーティング(プロンプト数千トークン、短い出力) | 同額 | 1件あたりの思考・推論トークン。Haikuは`effort`を下げるか思考を無効にして出力量をそろえる |
| 長文書・RAG(プロンプト10万〜27万2000) | Haikuが5倍 | 検索結果や添付を絞って10万以下に収められるか |
| 入力27万2000超 | Haikuが2.5〜3.3倍 | 入力を分割できるか |
| エージェント(ターンごとに文脈が伸びる) | 10万を超えたターンからHaikuが高い | 要約・圧縮で10万以下を保てるか、思考ブロックを残すか |
| 推論を使う品質重視のタスク | 同じレベル名ならLunaが安い(第三者評価) | 合格率が同じになる設定同士で比べると差が縮む |
まとめると、**プロンプトがほぼすべて10万トークン以下で、出力量も同程度に抑えられるならコストは互角**で、品質と速度で選んで構いません。**10万トークンを超えるリクエストが一定の割合で混ざるなら、Lunaのほうが安くなります。** 費用面でHaikuが並ぶか有利になりうるのは、Lunaでは高い推論レベルが必要な品質に、Haikuが低い`effort`で届く場合です。
Haikuでも品質が足りない場合の上位モデルは[Claude Opus 5.5の料金と使い方:Opus 5からの移行で確認すること](/ja/posts/claude-opus-5-5)、フラッグシップ同士の定価とタスク単価は[GPT-6.1 SolとOpus 5.5比較:定価2倍、タスク単価は6倍差](/ja/posts/gpt-6-1-sol-vs-claude-opus-5-5)にまとめています。
## 切り替え前に測る5項目:usageで請求額を確かめる
定価表だけでは決まらない部分は、実際のリクエストで測るのが確実です。次の順に進めると、どちらが安いかを自分のデータで判断できます。
1. **プロンプト長の分布を出す。** 本番に近いリクエストを集め、Haiku 5.5は`model`を`claude-haiku-5-5`にしてトークン数を数え直します(Haiku 4.5の数え方を流用しない、と[移行ガイド](https://platform.claude.com/docs/en/models/haiku-5-5/migration-guide)にあります)。Lunaは実リクエストのusageから入力トークンを取ります。10万超と27万2000超の割合が、5倍の単価がどれだけ効くかを決めます。
2. **1件あたりの出力トークンを設定ごとに記録する。** 同じタスクをHaikuの`effort` `low`/`medium`と思考無効、Lunaの`none`/`low`/`medium`で走らせ、思考・推論分を含む出力トークンを記録します。
3. **合格1件あたりの費用で比べる。** 出力を判定し、「総費用 ÷ 合格件数」で比べます。安い設定でも合格率が下がって再実行が増えれば、結論は逆転します。
4. **マルチターンでは各ターンのプロンプト長を追う。** Claudeでは`input_tokens`、`cache_read_input_tokens`、`cache_creation_input_tokens`の合計が10万を超えるターンを数え、思考ブロックで文脈が想定より伸びていないかを確認します。
5. **非同期で済む処理は割引を当てる。** 即時の応答が要らない処理は、両社のBatch(LunaはFlexも)で半額になります。Haikuの10万トークン超の高単価は、Batchでも5倍のままです。
この5項目を測れば、「自分のトラフィックなら〇〇のほうが安い。ただし××の場合は別」と根拠を持って言えるようになります。
## Haiku 5.5とGPT-6 Lunaの料金に関する質問
### Haiku 5.5はHaiku 4.5より本当に9割安いのですか?
単価だけを見れば、10万トークン以下では90%、10万超では50%安くなっています。Anthropicは、トークナイザーの変更を含めた平均では約75%の削減だと説明しています([発表](https://www.anthropic.com/claude-haiku-5-5))。例として、Haiku 4.5で10,000トークンだったプロンプトはHaiku 5.5で約13,000トークンになり、出力500トークンを加えた費用は$0.0125から$0.00155(約88%減)です。10万トークンの境目は、Haiku 4.5の数え方では約76,900トークンにあたります。Haiku 4.5は2026年10月8日時点でまだ提供中で、退役は2026年10月15日より前にはならないとされています([モデルの廃止予定](https://platform.claude.com/docs/en/about-claude/model-deprecations))。移行時は、`temperature`などのサンプリング設定の既定外の値やアシスタントのプリフィルがエラーになる点にも注意してください。
### 円ではいくらになりますか?
両社の公式料金表は米ドル建てで、円建ての公式価格は公開情報に記載がありません。円での支払額は為替レートと税の扱いで変わるため、ここでの比較はドル建ての定価で行っています。
### 日本からどちらのAPIも使えますか?
使えます。日本はAnthropic・OpenAIの両方でAPIの提供地域に含まれています。Claude APIのキー発行と課金の設定は、[Claude APIキーは買うもの?自分で発行して課金先まで確認する方法](/ja/posts/claude-api-purchasing-guide)で手順を確認できます。